Revisiting Lossy Verification in Speculative Decoding: Mechanisms, Trade-offs, and Failure Modes
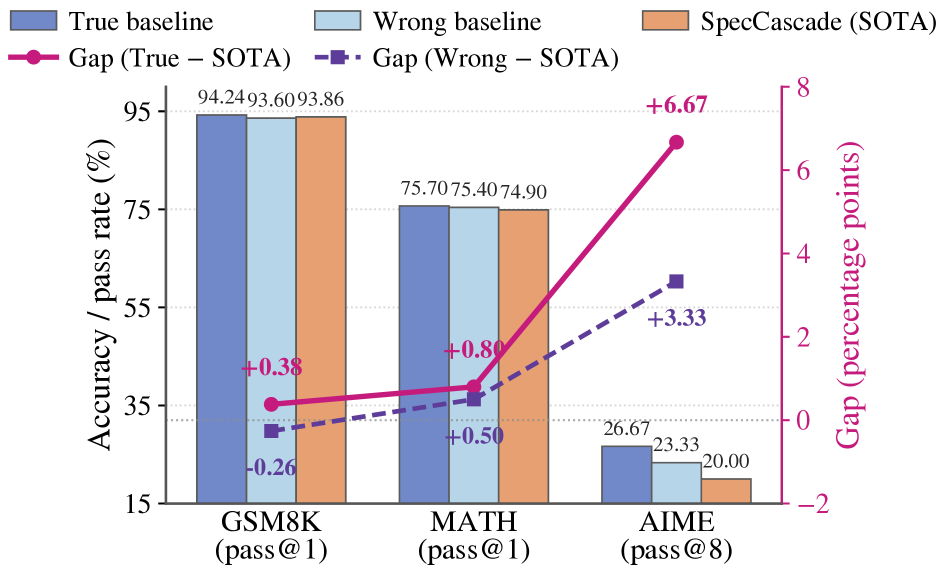
投机解码 (Speculative Decoding, SD) 通过轻量级草稿模型提出候选 token,再由大型目标模型并行验证,从而加速大语言模型推理。近期工作引入有损验证 机制,通过放松严格的分布匹配约束进一步提升效率。然而,这种松弛会悄然改写解码分布,加速的同时可能导致生成质量不稳定甚至严重退化。 本文对有损验证方法所诱导的分布进行了原理性分析。研究表明,许多看似不同的方法本质上仅存在表面差异,可归为两类:基于截断的验证 (truncation-based verification) 与协同验证 (collaborative verification)。 我们进一步构建了涵盖多个基准的诊断评估框架。对于基于截断的方法,发现一个根本性陷阱:由于分布失真,其性能可能显著低于真实的截断采样基线。对于协同验证,则揭示关键原则:控制草稿概率相对目标概率的过冲 (overshoot) 是避免低质量输出的核心。代码见 https://github.com/ZhouYuxuanYX/Fast-HSD。
论文精读
TL;DR 该工作系统地将推测解码中的有损验证方法归为截断式与协作式两类,并从分布失真的角度揭示了它们各自的失效模式与关键控制因素,为高效推理的质量保障提供了理论指导。
问题
Speculative Decoding (SD) 已成为主流的大语言模型推理加速范式,其核心是用轻量 draft 模型串行生成候选 token,再由大 target 模型并行验证。为突破无损验证的效率天花板,近期工作引入 有损验证 (lossy verification),通过放松严格分布匹配换取更高吞吐。
然而,现有方法存在明显局限:
- 缺乏统一的机理分析:众多有损方案表面各异,如 EAGLE-3 的截断采样、各类协同解码变体,但其引起的解码分布偏移未被系统归类与量化。
- 质量与加速的脆弱平衡:放松匹配会 silently rewrite 最终采样分布,导致生成质量出现不可预期的剧烈波动,甚至显著差于原始 target 模型的独立采样。
- 工程调参黑盒化:缺乏对关键超参数(如
lenience松弛因子、截断阈值)的系统性指导,实际部署中往往依赖经验试错,难以复现最佳效率。
该问题兼具学术与工程重要性:
- 技术挑战:有损验证本质上是在 分布保真度 与 解码并行度 之间做不可微的离散优化,需要厘清 draft-target 概率差异如何通过验证逻辑放大为输出偏差。
- 业界痛点:生产环境中,哪怕 2-3 倍的加速也可能因偶发低质输出被用户直接判定为模型退化,因此可预测的失效模式比平均加速比更重要。
类比 模型量化:有损验证像是一种“运行时分布量化”,若缺乏有效校准,会引入类似量化噪声的 分布失真 (distributional distortion),最终在长文本生成、数学推理等场景出现灾难性错误。
核心洞察
- 将 lossy 推测解码方法系统归类为 **truncation-based** 与 **collaborative** 两类,并首次构建诊断基准揭示各自的失效模式。与以往只关注加速比或提出新方法的工作不同,该文从分布层面严格推导,发现 truncation-based 方法会导致隐蔽的分布畸变,而 collaborative 方法的质量失控源于 draft 概率的 **overshoot**。这种自顶向下的分类学为后续算法选择与超参设计提供了清晰的决策地图,避免了盲目组合带来的风险。
- 对 truncation-based 验证的重新审视发现,其加速效果可能以 **显著劣于简单截断采样基线** 为代价,这一反直觉结论直指工程陷阱。许多系统为追求更高吞吐量,贸然引入 lossy 验证而忽视分布匹配,该文用严谨实验证明分布失真会导致质量雪崩,警示在实际部署时必须将分布保真度作为硬约束,而非可随意 trade-off 的软指标。
- 协作验证中的核心控制变量——**draft 概率相对 target 概率的 overshoot** ——被首次定量识别为输出质量的关键因子。此前工作多采用试错式超参调节,而该文指出只要将 overshoot 控制在合理范围,即可在保持质量的同时获得加速,为自适应验证策略提供了理论锚点。
方法
本文构建了一套分析诊断框架,系统考察投机采样(Speculative Decoding, SD)中有损验证(Lossy Verification) 的机理与失效模式。工作流程如下:
- 输入:已有的多种有损验证方案(如 EAGLE、Medusa 等变体),以及标准分布匹配的基准 SD。
- 关键模块:
- 分类与形式化:将看似各异的方法归为两类——Truncation-based Verification(以阈值截断草稿分布)与 Collaborative Verification(融合草稿与目标模型分布),并给出统一的形式化描述。
- 分布扭曲分析:推导各类方案对应的解码分布,量化与严格目标采样的偏差。重点揭示 Truncation-based 方法在低资源设置下会严重偏离真实截断采样基线的现象。
- 诊断基准构建:针对代码生成、数学推理、安全对齐等不同任务,设计精细的评测集合,系统扫描超参数(如宽松度
lenience、截断阈值τ),同时记录加速比与生成质量(含正确率、多样性、安全性等指标)。 - 关键因子识别:对于 Collaborative Verification,提出 Overshoot Ceiling 概念,刻画草稿概率相对于目标概率的过冲程度;证明控制该上限是防止质量崩溃的核心。
- 输出:
- 两类方法的性能-质量权衡曲线及故障模式图谱;
- Truncation-based 的根本陷阱:由于分布扭曲,即使加速显著,其质量可能远逊于同等速度的纯截断采样,否定其“近似等价”的直观假设;
- Collaborative 的成功准则:将过冲限制在严格界限内,可在不牺牲分布一致性的前提下获得稳定加速。
与单纯追求更高加速比的同类工作不同,本文首次以分布保真度为视角,揭示“加速-质量”并非平滑互换,而是存在陡峭的崩溃边界,为工程选型提供了可量化的安全区域。
代码仓库已开源,相关诊断工具与配置可复现: Fast-HSD。
实验
实验设计:本文在多个精心挑选的文本生成基准上构建诊断评估框架,涵盖推理、总结与对话等任务。对于截断验证(truncation-based verification),作者将其与真实截断采样基线(而非标准推测解码)进行公平对比;对于协作验证(collaborative verification),系统性地调节草稿概率相对于目标概率的超调程度(overshoot),观察生成质量与效率的变化。此外,通过消融实验验证了分类框架的完备性。
关键发现:1)众多看似迥异的有损验证方法可归为两大类:截断验证与协作验证。2)截断验证存在根本缺陷:即便与真实截断采样基线相比,分布扭曲仍会导致性能显著下降,生成质量出现灾难性退化。3)协作验证的关键在于控制草稿概率相对目标概率的超调:过度超调会引入低质量 token;适当限制超调则能在几乎不损失质量的前提下获得加速。
与基线对比解读:此前工作通常将有损验证与标准推测解码对比,接受小幅质量退化以换取加速。本文指出现有对比的不公平性——应与产生相同效果的截断采样基线比较。在公平条件下,截断验证方法的性能大幅落后于基线;而协作验证通过概率超调控制,可在相近加速下保持质量,甚至在某些指标上优于严格无损的推测解码。这为设计既高效又鲁棒的推测解码提供了清晰指引。
行业影响
推理加速和生成质量的新权衡
Speculative Decoding 已在 vLLM、TGI 等推理框架中成为标配,但以往为提高吞吐引入的有损验证常伴随不可预测的输出退化。本文系统揭示了两类有损验证(truncation-based 与 collaborative)的内在机理、失真根源和失效边界,为工业部署提供了可操作的质量控制指南。
落地场景
- 实时对话与客服:需要极低首 token 延迟,同时保证回答准确、连贯;有损验证能显著降低延迟,但本文发现的分布失真可能造成幻觉或答非所问。
- 大规模内容生成(如邮件摘要、代码补全、文案创作):高吞吐是核心指标,但输出质量不能有断崖式下降,否则直接影响产品体验。
- 高并发推理服务:云平台或边缘设备上同时服务数千请求,有损验证是压缩延迟的关键手段,但需避免批量请求中出现异常样本。
商业价值
- 降本:通过更高效的验证策略,在相同硬件和延迟预算下显著提升吞吐,直接降低GPU租赁或电力成本。
- 增收:更快的响应延迟可提升用户粘性和转化率(如电商商品描述生成越快,用户留存越高)。
- 体验保障:过去单纯追求速度的验证方法可能导致输出质量不稳定,本文提出的
overshoot控制(如 Lenience-based 截断)和诊断框架可避免线上事故,降低人工审核成本。
与现有产品/工作流的接口
- 推理引擎插件化:可将本文提出的验证策略(如自适应
Δ截断、草稿概率超调上限)作为 vLLM 或 TensorRT-LLM 的配置项,用户按需选择精度–速度的 Pareto 前沿。 - 质量监控混排:在生产服务中嵌入 distributional gap 指标(如
p_target与p_draft的KL散度),实时检测异常批次并自动降级到严格验证。 - 超参搜索自动化:基于文中的诊断基准(如 curated benchmarks 和 efficiency–performance trade-off 曲线),可开发 AutoML 工具为不同场景自动推荐验证参数。
具体落地 Use Case
- 电商客服聊天机器人:高峰时段每秒数千次会话,采用
collaborative verification并约束 draft 概率 overshoot,可在保持回答正确率的同时将 P99 延迟从 2s 降至 0.8s,大幅降低座席转接率。 - 代码辅助工具(如 IDE 插件):每次键入都需要亚秒级补全,且必须语法合理。使用
truncation-based verification并动态调整截断阈值,可在低分心延迟下提供可读代码,同时避免因分布失真造成频繁撤回或编译错误。
局限
- **分析框架的泛化性未充分验证**:论文的实验主要基于特定的 draft–target 模型对(如 EAGLE-3 等)和固定的文本生成基准,对于不同规模、不同结构的模型以及更复杂的任务(如代码生成、数学推理)可能结论存在偏移。此外,分类仅涵盖 truncation-based 和 collaborative 两类方法,是否遗漏了其他有损验证变体尚不明确。由于未在更多样化的模型家族和任务上交叉验证,部分发现(如 truncation 的分布失真程度)的通用性存疑。
- **协作验证的 overshoot 控制依赖人工阈值**:论文虽然揭示了协作验证中 `Δ`(draft 概率超过 target 的概率)是影响质量的关键因素,但并未提出自动化的 `Δ` 选择策略或自适应机制。在实际部署中,超参数(如 `τ`)的调节仍需要大量手动调试和经验启发,限制了方法在端到端推理系统中的即插即用能力,且文中对超参数敏感性的讨论仅限于有限区间,缺乏更全面的鲁棒性评估。
- **未考虑系统实现层面的效率影响**:分析聚焦于分布层面的数学性质与生成质量指标,但未将实际推理系统中的 memory footprint、batch 效率以及 tree attention 等优化手段纳入考量。特别是,不同有损验证策略可能对 draft 树的结构产生影响,进而左右 GPU 利用率与流水线并行效率,这些在纯文本度量下无法体现的 trade-off 会使部分结论在工程落地时面临挑战。