Parallel Decoding Distillation 用于快速图像与视频生成
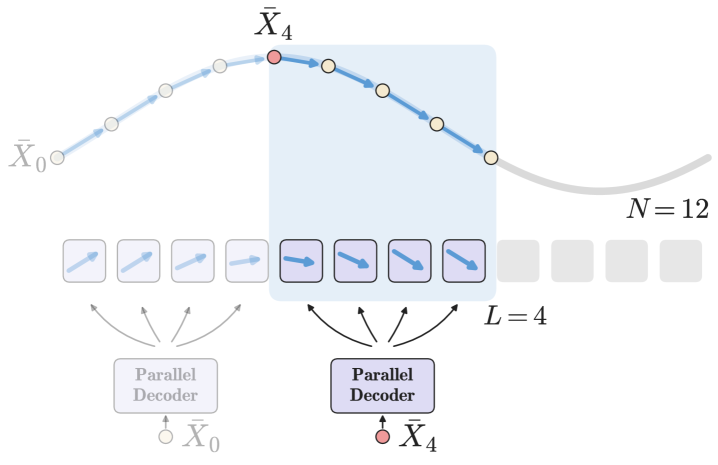
视频扩散或流模型的生成过程因迭代采样慢而计算昂贵。现有最先进的加速方法主要依赖变分分数蒸馏(VSD)和对抗损失来将扩散模型蒸馏为少步生成器。尽管实现了高质量视频生成,但这些训练损失难以优化且易出现模式崩塌,导致视频多样性损失和运动缺失。 本文提出并行解码蒸馏(PDD),一种简化的、可扩展的轨迹蒸馏方法,用于扩散和流匹配模型的快速推理。其架构和训练过程兼容任何预训练模型,并支持可变函数评估次数(NFE)的采样。PDD通过每次网络评估预测多个去噪步骤来加速生成。概念上,它学习平均速度的表示,而无需通过JVP或有限差分近似回归其导数。 在LTX-2.3 Text-to-Video/Audio、Wan 14B Text-to-Video和Qwen-Image Text-to-Image上,本方法在4-8 NFE下达到最先进性能。此外,PDD在生成视频多样性上取得显著提升。
论文精读
TL;DR PDD 通过单网络评估并行预测多步去噪,无需对抗训练或导数近似,训练稳定且保持生成多样性,在视频生成上以 4-8 步达到 SOTA。
问题
问题背景
当前,文本到图像/视频的扩散与流模型在生成质量上取得了显著进步,但其推理速度严重受限于数百次的迭代去噪过程。业界对实时或低延迟生成的需求日益迫切,加速推理成为关键瓶颈。
现有方法局限
主流加速手段分为基于分布匹配的蒸馏(如变分得分蒸馏 VSD 与对抗损失)和基于轨迹的蒸馏。前者虽能将生成步数降至个位数,却存在固有缺陷:
- 优化困难:VSD 需要交替训练生成器与判别器,对抗训练极易陷入不稳定,导致模式坍塌,输出多样性大幅下降,视频生成中尤为明显,常表现为运动僵化或纹理重复。
- 灵活性差:多数蒸馏方案将模型固化为单一 NFE,不支持动态调整计算预算。
- 轨迹蒸馏中一些方法依赖直接回归流场或其导数(通过 JVP 或有限差分),计算开销大且精度敏感。
为什么这个问题难且重要
视频生成的高维时空特性使得保真度与多样性之间的平衡极具挑战。蒸馏过程不仅要压缩去噪轨迹,还要维持长程时间一致性和丰富动态,同时避免陷入平均化模式。此外,实际部署需适应不同硬件资源,要求蒸馏器支持可变步数采样,这增加了方法设计的复杂度。业界高度关注,因为一旦实现低步数高质量生成,将使视频创作工具、交互式应用等场景真正落地,大幅降低计算成本。
行业类比
如同大语言模型通过推测解码实现加速,视频生成蒸馏是在“质量-速度”帕累托前沿上寻找最优解,尤其在创意工具中,快速预览与多样性同等重要。
核心洞察
- PDD 摒弃了 VSD 与对抗损失的复杂优化难题,提出一种**纯轨迹蒸馏的并行解码范式**。它不回归速度场的导数(如 JVP 或有限差分),而是直接学习一个表示“平均速度”的并行去噪模块,避免了模式坍塌与视频多样性丧失。相比需要精细调参的对抗蒸馏,PDD 仅需简单的回归损失,训练稳定性大幅提升,且与任意预训练模型兼容,工程落地门槛显著降低。
- PDD 支持**可变 NFE 采样**,单个蒸馏模型即可在推理时动态调整速度-质量权衡。不同于固定步数(如 4 步)的蒸馏方法需为每个步数配置独立模型,PDD 通过可配置的并行窗口大小,用同一权重实现 4~8 NFE 甚至更广范围的灵活生成,极大简化了部署管线,对需要自适应资源的云服务场景尤为实用。
- 该方法**完全基于预训练模型蒸馏**,无需从头训练生成器,且架构轻量(仅需插入可学习的并行解码层)。这使其可快速应用于各种规模的流匹配 / 扩散模型(如 Wan 14B、Qwen-Image),实现 SOTA 加速效果。对比 LoRA 等微调方案,PDD 在保持模型原始权重不变的同时,显著提升视频生成多样性,为大规模模型推理优化提供了新的基线思路。
方法
PDD 的核心思路是将扩散模型或流匹配模型的多步串行采样过程,转化为一个并行预测多个去噪步骤的蒸馏范式,从而在推理时大幅降低函数评估次数(NFE)。
输入与目标
给定一个预训练的生成模型(如 DiT 架构的文本到视频模型 Wan 14B 或 LTX-2.3),PDD 以其采样轨迹为监督信号,无需真实训练数据,仅利用教师模型生成的 noisy-to-clean 路径进行蒸馏。
关键模块:并行解码器与速度表示学习
- 并行解码器:将原始采样链划分为多个连续步骤的块(block),每个块内的若干步骤由一个网络前传并行预测,而非逐步串行执行。
- 平均速度表示:PDD 学习直接预测块内去噪过程的平均速度向量,避免了传统轨迹蒸馏中需要回归速度的导数(如通过雅可比向量积 JVP 或有限差分)的复杂操作。这一设计使得训练过程更稳定、更易优化。
- 层融合与流映射:在架构层面,PDD 可能将相邻步骤的线性变换融合为单一操作,进一步减少计算开销;同时其并行预测架构与连续归一化流(CNF)中“流映射”的组成性质存在理论联系,保证了蒸馏后模型的生成质量与原始模型的对齐。
训练技巧与变体
- 无数据训练:仅使用教师模型自身生成的样本,不依赖外部数据集,便于快速适配任意预训练模型。
- 可变块大小:通过在训练中随机化每个块所覆盖的步骤数,单一蒸馏模型可以灵活支持推理时使用不同的总 NFE(如 4、8 或更多),而无需重新训练。
输出与效果
蒸馏后模型可在 4~8 NFE 内生成高质量图像和视频,在 LTX-2.3 Text-to-Video/Audio、Wan 14B Text-to-Video、Qwen-Image Text-to-Image 等基准上达到最优,并且显著改善了生成视频的多样性,缓解了模式坍塌问题。
与同类方法的差异:相比依赖 VSD 或对抗损失的少步蒸馏(如 SDXL‑Turbo、Imagen Video),PDD 作为纯轨迹蒸馏方法,无需判别器或分数蒸馏,直接学习速度均值表示,训练更简单、可扩展性更强,且天然支持可变 NFE 采样。
实验
实验设计
PDD 在图像和视频生成任务上验证蒸馏效率,使用 4 种预训练模型:ImageNet 类别条件生成、Qwen-Image 文生图、Wan2.1 与 LTX-2.3 文生视频/音频。测试不同 NFE(4–8 步)下的生成质量与多样性,对比基线包括多步采样及 VSD/对抗蒸馏等加速方法。
关键发现
- 在极低 NFE(4–8)下,PDD 达到 SOTA 图像/视频生成质量,视觉保真度与基线多步采样相当。
- 视频多样性显著提升,缓解了 VSD/对抗训练常见的模式坍塌和运动缺失问题。
- 训练过程简化,无需 JVP 或有限差分近似,仅学习平均速度表示,收敛稳定。
- 方法对预训练模型架构无侵入,可无缝适配。
与基线对比
相较于 VSD 和 对抗蒸馏,PDD 避免引入判别器与复杂博弈训练,减少了模式坍塌风险。传统方法为榨取少数步的极致质量常牺牲多样性,而 PDD 通过并行解码预测多步位移,保留了扩散过程固有的随机性,生成样本变化更丰富。与需要计算高阶导数的轨迹蒸馏(如 BOOT)相比,PDD 计算代价更低且易扩展,无需精确回归速度导数。
行业影响
落地场景
PDD 大幅降低扩散/流模型推理成本,使实时或准实时的图像与视频生成从可能走向实用,可直接落地于:
- 短视频与社交媒体:创作者工具支持数秒内根据文本生成短视频剪辑,缩短素材制作周期。
- 个性化营销内容:广告平台根据用户画像实时合成定制化视频广告,提升点击率。
- 电商与商品展示:为商品详情页按需生成多角度展示视频或虚拟试穿效果,改善购物体验。
- 游戏与影视预览:加速资产管线,在运行时生成场景变体,或在前期预览动态效果。
商业价值
- 降本:从上百次网络评估降至 4–8 NFE,同等硬件下吞吐量提升数十倍,直接节省云 GPU 成本。
- 增收:内容生产效率跃升,支持自动化批量生成视频,解锁新的广告库存和电商转化场景。
- 体验提升:生成延迟进入秒级,使交互式应用(如 AI 相机、对话式生成)流畅可用,提高用户留存。
与现有产品/工作流的接口
PDD 设计为即插即用的蒸馏方法:
- 兼容任意预训练扩散/流模型,不改变原始架构,可直接通过加载蒸馏权重切换推理模式。
- 支持可变 NFE (number of function evaluations),可在部署时按延迟预算动态调整质量与速度。
- 无需复杂对抗训练或 VSD,训练稳定,便于与现有 training/inference pipeline 集成(如 Diffusers、ComfyUI 等框架)。
具体落地案例
- 电商短视频生成:某时尚品牌为每款商品基于文本描述自动生成 5 秒展示视频,用于商品详情页和社媒投放。传统方法需渲染农场数小时,采用 PDD 加速后可近乎实时生成,在促销高峰日批量产出数千条视频,显著提升转化率。
- 内容平台个性化推荐封面:短视频平台为用户实时合成个性化视频摘要,基于其兴趣标签在推荐流中动态拼接,PDD 使生成速度满足线上推荐系统的低时延要求,丰富内容池且提升点击。
局限
- **依赖于教师模型质量**:PDD 需要预训练的扩散或流模型作为教师,蒸馏过程直接使用教师模型的采样轨迹,因此学生模型的上限受限于教师模型的能力。若教师模型在某些数据分布上存在偏差或生成质量波动,这些缺陷会被蒸馏过程放大。此外,数据-free 训练虽然降低了数据收集成本,但也可能导致学生模型在分布外样本上的泛化能力不足,特别是当教师模型自身的分布覆盖不完整时。
- **低 NFE 场景的挑战**:论文重点展示了 4-8 NFE 下的 SOTA 性能,但对极端低步数(如 1-2 NFE)的生成效果未做充分探讨。并行解码器通过一次网络评估预测多个去噪步骤,但随着块大小增大,预测误差可能累积,导致运动一致性和细节丢失。在实际部署中,若追求极致推理速度,PDD 可能仍需额外策略来弥补极低步数下的质量下降,这一点论文未给出解决方案。