ExplainBench: Evaluating Code Explanations from Agents
大语言模型(LLM)智能体在软件工程领域已被快速采用。随着智能体在代码生成中扮演越来越重要的角色,它们所做出的改动也愈发庞大,动辄跨越数十至数百行代码。这使得人工审查智能体产出变得愈发不可行,开发者转而依赖解释来理解已实施的变更。然而,目前尚无基准来评估智能体生成解释的可信度。为填补这一空白,我们提出了 ExplainBench,一个自动评估编码智能体解释的基准。ExplainBench 基于如下直觉:信息充分的解释应能使 LLM 正确回答问题,从而在不同智能体之间对解释质量进行定量比较。基于此观察,我们构建了一系列问题,用于评估解释是否准确描述了(1)有缺陷代码的预期行为,以及(2)应用智能体补丁本身的效果。实验首先揭示了解释质量是智能体评估的一个独立维度:ExplainBench 对智能体的排名与广泛使用的 SWE-bench Verified 基准不同。对智能体解释质量的深入剖析显示,解释中频繁出现问题,例如解释往往宣称补丁正确而实际并非如此。基于这一见解,我们实现并评估了一个解释审计智能体,它通过运行额外测试来验证和精炼解释。该智能体改善了所有被评估智能体的解释,证明智能体解释可以被自动地提升可信度。
论文精读
TL;DR ExplainBench 用 LLM 答题正确率自动评估代码 AI 代理的解释质量,揭示解释可信度是独立于任务解决的维度,并提供审计代理提升解释可靠性。
问题
问题背景
当前软件工程领域正快速集成大语言模型(LLM)Agent,用于自动生成和维护代码(如修复 bug、实现功能)。由于 Agent 单次修改常跨越数十至数百行代码,人工审查其输出已不现实,开发者越来越依赖 Agent 提供的自然语言解释来理解变更。
现有方法局限
现有评估基准(如 SWE-bench Verified)仅关注 Agent 生成的补丁是否通过测试(即代码正确性),却忽略了解释本身的可信度。实践表明,Agent 的解释经常错误地声称补丁是正确的,且在解释质量维度上,不同 Agent 的排名与 SWE-bench 的结果显著不同。这说明解释质量是一个独立且缺乏评估的维度,开发者若轻信低质量的解释,可能引入隐蔽缺陷。
为什么这个问题难/重要
自动评估解释质量的核心挑战在于:解释是声明性知识,其正确性难以通过简单的关键词匹配或语法检查判定。ExplainBench 的直觉是,一个信息丰富的解释应能让另一个 LLM 正确回答关于代码意图和补丁效果的具体问题,因此可将其转化为问答任务进行量化评估。该问题的重要性源于工业界对 Agent 生成代码的信任需求——没有可靠的解释审计机制,LLM Agent 在关键系统中的应用将始终面临透明性和可追溯性瓶颈。
行业类比
在 AI 辅助代码审查中,这类似于医学影像 AI 的诊断解释评估——不仅要看诊断结果是否准确,更要验证解释文本是否与医学依据一致,否则临床信任无法建立。
核心洞察
- 现有的代码代理基准(如 SWE-bench Verified)仅评估补丁正确性,忽视了解释的可信度。ExplainBench 首次系统性地量化代理解释的质量:通过构造意图与效果两类问题,用 LLM 回答准确率作为代理解释的自动评估指标,揭示解释质量是独立于补丁正确性的评估维度,排名与 SWE-bench Verified 显著不同。
- 代理生成的解释常声称补丁正确,但实际存在错误,这种“过度自信”会误导开发者。基于此发现,论文提出解释审计代理,利用额外测试自动发现解释中的缺陷并修正,证明无需人工干预即可提升解释可信度,为构建更可靠的自动化代码审查工具提供了新思路。
方法
ExplainBench 的核心思路是将解释质量量化为 LLM 利用解释回答问题的能力,从而实现对 coding agent 解释的自动化评估。
输入与输出
- 输入:一个 coding agent 针对某个软件缺陷(来自 SWE-bench 等基准)生成的代码补丁(patch/diff) 和自然语言解释,以及对应的失败测试和代码库环境。
- 输出:解释的可信度分数,反映解释是否准确描述了代码行为与补丁效果。
关键模块:问题构建
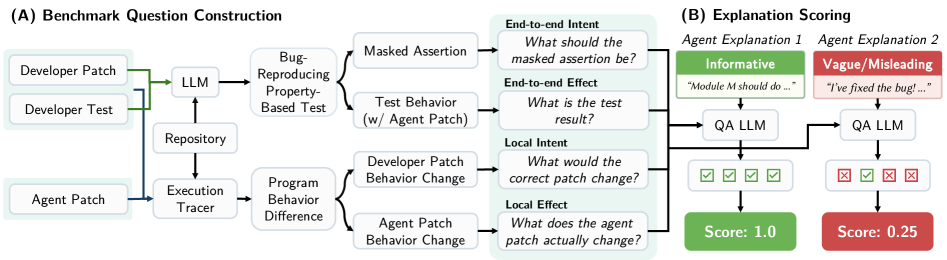
ExplainBench 通过自动生成一套问答对来评估解释,问题分为四类:
- 端到端意图(End-to-End Intent):考察解释是否准确指出了缺陷代码的预期行为。
- 端到端效果(End-to-End Effect):检验解释是否清楚说明了补丁如何改变了程序行为。
- 局部意图(Local Intent):聚焦代码片段,判断解释是否解释了特定变量或表达式的意图。
- 局部效果(Local Effect):关注补丁引入的具体代码变更,验证解释对修改后行为的描述是否正确。
问题构造流程结合了属性测试生成、执行轨迹分析和候选表达式采样:
- 利用 buggy 代码的执行轨迹提取行为变化(Delta Behavior),生成意图类问题。
- 通过基于属性的测试(property-based test)框架生成与补丁效果相关的断言,构造效果类问题。
- 所有候选问题经过质量保证(QA) 筛选,剔除模糊或无法验证的项。
评估指标
使用一个 LLM-as-a-Judge 流程:将 agent 的解释和对应问题输入给评估模型,让其回答这些问题,再与正确答案对比。分数越高,说明解释越能帮助理解代码行为。
解释审计(Auditing)
ExplainBench 还包含一个解释审计 agent,它通过运行额外的测试(例如覆盖率引导的模糊测试)来验证解释中的论断,并自动修正不可信的解释,从而提升解释质量。
与同类方法的差异
与 SWE-bench 等只关注补丁正确性的基准不同,ExplainBench 首次将 agent 生成的解释作为独立评估维度,揭示了“代码修复正确”与“解释可信”之间并不等价,鼓励 agent 开发者重视可解释性。
实验
实验设计
ExplainBench 基于 SWE-bench Verified 的任务实例,从多个 coding agents(如 GPT-4、Claude 等)生成的补丁及配套解释中,自动构建评估问题集。问题分为端到端(End-to-End)和局部(Local)两类,分别考察解释是否准确描述代码原始意图和补丁效果。评估采用 LLM 作为评判器(LLM-as-Judge):向 LLM 提供解释并要求回答相关问题(如“补丁是否修复了 XXX?”),通过属性测试(Property-based Test)自动化验证答案的正确性,计算解释质量分数。
关键发现
- 解释质量是独立维度:ExplainBench 对 agents 的排名与 SWE-bench Verified(关注补丁正确性)的排名显著不同,表明能修好 bug 的 agent 不一定能给出可信的解释。
- 解释常见问题:深入分析发现,很多解释 错误地断言补丁正确(尽管实际未通过测试),或忽略关键行为变化。
- 自动审计有效:提出的 explanation audit agent 通过生成并运行额外测试来验证解释,对所有评估 agents 的解释均有改进,证明自动化解释可信度提升可行。
对比解读
相较于 SWE-bench 仅使用通过/失败测试衡量补丁,ExplainBench 将评估延伸至认知辅助层——解释是否能帮助开发者理解变更。这揭示了 agent 在“做对事”和“说清事”上的能力差异。值得注意的是,部分 agent 在代码修复上表现优异但解释质量低,说明单纯追求高修复率可能掩盖沟通缺陷。Audit agent 的改进效果表明,解释可信度可通过测试验证循环有效提升,这为构建更可靠的 AI 编程助手提供了新路径。
行业影响
落地场景
ExplainBench 可直接嵌入软件开发与运维工作流,用于自动化评估 LLM 编码代理 所生成解释的可信度。适应性场景包括:
- 代码托管平台(如 GitHub、GitLab):在 Pull Request 中自动标注代理生成的代码解释是否可靠,辅助人工审查。
- CI/CD 管道:作为质量关卡,在部署前验证自动修复或重构的解释与预期行为一致,拦截虚假说明。
- IDE 插件:实时提示开发者当前 AI 建议的解释质量,减少对错误信息的依赖。
商业价值
- 降本:削减手动检查自动生成代码和解释的时间,避免因误解补丁意图而引入的后续缺陷。
- 增收:提升 AI 辅助编程工具的输出可信度,加速企业采购与采用,直接提高开发吞吐量。
- 体验提升:增强开发者对代理解释的信任,降低认知负荷,使审查过程更流畅。
与现有产品/工作流的接口
ExplainBench 以基准测试框架形式提供,可集成方式包括:
- CI 集成:在流水线中添加
explainbench步骤,对每个代理提交自动评分并生成报告。 - 代码审查 Hook:通过 Webhook 监听 PR,对含解释的变更运行问题集,返回评分与问题摘要。
- 审计 Agent 联动:利用论文中的 explanation audit agent 自动运行额外测试来精炼解释,可与现有测试套件组合使用。
具体落地 Use Case
- 电商平台微服务故障自愈:运维团队利用 AI 代理自动修复生产缺陷,代理输出补丁和自然语言解释。ExplainBench 自动验证这些解释是否正确描述了补丁的实际效果,在部署前过滤解释与行为不符的修复,避免错误上线导致交易损失。
- 自动驾驶仿真代码审计:感知或规划模块的代码由代理生成并附带解释。ExplainBench 检查解释是否准确反映代码的预期行为,结合动态仿真测试,快速定位解释与实现不一致的部分,减少安全审查的人力投入。
局限
- 评估依赖 LLM-as-Judge,可能引入模型内部偏好或幻觉,导致解释质量分数偏向于特定表达风格而非事实准确性;自动化问题生成虽然可扩展,但其覆盖的错误类型和解释维度有限,部分问题可能过于简单或包含噪音,尚需人工抽检确保评估效度。
- ExplainBench 基于 SWE-bench 实例构建,数据集和任务类型继承其局限,无法评估 Agent 在非补丁类任务或全新代码库中的解释能力;审计 Agent 的改进效果仅在当前基准内验证,缺乏跨项目或线下人工评估的交叉印证,真实开发流程中的泛化性存疑。
- 论文未探讨解释可信度与开发者实际信任度、补丁接受率的因果关系,缺乏用户研究或工业部署证据,因此提出的指标在衡量实际工程价值时存在断层,可能高估或低估解释对人决策的影响。