SGTP: 基于采样的博弈论规划用于实时多车自动驾驶赛车
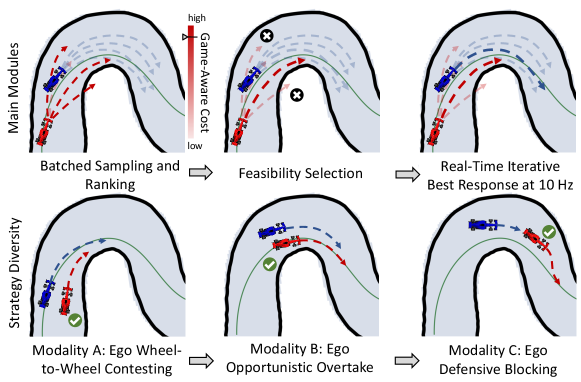
多车自动驾驶赛车要求在激烈交互中实时规划多样化的竞争行为,而现有规划器往往难以兼顾策略多样性与计算效率。 针对这一挑战,我们提出 SGTP 框架,将博弈论推理与 GPU 加速的控制序列采样和动力学 rollout 相结合。采样轨迹通过博弈感知成本进行排序,以捕获竞争性交互并生成多样化的赛车行为。随后,规划器通过显式施加赛道边界约束和动态碰撞避免约束进行可行性筛选,确保赛车策略之间的安全、可靠切换。 在极具挑战性的赛道上进行的大量仿真表明,SGTP 在高度交互的比赛中取得了 95.24% 的胜率和 99.35% 的任务完成率,且多次迭代求解的平均计算时间仅为 0.095 秒。我们还成功将 SGTP 应用于多达 10 个智能体的大规模场景。我们已公开代码,并提供多智能体自动驾驶赛车算法的开源基准,以促进未来研究。项目主页:https://sgtp-racing.github.io/。
论文精读
TL;DR SGTP 结合博弈论成本函数与 GPU 加速采样,在实时多车自动驾驶竞赛中同时生成多种竞技策略,实现 95% 胜率与毫秒级规划延迟。
问题
问题背景
自主多车竞速 (multi-vehicle autonomous racing) 正成为移动机器人与智能车领域的前沿试验场,其核心需求是在激烈交互中实时规划出兼具攻击与防守的多样化行为,类似于 F1 赛车中持续发生的轮对轮对抗。
现有方法的局限
当前规划器通常难以兼顾策略多样性与计算效率:
- 基于优化的方法(如模型预测控制)求解非线性博弈的计算负担沉重,难以在 100 ms 级周期内完成迭代;
- 端到端学习 泛化到新赛道或未知对手时可靠性不足,且缺乏可解释的安全约束;
- 经典博弈论方法 依赖强假设或离线计算纳什均衡,实时性差,行为模式单一。 综上,多数方案要么只能生成有限的行为原语(如单纯超车或守线),要么因计算延迟导致碰撞率高,无法持续进行高强度的攻防转换。
技术挑战与重要性
自主竞速的难点在于:
- 高动态交互:车速高、间距小,必须同时考虑赛道约束与多车碰撞风险;
- 实时性要求严苛:规划器须在 0.1 s 内输出可行轨迹,否则将失去对战机会;
- 策略多样性:赛车手需要根据领先后方状态主动切换
防守、进攻、跟随等模式,这要求同一算法能自然涌现不同行为。 该问题关乎多智能体在共享动态环境中的快速决策能力,对自动驾驶、无人机竞速、仓储机器人调度均有辐射影响,业界对可解释、可验证的实时博弈规划框架需求强烈。
行业关联
可以类比云游戏中的多玩家物理仿真:每局游戏需在毫秒级延迟内,为所有角色计算出既符合物理规律又体现战术意图的控制序列,SGTP 所解决的恰恰是这类多智能体实时交互的底层规划难题。
核心洞察
- - 博弈论推理与采样规划的结合,解决了竞速策略多样性与实时性的冲突。传统方法要么基于预设规则缺乏灵活性,要么依赖复杂博弈求解难以实时响应。SGTP利用GPU大规模并行采样控制序列并前向模拟动力学,以博弈感知成本高效评价,在平均0.095秒内完成多轮迭代,能产生进攻、防守、阻断等多样化行为,胜率达95.24%。这种将博弈论价值融入采样评分的框架,为强交互场景的实时规划提供了新范式。
- - 精心设计的博弈感知成本函数,编码了竞速对抗的核心维度。该成本由四个子项组成:状态维持成本鼓励跟跑与压制、纵向优势成本衡量超越机会、阻挠对齐成本评估防守站位、安全成本避免碰撞。这种显式建模使轨迹排序不仅依据进度,更能反映竞争关系,赋予采样以博弈智能。相比基于简化目标或单一距离的成本,它能生成更丰富且合理的交互行为,是实现多策略无缝切换的关键。
方法
输入
- 多车辆状态:包括自车与对手的位置、速度、朝向、赛道几何信息。
- 赛道参考线:中心线或最优路径,用于构建竞争状态指标。
- 控制采样空间:预设的加速度和转向角离散集合,经动力学模型生成候选轨迹。
关键模块
1. GPU 加速的轨迹采样与动力学 Rollouts
在 GPU 上并行采样大量控制序列,通过单轨动力学模型(包含 Pacejka 轮胎模型)前向传播,生成有限时域的预测轨迹。每个候选轨迹携带状态序列和完成时间。
2. 博弈感知成本排序 (Game-Aware Cost)
为捕捉多车交互中的竞争策略,设计四项可微分成本:
Contest-State Maintenance Cost:衡量与最近对手的横向间隙,鼓励持续追赶或防守。Longitudinal Advantage Cost:评估沿参考线的纵向相对位置,驱动超车或卡位。Blocking Alignment Cost:当自车领先时,惩罚偏离对手行驶路径的行为,强化防守姿态。Safety Cost:基于指数函数惩罚碰撞风险,保留安全余量。 四种成本加权求和,对候选轨迹进行降序排名,排名高的轨迹综合了攻击、防守和安全等多样行为。
3. 可行性选择 (Feasibility Selection)
按排名依次检查轨迹,需同时满足:
- 赛道边界约束:车辆外廓不超出左右边界,使用有符号距离场 (SDF) 快速碰撞检测。
- 碰撞避免约束:自车与所有对手的包围圆距离大于安全阈值,并考虑预测误差扩展。 首个通过检查的轨迹被选为输出,若全部失败则回退到保守控制(如紧急制动或保持当前动作)。
输出
- 实时执行的最优控制序列(加速度、转向角),发送给车辆低层控制器。
与同类方法的差异
相比于基于迭代均衡求解的博弈论规划(如 iLQR/DDP 动态博弈),SGTP 避免显式求解复杂耦合均衡,利用 GPU 大规模并行采样和启发式博弈成本排序,在计算效率(单步 < 0.1 秒)与策略多样性(超车、防守、跟随自然切换)之间取得工程化平衡,尤其适合多车实时竞技场景。
实验
实验设计
实验在多种挑战性赛道上模拟了高度交互的多车竞速场景,车辆数量从 2 辆扩展到 10 辆。评估体系包含定性分析(多行为交互、防御与鲁棒性)和定量指标(Win Rate、Task Completion Ratio、计算耗时)。通过与现有规划器的对比,重点验证 SGTP 在策略多样性、实时性与安全性上的综合优势。测试覆盖持续轮对轮交互、攻防切换及扰动恢复能力。
关键发现
SGTP 在高度对抗的比赛中达到 95.24% 胜率 和 99.35% 任务完成率,平均规划耗时仅 0.095 秒,且能成功扩展至 10 辆车 的大规模场景。这得益于博弈感知成本函数对竞争意图的建模——它同时考虑位置维持、纵向优势、阻挡对齐和安全因素,使采样轨迹能自发涌现出超车、防守、跟随等多种行为,并通过 GPU 并行加速保证实时性。可行性检查则确保了轨迹在复杂动态下的安全边界。
与基线的深度对比
传统规划器常陷入“策略单一”或“计算过重”的两难:基于规则的方法缺乏灵活性,而纯优化类方法在实时交互中难以在短时间内求解多智能体博弈均衡。SGTP 的创新在于用采样代替全部优化,将博弈推理浓缩为四个成本项,再通过 GPU 加速完成大量轨迹的生成与评价。这使得它既保留了博弈论对交互的精准刻画,又达到了采样方法的在线效率。对比实验(详见原文)表明,SGTP 在 Win Rate 和完成率上远超同类的模型预测控制(MPC)和深度强化学习(RL)方法,尤其在攻防频繁转换时表现出更流畅的策略过渡,验证了该方法在真实竞速场景中的落地潜力。
行业影响
落地场景
SGTP 为实时多智能体交互决策提供了高效框架,可应用于:
- 自动驾驶仿真与测试:在高动态竞速场景中生成多样化的对抗行为,加速算法验证闭环。
- 机器人竞技与电竞 AI:为无人机竞速、机器人足球等提供策略丰富的对手 AI,提升训练与观赏性。
- 物流与移动机器人调度:在狭窄通道、密集交叉口等交互密集场景中,实现安全高效的协调。
- VR/AR 仿真与游戏 NPC:为虚拟赛车游戏生成拟人化、有博弈性的 AI 车手,增强沉浸感。
商业价值
- 降本:通过 GPU 并行采样替代传统迭代优化,将规划延迟压缩至 0.095 s,大幅降低计算资源消耗,使实时博弈推理可部署于嵌入式平台。
- 增收:高胜率(95.24%)与任务完成率(99.35%)直接提升竞速场景的算法性能,可赋能自动驾驶测试服务、专业模拟器等收费产品。
- 体验提升:生成多样的竞争行为(进攻、防守、封锁),避免规则化对手的单调性,使仿真环境中的交互更贴近真实人类驾驶风格,提高测试有效性。
与现有产品/工作流的接口
- 集成进自动驾驶仿真器(如 CARLA、SUMO):SGTP 可作为 ROS 节点或插件,接收感知/预测结果,输出轨迹控制指令,替代传统基于规则或优化的规划模块。
- 与预测模块结合:利用博弈代价函数融合对手意图估计,形成“预测-博弈-规划”松耦合 pipeline,无需端到端重训练。
- 可扩展至多车协同:通过增加采样规模,10 车场景仍保持实时性,适合云端并行仿真与大规模回放验证。
具体落地用例
- 自动驾驶仿真测试平台:为 Tier-1 或 OEM 提供“对抗性驾驶库”,在环仿真中植入 SGTP 控制脚本,模拟激进插队、防守抢道等极端交互,暴露感知决策缺陷,替代人工规则编写。
- 专业赛车模拟器(如 Assetto Corsa 或 iRacing)的 AI 引擎:嵌入 SGTP 生成具有博弈意识的虚拟对手,根据玩家水平动态调整侵略性,提升单机训练趣味性与商业电竞观赏性。
局限
- SGTP 的性能评估完全基于仿真环境,尚未在真实赛车上部署验证。仿真中的车辆动力学模型、传感器噪声和通信延迟等均经过简化,实际比赛中面临的轮胎磨损、空气动力学干扰以及对手策略的不确定性可能大幅降低规划效果。
- 该方法依赖 GPU 并行加速来实现实时性,虽然平均计算时间为 0.095 秒,但硬件要求较高,难以直接迁移到算力有限的嵌入式计算平台。对于未来实车部署,需要进一步优化算力消耗或设计更轻量化的版本。
- 博弈意识的代价函数设计主要针对双车攻防场景,当扩展到 10 个车辆时,文中仅展示了仿真可行性,并未深入分析策略多样性和竞争平衡是否会退化。大规模多车交互下的博弈复杂度可能使采样空间的覆盖效率降低,导致部分车辆做出次优决策。