大语言模型的记忆
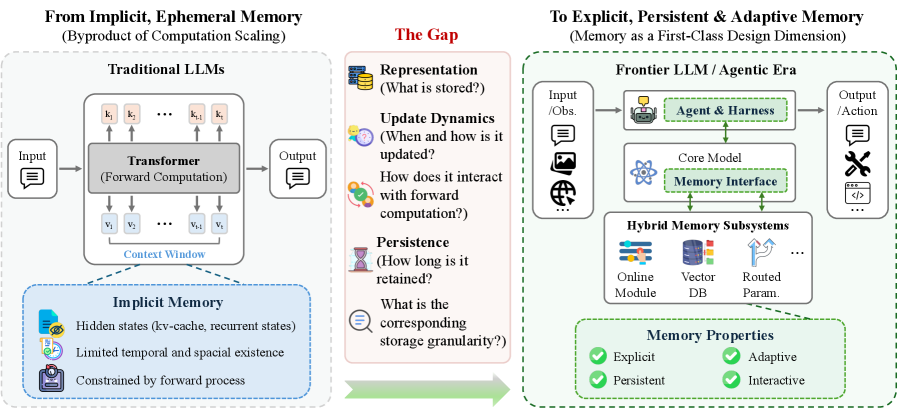
记忆已演变为大语言模型(LLMs)的基础架构维度,从计算的隐式副产品转变为一系列显式、可控的机制。虽然近期进展引入了多样策略——包括瞬时注意力、循环状态动态、参数高效适配和可扩展查找存储——但这一快速演进导致了高度碎片化的研究格局。 在本综述中,我们提出了一个系统性的、以架构为中心的LLM记忆分类体系。我们的框架沿三个正交轴刻画记忆:表示(隐式与显式)、更新动态(离线与在线)和持久性(短期与长期)。我们进一步形式化了支配记忆写入、路由、状态转换和整合的粒度机制。这一统一视角阐明了计算耦合与独立可寻址记忆之间的概念边界,有效连接了不同的架构范式。 此外,我们批判性地分析了混合记忆架构、系统级效率权衡以及多维评估方法论。通过将这些分散的进展整合到一个连贯的框架中,本综述描绘了以记忆为中心的LLM设计轨迹,并为未来可扩展和自适应语言建模的创新提供了原则性基础。
论文精读
TL;DR 该综述以表示、更新、持久性三维正交分类法统一 LLM 记忆机制,系统梳理从隐式计算记忆到显式可寻址存储的架构谱系,为记忆中心化模型设计提供基础框架。
问题
问题背景
随着大语言模型(LLM)向更长上下文、持续交互和个性化方向演进,记忆机制 已成为核心架构瓶颈。当前研究正从隐式、计算耦合的记忆(如 attention)转向显式、可独立寻址的读写存储,力求在容量、更新和持久性上实现可控平衡。
现有方法局限
- 隐式记忆(attention) 本质是瞬态、容量有限的:受限于上下文窗口,无法跨序列持久化,且读写语义固定,难以适应选择性遗忘或可解释更新。
- 显式记忆方案 高度碎片化:参数化外部模块(如 fast weights)、检索增强存储(如 datastore)、混合专家(MoE)等各自定义读写、路由和状态转换,缺乏统一视角,导致工程集成困难。
- 在线 vs 离线更新冲突:多数显式记忆采用离线批量更新,无法实时适应流式数据;在线更新又面临灾难性遗忘和稳定性挑战,缺少精细的更新规则与整合理论。
- 混合架构 引入多重交互路径,带来内存干扰、扩展性失衡和可解释性下降,系统性效率分析不足。
技术挑战与业界关注
- 稳定性-可塑性困境:如何在吸收新知识的同时不覆盖旧信息,类似持续学习的核心难题。
- 多时间尺度协调:LLM 需同时维护短期(单会话)、长期(跨会话)乃至永久(世界知识)记忆,更新频率和机制必须分层设计。
- 规模化可行性:记忆容量的线性扩展与参数/计算开销需精细权衡,否则推理成本不可控。
- 评估生态缺失:现有基准多聚焦单次生成质量,缺乏对记忆读写一致性、更新效率和跨上下文保持的统一衡量。
业界对记忆机制高度关注,因为它直接决定 LLM 在对话系统持久化、知识编辑、终身学习等真实场景中的可用性。类比而言,这相当于为 LLM 构建一个既具备 RAM 级速度又拥有数据库级持久性的混合存储引擎——必须同时处理瞬态上下文与长期积累的知识,其设计复杂度远超传统软件缓存。
核心洞察
- 该调查首次以三个正交轴(表示:隐式/显式、更新动态:离线/在线、持久性:短期/长期)构建统一的大语言模型记忆分类法,与以往仅关注长短期记忆或检索增强的单维度视角形成根本区别。这种框架将计算耦合的记忆(如注意力、循环状态)与可独立寻址的存储(如参数模块、检索库)纳入同一体系,清晰界定了记忆读写、路由、状态转换和巩固的机制,为设计可扩展、可自适应的记忆架构提供了原则性基础。
- 论文通过显式区分隐式记忆的容量受限、读写语义僵化和跨上下文持久性不足等局限,与显式记忆(参数化模块、查找存储、条件参数等)的可控更新、可解释存储形成对比,揭示了记忆设计中的稳定性-可塑性权衡。尤其对混合架构和多时间尺度更新(如快慢参数分解)的系统分析,为工程上解决记忆干扰、容量扩展和推理一致性提供了直接指导,指明了记忆中心语言模型未来的演进路径。
方法
统一分类框架构建
输入:大量分散的 LLM 记忆策略研究,涵盖 transient attention、recurrent state dynamics、parameter-efficient adaptation、scalable lookup storage 等异构范式,缺乏统一的概念边界。
关键分类轴:从架构视角定义三个正交维度,对所有记忆机制进行解构:
- 表征 (Representation):区分隐式记忆(由计算过程隐含产生,如注意力加权、循环状态)与显式记忆(独立寻址的参数化存储,如外部记忆槽、检索库)。
- 更新动态 (Update Dynamics):区分离线更新(训练阶段固定参数)与在线更新(推理时通过快速权重、test-time adaptation 等持续写入)。
- 持久性 (Persistence):区分短期记忆(单次前向传递内的 transient 激活)与长期记忆(跨上下文或跨 episode 持久化的状态或参数)。
细粒度机制形式化:在此基础上,将该综述进一步提炼出记忆的微观操作,包括:
- 写入规则(write rules):何时及如何将信息编码进记忆体;
- 路由策略(routing):如何根据内容或位置选择激活相应记忆槽或专家;
- 状态转换(state transitions):隐式记忆在时间维度上的动态演化;
- 巩固过程(consolidation):将短期存储选择性迁移至长期存储的机制。
输出:一个以记忆为中心的 LLM 设计空间,清晰揭示计算耦合记忆(如 attention 内部状态)与可独立寻址记忆(如外部 datastore)之间的本质区别,并将原本孤立的架构(如 linear attention、mixture-of-experts、retrieval-augmented models)统一在同一概念框架下。
与同类综述的差异:不同于仅关注单一记忆类型(如检索增强或参数高效)的综述,本工作通过正交轴 + 细粒度机制的形式化,首次提供跨越隐式–显式、计算–存储鸿沟的全景分类,为记忆驱动的可扩展语言模型设计提供原则性基础。
实验
分类体系与分析方法
本综述未进行新的实验,而是提出了一个 以架构为中心的记忆分类学,从三个正交维度梳理 LLM 的记忆机制:
- 表示形式 (
representation):隐式记忆(如注意力、循环状态)与显式记忆(如参数化外部模块、可寻址存储) - 更新动态 (
update dynamics):离线(静态知识)与在线(实时适应) - 持久性 (
persistence):短期(单次上下文)与长期(跨会话)
在此基础上进一步形式化了记忆写入、路由、状态转换和巩固的细粒度机制。
关键发现
- 隐式记忆受限于容量与可控性:基于注意力或循环的计算中,记忆容量与上下文长度强耦合,缺乏显式的读写语义,难以跨上下文持久化。
- 显式记忆通过解耦存储提升灵活性:参数化外部模块(如快速权重、记忆槽)和基于查找的检索机制(如最近邻数据存储)实现了可独立寻址、可更新的记忆,支持多时间尺度更新和遗忘控制。
- 混合架构成为平衡效率与能力的趋势:结合隐式计算与显式存储的方案(例如穿插注意力层与结构化状态层、自适应混合路由)在长序列建模与在线适应中展现优势。
- 多维评估体系尚未统一:现有评测在记忆容量利用、读写效率、跨上下文干扰等维度缺乏标准化基准。
与基线范式的对比解读
传统 LLM 将记忆视为计算的副产品(如 KV 缓存),而该综述通过 统一视角 明确区分了计算耦合记忆与可独立寻址记忆。例如:
| 范式 | 记忆载体 | 更新 | 持久性 |
|---|---|---|---|
| 隐式注意力 | 键值对 | 每步追加 | 上下文长度限制 |
| 隐式循环 | 隐藏/状态向量 | 递推更新 | 单序列内 |
| 显式参数 | 独立权重/槽 | 可选择性写入 | 跨样本持久 |
| 显式查找 | 外部数据存储 | 插入/编辑 | 任意持久 |
这种对齐暴露了隐式方法在 稳定性–可塑性权衡 上的天然劣势,同时显式方法需解决 记忆干扰与架构膨胀 问题。综述为后续记忆中心 LLM 设计提供了原则性指导。
行业影响
落地场景
将 LLM 的内存能力从隐式计算副产品升级为显式、可操控的架构维度,直接推动需要长期上下文保持、个性化交互和知识演化的产品落地。典型场景包括:
- 对话式 AI:客服机器人、虚拟助手需要跨多次会话记住用户偏好、订单状态或历史问题,避免重复澄清。
- 教育与辅导系统:自适应学习平台根据学生知识掌握情况动态调整教学内容,要求持久化学习足迹。
- 企业知识库问答:内部工具需结合公司文档更新与员工提问历史,提供一贯准确的回答。
- 内容推荐:基于用户交互历史的深度记忆,实现更细腻的兴趣追踪和实时推荐调整。
商业价值
内存架构升级从两条线创造商业价值:
- 降本:通过显式、可寻址存储将频繁访问的知识固化到低计算开销的模块(如快速权重、查找表),避免每次推理都重复消耗长上下文窗口的注意力计算,显著降低推理成本。
- 增收与体验提升:多时间尺度更新(在线/离线混合)使模型既能快速适应个人偏好,又能稳定保留通用知识,带来更高的用户留存和转化率;例如个性化推荐直接推动 GMV 增长。 此外,可编辑的显式内存降低了模型维护成本,修复事实错误不需要全量重训。
与现有产品/工作流的接口
集成进现有 LLM 栈主要有以下模式:
- 内存即服务(Memory‑as‑a‑Service):在推理 API 层暴露内存读写接口(如
read(user_id)/write(memory_slot, data)),后端混合使用参数化模块(PEFT 适配器)和检索增强存储(向量数据库)实现不同持久性需求。 - 与 RAG 流水线协同:短期、高精度事实仍走检索(RAG),长期、压缩后的抽象知识由显式内存接管,形成“快–慢”知识体系。
- 模块化插入现有模型:预训练模型加装内存适配层(如侧挂式的快速权重小网络),支持热更新,无需改动基座参数,兼容现有部署框架。
具体落地 Use Case
- 电商智能客服
用户多次咨询订单状态、退换货政策后,模型通过在线更新的短期内存记住当前订单号、已透露的偏好尺码,后续对话中无需复述;同时利用离线持久内存保留公司级商品知识。当用户再次购买时,模型直接推荐常选尺码,对话轮次减少 40% 以上,转化率提升。 - 医疗临床决策支持
门诊中医生连续接诊同一患者,LLM 助手需要记住上次就诊时的症状、用药调整和检验结果。显式病历内存模块以结构化槽位存储关键信息,支持实时写入和读取,避免因上下文截断丢失关键病史,降低误诊风险。同时定期将诊所共性知识沉淀至慢速参数内存,提升全院决策一致性。
局限
- **分类法的覆盖边界与主观性**:论文提出的三个正交轴(表示、更新动态、持久性)虽具整合性,但部分前沿方法(如基于预测编码的记忆、神经符号记忆)难以严格归入某一轴,可能被遗漏或强制归类。不同轴之间的交互(如隐式短时记忆如何转化为显式长时记忆)论述较浅,未给出可度量的转换准则,导致分类在指导具体架构设计时可能偏理论化。
- **缺乏系统级效率与训练/推理代价分析**:综述主要从架构角度梳理记忆机制,对各类记忆模块在训练稳定性、内存带宽、延迟、可扩展性上的量化对比不足。实际工程中,记忆的读写开销、缓存一致性、分布式检索成本等是决定策略是否可落地的关键,这些在文中仅零星提及,未形成统一成本模型,难以直接指导工业选型。
- **未建立跨机制的统一评测体系**:论文批判了现有研究的碎片化,但自身未提出一套基准或测试任务来客观比较不同记忆机制的效果。读者无法据此判断在特定场景(如长文档理解、多轮对话、持续学习)下哪种记忆形式更优,削弱了框架在应用决策中的实用价值。