SceneActBench: 智能体能否在其所见的3D场景中行动?
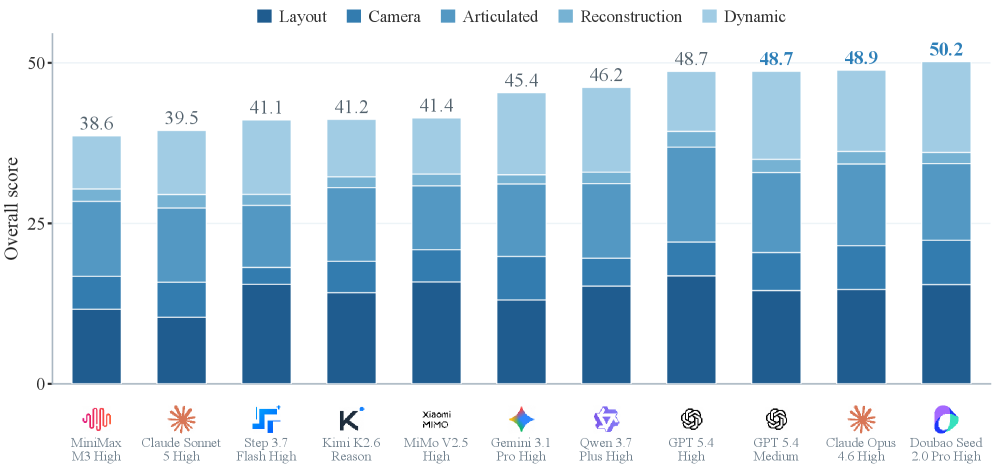
视觉-语言模型(VLM)智能体越来越多地使用工具在3D场景中行动,而不仅仅是描述它们。现有的3D基准测试主要评估文本响应或单物体操作,导致对智能体在完整多物体3D场景上的行动评估不足。 我们提出 SceneActBench,一个在统一智能体-环境循环下,针对五项3D任务的视觉条件行动基准。给定PNG图像或采样视频帧,以及(若适用)提供的3D资产,智能体在3D环境中行动。我们使用任务特定的几何指标,将每个最终输出与隐藏的真实标签进行评估。SceneActBench 包含从210个源实例构建的五项任务,共520个任务案例(包括成对的输入条件)。每个任务通过一个固定的智能体循环运行,以保持公平比较。 在11个专有VLM配置上,总体得分范围为38.6-50.2,没有配置在所有任务上表现一致。我们进一步分析了失败的表现位置和方式。
论文精读
TL;DR SceneActBench 首次系统评估 VLM 在完整多物体 3D 场景上的视觉条件动作能力,通过五个任务揭示现有模型普遍表现平庸且跨任务不一致,并深入分析失败模式。
问题
问题背景
VLM 智能体正从单纯描述 3D 场景迈向通过工具与代码执行操作。业界急需能系统评估智能体在完整多物体 3D 环境下“看而后行动”能力的基准。
现有方法局限
现有 3D 基准存在两类明显缺口:
- 文本输出类基准 (如 3D VQA) 仅评估语义描述,不涉及几何操作或物理交互,无法反映真实任务中的行动能力。
- 单物体操作基准 将测试局限在孤立物体上,忽略多物体场景所需的空间推理、遮挡理解及长周期动作规划。
- 多数基准直接将最终文本回答与参考答案匹配,缺少任务专属几何指标 (如平移误差、旋转误差、交并比) 来量化空间精确度。
- 不同工作使用各自的智能体循环与输入条件 (图像、视频、3D 资产),横向比较几乎没有公平基础。
为什么这个问题难且重要
在真实 3D 环境中执行操作要求智能体同时解决低层次几何理解 (深度、遮挡、6‑DoF 位姿) 与高层次任务规划 (步骤分解、工具选择)。这跨越了传统 VLM 擅长的语义识别与机器人学所需的精确控制之间的鸿沟。随着具身智能、AR/VR、工业数字孪生等应用快速发展,具备空间行动能力的 VLM 智能体成为技术落地的关键瓶颈,统一的评测基准对于追踪进展至关重要。
行业类比
如同自动驾驶需要从感知评测升级到闭环规划评测,VLM 智能体也需要从看图说话进入环境交互闭环评测才能真正检验 3D 场景理解与行动能力。
核心洞察
- SceneActBench 将 3D 场景理解评估从“描述”推进到“行动”:与主流 3D VQA 或单物体操控 benchmarks 不同,它要求 VLM agent 在完整的多物体 3D 环境中产出可量化的几何输出(如布局、相机位姿、关节状态),并用任务特定的空间度量(而非文本相似度)直接评分,更贴近具身智能与 3D 工具调用的实际工程需求。
- 该基准揭示了当前 VLM 在 3D 行动能力上的断裂性表现:即使在统一的 agent-environment 循环下,各任务得分最高仅 50.2(百分制),且没有一个模型跨任务稳定领先,说明 3D 感知到几何行动之间的映射仍是系统性瓶颈,而非个别模型能力不足。
方法
SceneActBench 以统一的 代理-环境交互循环 为核心,评测 VLM 代理在 3D 场景中的操作能力。
输入与感知
代理仅接收视觉输入,包括静态 PNG 图像或采样的视频帧,并可选择性获得底层 3D 资产(如网格、点云),模拟真实场景下仅依赖视觉观察的约束。
任务与行动空间
基准涵盖五个 3D 任务:
- Layout:物体布局与位置调整
- Camera:相机视角与位姿规划
- Articulated:关节物体的旋转/平移操控
- Reconstruction:基于视觉的 3D 形状重建
- Dynamic:动态场景的交互与预测
代理通过编写 Python 代码或调用工具 API 在 3D 环境中执行动作,每个任务限定固定的步骤预算(step budget),代理在多轮交互中根据环境返回的视觉反馈迭代优化决策。
数据构造
从 210 个源场景实例生成 520 个测试案例,包含成对的输入条件(如不同视角的图像)。真实的动作标注(ground truth)对代理隐藏,仅在评估时使用。
评估指标
最终输出使用任务特定的 几何度量 进行评分,例如布局的平移/旋转误差、相机的视角差异、关节角度偏差、重建的几何精度等。所有分数经归一化得到统一的 Overall score,实现跨任务、跨模型的公平对比。
核心差异
与仅评测文本描述或单物体抓取的现有 3D 基准不同,SceneActBench 首次要求代理在完整多物体 3D 场景中执行连续操作,并以严格的几何验证直接衡量 3D 行动能力,而非间接的语言描述准确性。
实验
实验设计
SceneActBench 是一个针对性构建的基准,旨在评估 VLM 代理在完整多对象 3D 场景中的行动能力,而非孤立文本回答或单物体操作。基准包含五个任务类别:Layout、Camera、Articulated、Reconstruction 和 Dynamic,从 210 个源实例构建出 520 个任务案例(含成对输入条件)。每个任务通过统一的 代理-环境循环 执行:输入为 PNG 图像或采样视频帧,并视情况提供预建 3D 资产,代理输出最终行动,评价时与隐藏真值进行 任务特定的几何度量 对比。为公平比较,所有任务使用同一固定循环策略,且仅对比最终输出。
关键发现
在评估的 11 个专有 VLM 配置中,总体得分仅 38.6–50.2(满分未给出,但从范围推测仍较低),且没有一种模型能在所有任务上一致领先。进一步分析揭示:
- 任务难度排序:不同任务对空间推理、物理交互的要求差异显著,导致模型表现排名随任务摆动;
- 输入条件影响:图像与视频、有无 3D 资产等条件会显著影响性能,部分模型对某些条件更敏感;
- 失败模式集中:细粒度空间操控(如 Articulated)和长序列动态交互(如 Dynamic)是主要短板,反映出 VLM 在几何理解和持续行动规划上的不足;
- 交互效率:代理往往未能充分利用有限步数预算,低效探索常见。
与基线的对比解读
当前 3D 评估大多止于 视觉问答(VQA) 或单对象抓取等简化任务,忽略了对完整场景的连贯操作。SceneActBench 填补了这一缺口:它要求代理在统一的行动循环中完成任务,直接对 行动输出 进行几何度量,而非间接评估文本描述。实验结果表明,现有 VLM 从“看懂”到“做到”仍有较大断层,尤其是涉及零件级操纵、场景重建和物理动态的场景。这为后续研究指明了清晰方向:需要更强的 3D 视觉编码器、行动空间理解以及记忆与规划机制,而不仅仅依赖语言指令的下发。基准已开源,便于复现与迭代。
行业影响
落地场景
SceneActBench 所定义的 VLM 代理 3D 操作能力,可落地于智能机器人操控、AR 辅助设计、数字孪生监控等领域。在电商业务中,代理能基于 3D 商品模型自动优化布局并生成多角度展示视频;在自动驾驶仿真中,代理动态调整场景物体位置与运动参数,加速 corner-case 生成;在工业数字孪生中,代理根据巡检指令移动虚拟相机、操控设备铰链,实现远程故障诊断。这些场景均要求模型从视觉输入直接产生精确的几何动作,而非仅仅回答文本问题。
商业价值
- 降本:自动化 3D 内容制作(如游戏关卡布局、虚拟展厅搭建)可减少人工建模与调试时间,降低美术外包成本。
- 增收:在电商中实现3D 商品智能展示,自动生成多视角浏览视频或动态场景,提升用户停留时长与转化率。
- 体验升级:在 AR 导航或远程协作中,VLM 代理理解指令并实时调整 3D 场景,提供更自然的交互,例如指导工人操作复杂设备。
与现有产品/工作流的集成
SceneActBench 的评估框架可直接接入 VLM 工具调用链。代理以视觉输入(PNG/视频) + 3D 资产 为感知基础,输出可执行的 3D 操作代码,这与主流 Agent 框架(如 LangChain、AutoGPT)的工具调用范式一致。实际集成时,可将几何评估器作为离线测试套件,迭代优化 agent 的 prompt 与推理策略。产线上,VLM 代理通过 API 接收自然语言指令,生成操作序列,调用底层引擎(如 Unity、Unreal Engine)执行,形成视觉反馈闭环。
具体落地 Use Case
- 电商 3D 商品自动布景:卖家上传单个 3D 模型,VLM 代理根据商品类别(如家具)选择适配场景模板,自动调整灯光、相机角度及道具摆放,输出高质量商品图,用于详情页或广告素材,无需人工美术干预。
- 工业设备数字孪生巡检:工厂设备有 3D 模型,操作员通过语音或文本指令(如“检查发动机第三缸温度传感器连接状态”),VLM 代理在数字孪生环境中操控相机到目标位置,动态添加标注或播放爆炸视图动画,辅助远程专家诊断,减少现场巡检次数。
局限
- - **场景与任务覆盖有限**:基准从 210 个源实例构建 520 个任务用例,涵盖布局、相机、铰接、重建、动态五类操作,但每个任务的场景数量和语义多样性仍显不足,难以反映现实世界中更复杂的多对象交互和长时规划需求,且未涉及物理仿真、触觉反馈等与真实机器人操控密切相关的维度。
- - **仅评估专有 VLM,生态开放性不足**:实验仅在 11 种闭源 VLM 配置上进行,未纳入 GPT-4V、Gemini 之外的开源模型(如 LLaVA、InternVL 等),导致结论的普适性受限,开发者无法验证本地部署的轻量模型在统一接口下的行为偏差,也无法直接复用基准到私有模型迭代中。
- - **固定的 agent–环境循环可能压低真实能力上限**:为公平比较,所有任务共享同一固定的 step budget 和工具调用流程,这虽然消除了策略差异,却也可能强加不必要的约束(例如重建任务可能需要截然不同的交互步数),使得模型原生推理链优势无法体现,分数不能完全反映实际可达到的性能。