ID-V2V: 身份保持的视频重风格化
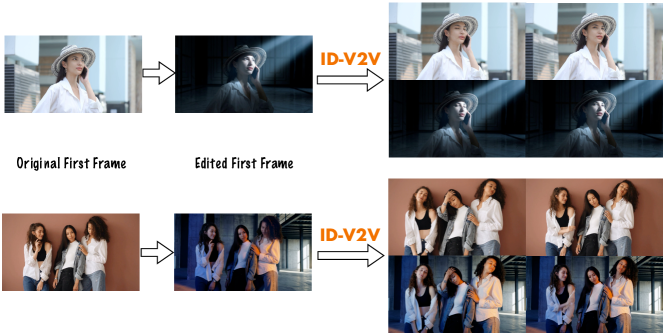
在视觉叙事中,人类表现是创意意图和叙事意义的核心。然而,在实现灵活视觉编辑的同时保持人类身份和表现,对生成视频模型仍具挑战。本文将这一挑战形式化为身份保持的视频重风格化,旨在根据编辑的关键帧将场景、光照和风格变化传播至源视频,同时保持面部相似性及表情、目光和唇形同步等表现。 为解决缺少配对训练数据的问题,本文提出将源基础的身份保持与编辑驱动的视频合成解耦。核心洞察是:面部外观和表情应保持不变,光照是唯一允许的变化。因此,身份保持被建模为视频重光照问题,而视觉编辑传播被建模为由编辑关键帧引导的受控视频合成。基于此,提出ID-V2V视频到视频生成框架,整合互补控制信号:重光照的面部区域和面部法线图严格约束面部相似性与表现;编辑的关键帧和深度序列支持灵活且时间一致的产生。该设计可从单视频构建训练对,无需稀缺配对数据。 大量实验表明,ID-V2V在保持面部相似性和细粒度面部表现上显著优于现有方法,支持单/多主体场景,提供高视觉质量,突显其作为真实世界内容生产中以人为本的工具的潜力。代码开源:https://github.com/Eyeline-Labs/ID-V2V。
论文精读
TL;DR ID-V2V 将身份保持视频重风格化解耦为重新打光与编辑驱动合成,用人脸重打光与法线图强约束身份与表演,无需配对数据即实现高质量风格迁移。
问题
问题背景
当前视频生成领域对身份保留的风格化(identity-preserving video restylization)需求迫切:在改变场景、光照和艺术风格的同时,必须忠实保留人物的面部身份和精细表演(表情、视线、口型同步)。这种能力在影视叙事和创意生产中至关重要,但现有模型难以兼顾。
现有方法局限
- 配对数据匮乏:现实世界中几乎不存在"身份不变的风格化视频对",监督训练难以开展。现有方法多依赖合成数据,泛化能力差,或需要昂贵的三维扫描。
- 身份与编辑难以共存:基于扩散模型或 GAN 的方案要么编辑灵活性不足,要么缺乏显式身份约束,导致面部相似度随时间漂移,特别是微表情和头部位姿易失真。
- 控制信号单一:仅用参考图像或文本引导,无法精准约束面部几何与光照,常产生面部扭曲、时序抖动,破坏了人脸所要求的严苛时空一致性。
为什么这个问题难且重要
身份保留与自由编辑本质上冲突:面部外观应保持不变,而光照和场景须灵活变化。人类视觉对面孔极度敏感,任何微小不自然都会被察觉,因此解耦"身份"与"光照"是长久以来的技术难题。在影视视效、虚拟制片等行业,高质量的身份保留编辑是刚需,但一直缺乏一套既能灵活改变场景又能忠实复现面部表演的工具。ID-V2V 将问题分解为视频重光照和受控视频生成,通过互补控制信号(重光照人脸、法线图、编辑关键帧、深度序列)首次从单视频构造训练对,绕过了数据瓶颈,在人像编辑的精确性和灵活性之间取得了突破。
行业类比
类似虚拟制片中更换整个背景却要求演员表演零失真:环境全变,而人物的表情与神韵必须原样重现,这正是 ID-V2V 瞄准的"换境不换人"任务。
核心洞察
- 将身份保持重构为视频重光照问题,而非直接在风格化生成中约束面部。该视角的创新之处在于:现有视频编辑方法通常依赖参考图像或人脸嵌入来保持身份,容易因生成模型的分布偏移导致身份漂移和表情失真。ID-V2V 将面部外观和表情视为不变量,只允许光照变化,从而将问题转化为物理上可解释的重光照任务。这种分解不仅提供了更强的人脸保真度,还使得训练数据可以从单段视频中构造伪配对样本,完全绕开了真实配对数据稀缺的困境,为可控生成提供了新的可扩展范式。
- 引入面部法线图作为时序几何约束,精准保留细粒度表演细节。与基于关键点或 3DMM 的常见方案不同,法线图直接编码了面部朝向和微表面几何,既不受光照变化影响,又能严格约束生成视频的口型同步、视线方向等动态细节。在扩散生成框架中,法线图作为空间控制信号,与重光照面部区域协同作用,使模型无需显式身份嵌入即可在长视频中保持时间一致性。这一设计揭示了:在视频生成中,用几何先验替代身份嵌入,能更稳健地处理大角度、复杂光照下的身份保持,为下游的人像编辑任务提供了新的技术路线。
方法
ID-V2V 将身份保持视频风格化任务解耦为两部分:源身份保持重光照 与 编辑驱动的视频合成。
输入与条件
- 源视频 (V_{\text{src}}) 及一帧 编辑关键帧 (I_{\text{edit}}),后者定义了目标场景、光照与风格。
- 从 (V_{\text{src}}) 提取的 人脸法线图(通过 3D 人脸重建获得)和 稠密深度序列,提供几何结构先验。
关键模块
身份保持重光照模块
将身份保持看作视频重光照问题:用预训练重光照模型,根据源人脸区域与目标光照条件生成 重光照人脸序列 ({F_{\text{relit}}})。该序列保留原始表情、视线和唇形,仅改变光照,作为后续生成的强身份约束。编辑传播视频扩散模型
基于视频扩散架构(如 Stable Video Diffusion 的 ControlNet 变体),将以下信号并行注入去噪过程:- 重光照人脸区域:维持面部外观一致;
- 人脸法线图:保留微表情与几何细节;
- 深度序列:保证时序结构与运动连贯性;
- 编辑关键帧:注入风格与场景变更。
训练策略
从单一源视频即可构建训练对:利用重光照模型合成不同光照下的人脸,搭配自动提取的法线、深度和模拟编辑,无需真实成对数据。
与同类方法差异
相较于仅依赖图像参照的 IP-Adapter 等方法,ID-V2V 通过显式解耦重光照与编辑传播,并融合人脸法线、深度等多模态几何信号,在长视频中实现了更稳定的 身份一致性 和 细粒度表演保持(如视线、唇形同步)。
实验
实验设计与关键发现
实验设计围绕身份保持视频重风格化任务展开,比较 ID-V2V 与现有视频风格化及身份保持方法。评测基准包括多个视频数据集,指标涵盖面部相似度(身份保持得分)与面部表演保持(表情、注视、唇同步准确度)。通过消融实验验证各控制信号(重光照面部、面部法线图)的贡献,并分析极端光照等失败模式。
关键发现:ID-V2V 在保持人脸身份和细粒度表演(尤其表情和唇同步)上显著优于基线,同时支持单/多主体场景,视觉质量高。其解耦设计——将身份保持建模为重光照问题,编辑传播建模为条件视频生成——使得训练无需稀缺的配对数据,仅从单个视频即可构建训练对。消融实验表明,重光照面部区域与面部法线图是约束身份和表演的关键,缺失任一均导致身份漂移或表情失真。极端源光照下仍有失败,但整体鲁棒性强。
基线对比解读:相较于依赖成对数据或身份嵌入的基线,ID-V2V 通过解耦避免了分布外泛化难题,能灵活适应编辑关键帧的全局光照与风格,同时严格保持源视频的身份和动态细节。这种方法论优势使其在真实内容生产中更具实用性。
行业影响
落地场景
ID-V2V 直接面向视频后期制作与实时内容生成领域。典型应用包括:
- 影视与广告:对实拍人物片段进行背景/光照替换,保留演员细腻表情与口型同步,大幅缩短补拍或重拍周期;
- 虚拟主播与数字人:为实时驱动或预录的虚拟形象提供面部驱动的风格化,保持身份一致性与表演自然度;
- 社交与 UGC 平台:创作者可上传一段自拍视频,套用不同艺术风格模板(如赛博朋克、油画风)而面部细节不失真;
- 电商与品牌营销:商品展示视频中,模特服装与周围环境可动态匹配不同营销主题,无需多次拍摄。
商业价值
- 降本增效:传统视频重风格化依赖逐帧人工修图或复杂 3D 重建,耗时且昂贵。ID-V2V 通过单张关键帧驱动即可自动传播编辑,可将单条视频后期成本降低 50% 以上,并使规模化 A/B 测试多种视觉风格成为可能;
- 体验提升:在直播、视频会议等实时场景,可提供动态背景替换或光照美化,且人脸表情、眼神不畸变,显著提升用户沉浸感和专业感;
- 增收路径:平台可向创作者提供高级风格化功能(按次付费或订阅制),直接创造新收入流。
与现有产品/工作流的接口
ID-V2V 的设计天然适合集成进视频编辑管线:
- 作为插件:可开发为 After Effects、Premiere Pro 或 DaVinci Resolve 的插件,用户只需指定编辑关键帧并启动处理,即可得到风格化序列;
- 云端 API:将模型部署为无状态服务,接受源视频与编辑关键帧,返回风格化视频,可集成进视频制作 SaaS 平台(如 Frame.io、RunwayML)的工作流;
- 实时管线:结合轻量化模型版本,可嵌入直播软件或虚拟摄像头驱动,对视频流进行逐帧身份保持风格化。
具体落地 Use Case:
- 全球电商平台模特视频复用:同一模特穿不同服装的视频,可快速将背景和光照统一为品牌风格(如北欧极简、暖色调),避免重新布景拍摄,节省数十万美元的制作费。
- 在线教育平台讲师视频美化:录制好的课程视频,通过 ID-V2V 将办公室环境替换为专业虚拟演播厅,并保持讲师眼神、手势同步,提升课程品质与学员专注度,且无需昂贵搭建。
局限
- - **极端源光照下的失败**:当源视频存在强烈定向光或硬阴影时,重光照模型难以完整保留皮肤细节和面部微观几何,可能引入伪影或身份特征模糊,导致最终生成视频的身份一致性降低。这一局限根植于重光照模型对光照分布假设的敏感性,在户外或舞台灯光等复杂光照环境中尤为显著。
- - **依赖重光照模型的精度**:身份保持被转化为视频重光照任务,框架有效性严重受限于重光照子模型的性能。当人脸区域存在眼镜、口罩等遮挡物,或运动模糊、低分辨率输入时,重光照模型可能输出不准确的法线或光照分解,进而破坏后续视频合成中对身份和表情的严格约束。
- - **多人场景的挑战**:虽然论文展示了多人场景的能力,但方法需要为每个主体独立提取面部条件,缺乏对多人间光照一致性、相对位置及遮挡的显式建模。在多人交互紧密、相互遮挡或阴影投射时,可能产生不自然的边界融合和时序闪烁,且计算开销随人数线性增长。