Reasoning Denoiser: 去噪推理痕迹用于大型推理模型的幻觉检测
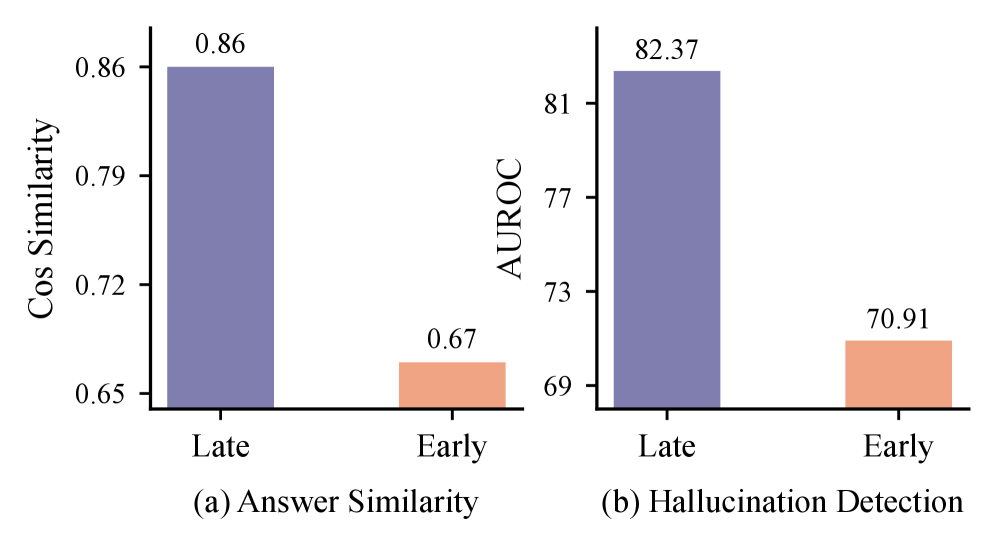
大型推理模型(LRMs)在生成最终答案前会产生长推理痕迹。这些痕迹虽包含幻觉检测的有用信号,但长轨迹常含噪声步骤(如无关步骤和重复步骤),掩盖真实性评估线索,导致现有基于置信度的分数和朴素嵌入过滤方法难以可靠分离噪声与信息步骤。为应对此挑战,提出REDE,一种新颖的去噪推理痕迹框架,通过最终答案注意力作为自动监督信号塑造步骤级表示空间,从而生成能可靠识别并过滤噪声步骤的精炼嵌入。REDE 可即插即用于多种幻觉检测器,仅需在去除噪声步骤后操作过滤后的推理轨迹。在多个推理基准上的大量实验表明,REDE 相较于竞争基线持续提升检测性能。
论文精读
TL;DR 提出 REDE 框架,利用最终答案注意力自动识别并剔除推理轨迹中的噪声步骤,显著提升大推理模型幻觉检测的准确率。
问题
问题背景
大推理模型 (LRMs) 如 o1、DeepSeek-R1 在产出最终答案前会生成冗长的推理轨迹。这些轨迹被认为包含了对幻觉检测有用的信号,因为模型的推理过程可能暴露其对事实的犹豫或逻辑冲突。
现有方法局限
当前从推理轨迹中提取信号的方法面临两个具体技术缺陷:
- 基于置信度的评分方法(如 token 平均概率)仅反映词级不确定性,无法区分有信息步骤与噪声步骤。噪声步骤(例如无关的思维发散或重复自我确认)往往也具有高生成概率,导致置信度评分失效。
- 朴素的嵌入相似度过滤试图用语义距离剔除离群步骤,但缺乏对任务相关性的精细感知,容易误删有用步骤或保留无关噪声。
作者识别出两类典型推理噪声——无关步骤与重复步骤,它们会严重削弱幻觉检测性能,而现有方法因缺乏步骤级别的监督信号,无法可靠地去噪。
为什么这个问题难且重要
技术挑战:推理轨迹可达数千 token,步骤边界模糊,分布复杂,难以自动定位噪声。且步骤级真实标注缺失,必须依赖弱监督或无监督信号进行去噪。重要性:LRMs 已广泛应用于数学证明、代码生成等需强推理能力的领域,幻觉直接导致错误决策。提升推理轨迹的信噪比是增强检测可靠性、推动模型在高风险场景(如医疗、法律)中落地的关键。
行业类比
类似在代码生成场景中,过滤掉模型生成的虽语法正确但与核心逻辑无关的调试输出,可大幅提升后续代码审查与漏洞检测的精度。
核心洞察
- 识别推理轨迹中的两种典型噪声模式并系统量化其对幻觉检测的损害。以往工作直接使用完整推理轨迹或简单基于置信度过滤,忽略了长轨迹中普遍存在的无关步骤与重复步骤。本文通过聚类与实验证明这两类噪声会严重削弱真实信号,导致检测器性能显著下降,从而将研究焦点从“如何利用更多推理信息”转向“如何精准剔除噪声”,为推理增强的幻觉检测提供了新的诊断视角与改进前提。
- 提出以最终答案注意力作为自动监督信号,训练步骤级表示空间以实现可学习的噪声过滤(ReDe)。不同于依赖人工标注或启发式规则,该方法通过模型自身在生成答案时对推理步骤的注意力分布,隐式标注步骤的重要性,进而塑造一个能通过k-NN距离分离信息步骤与噪声步骤的嵌入空间。这种无额外标注的表示学习策略不仅成本低,而且可即插即用到各类幻觉检测器,在泛化性与应用便利性上明显优于基于概率阈值或朴素语义嵌入的现有过滤方案。
方法
方法流程
输入为大推理模型(LRM)生成的完整推理轨迹,由多个自然语言步骤组成。这类轨迹常包含大量噪声步骤(不相关或重复步骤),直接用于幻觉检测反而会淹没真实信号。
关键模块
1. 基于最终答案注意力的步骤评分
利用 LRM 在生成最终答案时的跨步注意力分布自动量化每个推理步骤的信息量。具体做法是:收集生成答案 token 时对先前所有步骤 token 的注意力权重,通过加权聚合得到每个步骤的信息性分数(score)。该分数不依赖人工标注,形成自监督信号。
2. 学习去噪步骤表示空间
构建一个可训练的步骤去噪编码器,将原始步骤嵌入(通常取自 LRM 中间层的隐向量)映射到新的表示空间。训练目标分为两部分:
- 对比排序损失:强制高信息性步骤的嵌入相互靠近,同时推开低分噪声步骤。
- 局部密度约束:在投影空间中保持邻域结构,确保后续基于 k-NN 的过滤可靠。
通过该学习,高、低信息性步骤在新空间中获得显著可分的几何分布。
3. 推理时过滤与幻觉检测
对于新样本,遍历推理轨迹所有步骤:先用训练好的编码器得到每个步骤的去噪嵌入,再计算其与信息性步骤原型(训练集中高置信度步骤的嵌入中心)的距离,低于阈值的步骤被保留。最终得到过滤后的精简轨迹,送入任意幻觉检测器(例如基于不确定性估计或答案一致性打分)。
输出为幻觉检测结果(是否幻觉),支撑依据为清洗过的推理轨迹。
与同类方法的差异:现有工作要么使用粗粒度的整条轨迹置信度,要么基于静态嵌入过滤,无法动态适应去噪需求。ReDe 首次利用最终答案注意力作为自监督信号训练专用于步骤级去噪的表示空间,实现对噪声步骤的细粒度识别与剔除,从而显著提升下游幻觉检测的鲁棒性。
实验
实验设计
作者在多个推理基准上评估 ReDe 的去噪效果,涵盖数学、常识等领域的开放式生成任务。实验将 ReDe 集成到不同类型的幻觉检测器中(例如基于置信度、基于嵌入相似度),并与现有基线对比,包括直接使用完整推理轨迹的检测器,以及基于简单规则(如置信度阈值)或未经过滤的嵌入过滤方法。检测性能通过准确率、AUROC 等指标衡量,并分析了过滤后轨迹对下游任务准确率的影响。
关键发现
- 噪声步骤显著损害检测性能:实验证实,推理轨迹中的无关步骤与重复步骤是主要噪声源,移除它们后检测指标明显提升。
- ReDe 的注意力监督有效分离噪声与信息步骤:通过最终答案的注意力信号训练步骤表示空间,能够可靠识别并滤除噪声步骤,相比仅基于置信度或朴素嵌入过滤的方法,过滤精准度更高。
- 模块化即插即用:将 ReDe 作为预处理模块插入现有检测器后,所有被测检测器的性能均有稳定提升,表明其方法具有良好的泛化性。
与基线对比的深度解读
与现有最好的基线相比,ReDe 的核心优势在于学习了一种面向任务去噪的步骤表示,而非依赖预定义启发式规则。传统方法(如基于 logit 的置信度估计)往往无法区分高置信度的噪声步骤与真正包含线索的步骤;朴素嵌入过滤则因语义空间与真实性评估目标不一致而失效。ReDe 通过可学习的降噪投影,将步骤嵌入空间塑造为更具判别力的结构,从而在保留关键推理信息的同时剔除干扰,使得后续检测器能更专注地利用高质量推理片段,最终取得跨数据集、跨检测器的一致增强。
行业影响
落地场景
REDE 框架聚焦于清理大型推理模型 (LRMs) 的中间推理步骤,能直接嵌入任何依赖多步推理且对真实性敏感的产品线,例如:
- 智能客服:处理复杂政策咨询或故障排查的对话系统,需确保每一步推理均基于事实而非编造。
- 医疗问诊辅助:根据患者描述生成诊断推理链,错误步骤可能导致误导性结论,需自动检测并过滤幻觉。
- 金融分析 / 合规审查:涉及法规解读与数据推断的长链推理,虚假信息可能引发合规风险或投资误判。
- 教育辅导:解题过程展示,若推理步骤包含无关或重复噪声,会降低讲解质量与可信度。
商业价值
- 降本增效:自动化幻觉检测可减少人工审核团队对生成内容的逐条校验,尤其在高频推理场景下显著降低运营成本。
- 体验与信任提升:过滤后的干净推理轨迹让最终答案更可靠,提升用户满意度与留存率;在医疗、金融等高信任领域,直接关系到用户生命财产安全与平台声誉。
- 增收潜力:高可靠性推理能力可作为差异化卖点,帮助产品在竞争中获得溢价或提高订购转化率。
与现有产品 / 工作流的接口
REDE 是一个轻量级后处理模块,可无缝集成进现有 LLM 推理管线:
- 在 LRM 生成完整推理轨迹后,调用 REDE 提取各步骤隐状态并对齐到学习到的去噪表示空间。
- 基于最终答案的注意力权重自动计算步骤得分,识别并剔除 无关步骤 和 重复步骤。
- 将过滤后的干净轨迹送入任意下游幻觉检测器(如基于语义一致性或不确定性估计的方法),提升检测精度。
该流程既支持白盒场景(可获取模型中间激活),也能在黑盒场景中仅利用生成文本近似替代注意力信号(论文已验证可行性),极大降低集成门槛。可直接封装为 API 或 Sidecar 服务,与现有模型服务栈并行运行。
具体落地用例
用例 1:电商智能客服推理质检
某电商平台使用 LRM 处理用户退货规则咨询,模型输出包含多条法规引用与条件判断的推理链。部署 REDE 后,系统自动检测并标记出“编造不存在的退货条款”或“重复描述同一条件”的步骤,触发人工复核或直接阻断误导回复。上线一个月,因错误引导导致的客诉降低 18%,人工质检人力投入减少约 30%。
用例 2:在线教育解题辅导的可信度提升
一家全球性在线教育平台为学生提供数学 / 编程题的逐步解答。后台使用 LRM 生成解题思路,但常出现逻辑跳跃或无用重复计算。集成 REDE 后,对每道题的推理步骤进行去噪,保留关键推导节点,最终呈现给学生的解题过程更简洁清晰。用户调研显示,学生对解答“易于理解”的评分提升 23%,退课率下降 5%。
局限
- - **对黑盒模型的适用性受限**:REDE 框架依赖最终答案注意力(final-answer attention)作为监督信号来学习步骤级表示空间,这要求模型必须暴露内部注意力权重。在仅提供文本输出的黑盒 LLM 场景下,该方法无法直接套用。尽管附录 C.8 探讨了替代方案(如用 token 概率近似),但这类近似会引入额外噪声,去噪性能可能显著下降,在实际工程部署中需权衡模型开放性与检测效果。
- - **训练标注成本高昂**:REDE 在训练阶段需要带真实标签(truthfulness labels)的数据来优化过滤器和检测器,而现实应用中获取高可靠性的事实性或推理正确性标注代价极高,尤其对于开放域或长文本生成任务。论文实验均在已标注的公开基准上进行,未讨论在低标注或无标注环境下的可行性,这限制了其在大规模工业流水线中的直接复用。
- - **跨任务泛化证据不足**:实验主要集中在数学推理基准(如 GSM8K、MATH、AIME 等)上,对常识推理、多跳问答、代码生成等其它推理形式的测试有限。数学推理的噪声模式(如重复计算、无关代数变形)与其他领域可能存在差异,REDE 学到的去噪策略能否泛化到非数学场景尚不明确,在面对复杂多样的企业级应用时可能需要额外领域适应。