LAMAR: 一个开放的语言感知多语言对齐重排序器
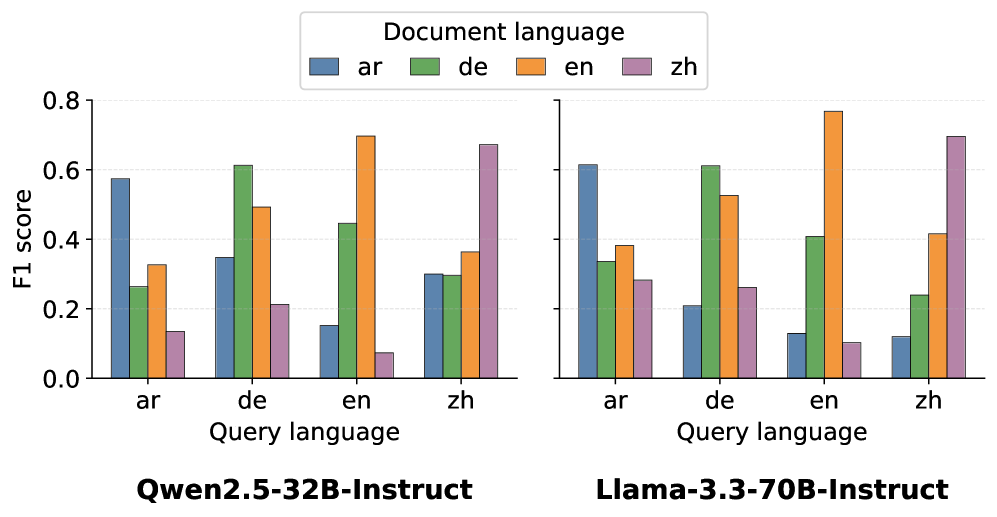
在多语言检索增强生成任务中,检索器可能返回多种语言的文档,这些文档在答案生成前需经重排序。然而,现有多语言重排序器在排序语义相关的候选项时,是否考虑了文档语言尚不明确。分析表明,当跨语言存在语义等同的文档时,这些重排序器并未一致地优先选择与查询同语言的文档,而文档语言可能影响答案生成。 为解决此问题,我们提出LAMAR,一个语言感知的多语言交叉编码器,旨在同时建模语义相关性和语言一致性。LAMAR 首先通过英语锚定相关性蒸馏建立跨语言输入的一致性相关性评分,再应用语言一致性偏好对齐,鼓励与查询同语言的文档获得更高排序,同时保留语义相关性。 在专为评估语言一致性设计的控制实验中,LAMAR 在整体及所有单个语言上均取得最佳性能。在已有的多语言重排序基准上,LAMAR 仍保持竞争力。在实际检索场景中,LAMAR 在第一阶段检索后重排序候选项时,在所有报告指标上均实现最佳结果。这些结果表明,LAMAR 在兼顾语言一致性的同时,在通用多语言重排序基准上表现强劲。
论文精读
TL;DR LAMAR 是首个将语言连贯性纳入多语言重排序的开源模型,通过英语锚定蒸馏与偏好对齐,在保持语义相关性的同时,优先排列与查询相同语言的文档,全面提升多语言 RAG 的重排序质量。
问题
多语言检索增强生成(RAG) 中,检索器常返回混合语言的候选文档,重排序环节需决定哪些文档对答案生成最有用。然而,现有多语言 reranker(如基于 mBERT 或 XLM-R 的 cross-encoder)仅关注跨语言语义匹配,完全忽略文档语言与查询语言的一致性。诊断实验表明,当存在跨语言语义等价的文档时,这些模型不会优先排列与查询相同语言的文档,即便语言一致性有助于下游生成质量。其局限根源在于训练目标单一:仅优化相关性标签,未引入语言偏好信号,导致模型在语言选择上呈中性,无法为生成器提供更连贯的上下文。
该问题之所以重要且困难,是因为语义相关性与语言一致性存在天然张力——鼓励语言偏好可能损害真正的语义排序,而忽略语言又可能降低生成答案的流畅度与可信度。技术上,多语言偏好对齐缺乏直接监督数据,且需在不破坏已有跨语言理解能力的前提下注入语言感知,这对模型设计和训练策略提出更高要求。在工业界,随着多语言知识库(如产品文档、内搜系统)的广泛应用,团队迫切需要能自适应查询语言的重排序器,以减少生成错误并提升用户体验。
类比:这就像多语言客服知识库中,虽然英文知识库内容最全,但用户用母语提问时,优先给出母语答案文档会显著提升满意度。
核心洞察
- **语言一致性偏好对齐** 通过构造平行文档组排序损失,显式鼓励重排器将查询语言相同的文档排在更前位置,同时维持语义相关性。与现有 multilingual reranker 仅依赖语义相似度不同,LAMAR 认识到文档语言与查询语言的一致性直接影响下游答案生成的质量。这为多语言 RAG 系统提供了新的设计维度:在重排序阶段纳入语言信号,而非仅依赖检索阶段的语言过滤。该损失函数设计简单易复现,可与蒸馏训练联合优化,对需要高生成质量的跨语言应用有直接工程价值。
- **英语锚定多语言相关性蒸馏** 以英语为锚点统一不同语言的相关性评分尺度,解决了 multilingual reranker 训练中语言间评分不可比的问题。通过让模型在多种语言上与英语教师模型对齐,LAMAR 能够学习到语言无关的语义相关性,从而在随后优化语言一致性时不会牺牲相关性排序的准确性。这种方法避免了对每对语言进行繁琐的双向蒸馏,为多语言模型训练提供了一种高效的范式,可直接适配到其他跨语言任务中。
方法
输入与模型基座
LAMAR 接收一个多语言查询 和一组多语言候选文档列表,输出重排序后的文档序列。其基座是一个多语言交叉编码器(cross-encoder),直接对 query-document 对进行相关性打分。
英文锚定相关性蒸馏 (Stage 1)
为保证跨语言分数可比性,LAMAR 使用英文教师模型 对英文 query-document 对生成相关性分数,然后将该分数作为监督信号蒸馏到多语言学生模型(LAMAR)上。学生模型在多种语言的数据 上学习预测这些教师分数(通常用 MSE 或 KL 散度),从而将所有语言的相关性评分锚定到英文教师的尺度,消除语言偏差。
语言一致性偏好对齐 (Stage 2)
此阶段旨在让模型学会偏好与查询语言相同的文档,同时不牺牲语义相关性。引入两个损失:
- 并行文档组排名损失:构造一组语义相同但语言不同的并行文档,要求模型将同语言文档 排在非同语言文档之前,并保持语义相关性强于不相关文档。
- 语言一致性损失:在通用多语言训练数据上,通过对同语言正例给予更高得分、不同语言正例适当降低得分的对比学习方式,进一步强化语言偏好。
输出
微调后的交叉编码器可直接为任意 query-document 对计算一个相关性分数,重排时按分数降序生成最终列表。
与同类方法的差异
现有重排序器(如 mMiniLM、BGE-M3)仅优化语义相关性,不显式建模文档语言;LAMAR 通过两阶段训练将语言一致性作为显式目标,在需要语言匹配的 RAG 场景中更优,同时保持在通用重排序基准上的竞争力。
实验
实验设计
作者构建了一套 语言连贯性受控测试(language-coherence evaluation),通过跨语言的语义等价文档组,量化重排器是否会将与查询相同语言的文档排在更高位置。同时,在 多语言重排基准(如 MIRACL、XTREME-UP)以及模拟真实检索的候选集上进行评估,以验证模型在保持语义相关性的同时兼顾语言连贯性。
关键发现
- 语言连贯性:LAMAR 在所有测试语言上均取得最优,且总体性能明显优于基线。现有重排器在语义等价文档跨语言时,不会稳定地优先选择同语言文档,而 LAMAR 通过偏好对齐有效纠正了这一偏向。
- 多语言重排: LAMAR 在经典基准上与现有最佳模型持平或具有竞争力,证明语言连贯性优化并未牺牲通用重排能力。
- 真实检索设置: 在第一阶段检索结果上重排时,LAMAR 在所有报告指标上均达到最佳,体现其在实际系统中的鲁棒性。
与基线对比的深度解读
现有 多语言重排器(如 mE5、BGE-M3 等)主要聚焦语义相关性,但在多语言检索增强生成 (RAG) 场景中,文档语言会直接影响后续答案生成的质量。LAMAR 的创新在于首次显式建模语言连贯性:先通过 英语锚定相关性蒸馏 统一多语言语义得分标度,再借助 偏好对齐 提升同语言文档的排名,同时约束语义损失。与纯语义重排器相比,LAMAR 在不增加额外推理开销的前提下,解决了“跨语言优先”的工程痛点,为多语言 RAG 系统提供了即插即用的重排方案。
行业影响
落地场景
该工作直接面向多语言 RAG 管道的重排序环节。当检索器返回跨语言候选文档时,LAMAR 在维持语义相关性的同时,提升与查询语言一致的文档的排名,从而减少后续生成模型因语言不匹配导致的幻觉或理解偏差。典型应用包括:
- 全球电商平台 的商品描述搜索(用户用母语查询,候选结果包含多语言评论或详情页)
- 多语言企业知识库(员工用本地语言提问,系统需从多语言文档库中检索并排序)
- 跨国客服系统(历史工单与 FAQ 混合多语言,需按语言一致性优化排序以提升生成质量)
商业价值
重排序阶段的语言感知优化直接提升答案准确性,降低人工校验成本:
- 降本增效:减少因语言混排造成的低质量生成,从而降低人工审核或重写环节的人力投入
- 体验提升:用户更容易获得语言连贯的答案,缩短阅读与理解时间,提升搜索或问答的满意度
- 模型复用与开源红利:LAMAR 基于开源架构且提供 Hugging Face 模型权重,企业可低成本微调适应自身场景,避免自研大规模多语言排序模型
与现有产品/工作流的接口
LAMAR 作为 cross-encoder reranker,可直接嵌入主流 RAG pipeline:
- 前置检索阶段 仍使用现有高召回向量库(如 Elasticsearch、Milvus、FAISS)或稀疏检索(BM25)
- 重排序节点 将检索到的 Top-K(如 100)候选文档批量送入 LAMAR,按「语义相关性 + 语言一致性」联合打分
- 后处理生成 将重排序后的文档喂给 LLM(如 GPT-4、Llama 3),由于文档语言更统一,生成质量更高
具体集成上,可参考 LangChain / LlamaIndex 的 Reranker 组件,用 2-3 行代码替换现有 reranker 模型即可。对于需要严格语言对齐的场景(如合同条款检索、医疗文献查阅),可在配置中调节语言一致性权重,实现生产级定制。
局限
- **English-Anchored Multilingual Relevance Distillation** 将英语作为跨语言相关性评分的锚定语言,这隐含假设英语教师模型能提供一致的信号。但对于与英语差异较大的低资源语言(如斯瓦希里语、缅甸语等)或不在训练数据中的语言,蒸馏得到的相关性可能失真,导致 **语言一致性** 偏好错误地压制真实相关性。论文未在足够多样的语言上(尤其是非拉丁语系、形态丰富语言)验证该方法的泛化性,也未讨论当教师模型本身存在语言偏差时如何传播错误。
- **Preference Alignment for Language Coherence** 通过合成平行文档组强制提升同语言文档的排名,但真实多语言 RAG 场景中,用户可能期望获得跨语言信息(例如查询为日语但需要英文技术文档)。此时,语言一致性损失与语义相关性损失可能冲突,模型容易过度偏好同语言结果,抑制高质量的多语言文档。论文虽在消融中调整损失系数,但未系统分析不同权重下的行为,也缺乏对模型在用户实际跨语言需求下的可控性评估。
- 评估使用的 **MIRACL** 等基准中,查询与文档的语言分布天然一致,这可能导致语言一致性收益被高估。在实际检索增强生成管线上,第一阶段的检索器可能带有自身的语言偏好,召回的多语言候选集分布与基准不同。论文仅在模拟的“retrieved candidate sets”上测试,未考察真实检索器(如 mBERT 或多语言 BM25)带来的偏差,也未分析检索阶段语言分布变化对最终重排序的影响。