Oxygen-TryOn:用于任意物品虚拟试穿的时尚原生基础模型
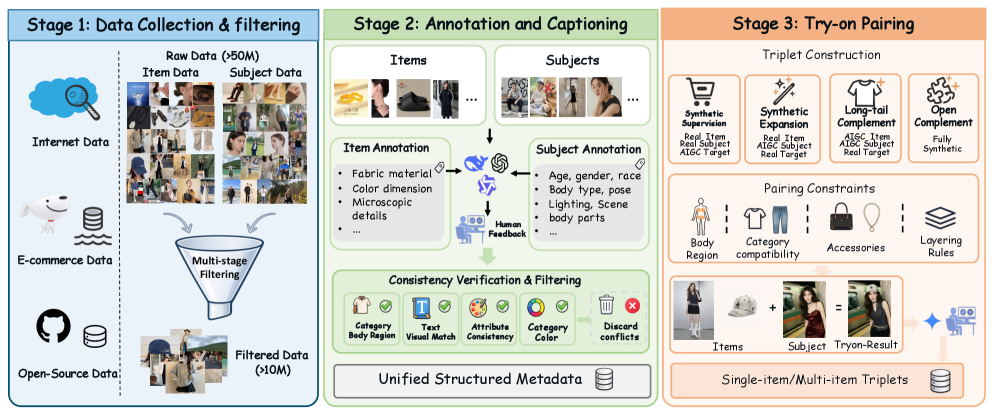
我们提出 Oxygen-TryOn,一个用于任意物品虚拟试穿的统一基础模型。与改造通用图像编辑器不同,Oxygen-TryOn 是时尚原生的,通过专用的数据引擎和试穿特定训练构建。给定一个或多个参考物品(干净的产品图或自然场景中的穿着照片)和单个目标主体图像,它合成主体穿着这些物品的逼真图像,覆盖几乎任何时尚类别。 先前的系统在工作室环境中处理单个服装类别,最近的多参考方法仍以服装为中心;相比之下,Oxygen-TryOn 支持多样化的物品和场景,包括全身和半身视图、可变参考数量以及自由的多物品组合,同时忠实保留主体身份和物品外观。我们不再使用基于遮罩的修复,而是将试穿重新表述为一个多参考、理解驱动的生成任务。我们构建了一个数据引擎,用于大规模收集、制造、标注和过滤高质量的试穿数据,并设计了一个三阶段方案:持续预训练(CPT)、监督微调(SFT) 和强化学习(RL)。 RL 阶段使用混合奖励,结合内部试穿奖励模型和专有的、基于规则指导的通用模型,共同监督细粒度一致性和指令级质量。它还在同一过程中遵循通用编辑指令(例如姿势变化)。在公开基准和我们内部的 Oxygen-TryOn Bench 上,它在单物品试穿上实现了最先进的一致性和逼真度,在多物品试穿上领先,匹配或超越了领先的专有系统(Nano Banana Pro、GPT-Image-2、Seedream5 Lite)和开源模型(FLUX.2)。
论文精读
TL;DR Oxygen-TryOn 是首个 fashion-native 的任意物品虚拟试穿基础模型,将试穿重构为多参考理解生成任务,通过三阶段训练实现高保真身份与物品细节保持,支持多物品自由组合。
问题
虚拟试穿:从单一服装修复到任意物品的语义合成
虚拟试穿(Virtual Try-On)旨在将参考物品(服装、配饰等)自然地“穿”在目标人物身上,生成逼真图像。当前领域核心诉求已从简单换装扩展至 任意品类、多物品组合、复杂场景高保真合成,以支撑电商、虚拟造型等实际应用。
传统方法多将试穿视为 蒙版修复(mask-based inpainting) 任务:首先生成目标服装的掩码区域,再利用修复网络填充。这种范式存在三大局限:
- 品类受限:仅能处理上衣、下装等少数主类,对鞋、包、帽子等配件无能为力;
- 场景单一:依赖干净的工作室人台图像,难以泛化至半身、全身或野外拍摄的复杂背景;
- 细节保真不足:修复过程缺乏对物品结构、纹理的显式理解,易出现图案变形、logo 丢失,且多物品组合时无法合理处理遮挡与层次关系。
近期多参考方法虽支持多件服装,但仍以 服装为中心,未将配件视为独立物品进行理解与合成,且仍沿用修复流水线,限制了跨品类泛化。与此同时,通用图像编辑模型(如基于提示的扩散模型)虽灵活,但缺乏针对时尚领域的专项训练,常出现 人物身份漂移、物品细节幻觉(如生成错误图案或材质),不适合严肃的商业应用。
该问题的难点在于 物品多样性(从柔软的布料变形到刚性的眼镜、包带)、物理合理性(自然的褶皱、悬垂、遮挡)与 身份保持(面部、体型、姿态不变)三者需同时满足。业界对此高度关注,因为时尚电商、虚拟试衣间等产品对此类技术的依赖日益增强,但现有方案在鲁棒性和保真度上仍存在明显短板。
行业类比:这类似于自动驾驶中的多传感器融合——仅拼接摄像头画面(修复)不够,必须引入语义理解(物体检测、场景解析)才能实现安全可靠的决策;虚拟试穿也需要从“填充像素”升级为“理解穿搭语义并合成”。
核心洞察
- 重新定义虚拟试穿任务:从 mask-based inpainting 转向多参考、理解驱动的生成,使模型能推理物品类别、穿戴方式及物理变形,支持任意数量参考和任意场景,解决了通用编辑模型细节幻觉与身份漂移的固有问题,为真实感多物品组合试穿提供了全新范式。
- 时尚原生的专用数据引擎与三阶段训练:通过大规模高质量试穿数据集构建及 CPT、SFT、RL(混合专用奖励与通用奖励)的训练流程,实现对主体身份与物品细粒度纹理的高保真保持,这种面向垂直领域从头构建数据与训练管线的做法,显著优于复用预训练模型的微调方案,为专业场景的生成模型开发提供了工程可复制的路线。
- 统一试穿与编辑的指令跟随:模型在同一推理中不仅能执行多物品虚拟试穿,还能响应姿态变化等通用编辑指令,体现了对时尚生成任务的深度理解,简化了多模型串联的复杂性,拓宽了应用边界,从单一试穿工具升级为综合性时尚生成助手。
方法
输入与任务定义
Oxygen-TryOn 将虚拟试穿重新定义为多参考、理解驱动的生成任务,而非传统的 mask 补全。模型接收一个目标主体图像(Target Subject Image)与一个或多个参考物品图(Reference Items),参考图可以是干净的电商白底图或街拍穿搭图。系统需合成目标主体穿着所参考物品的逼真图像,覆盖服装、配饰、鞋履、包袋等任意时尚品类,并支持全身/半身、可变参考数量及自由多件组合。任务要求精准保留主体身份(人脸、体型等)与物品的细粒度外观(纹理、印花、Logo、廓形)。
模型架构
模型由三个核心组件串联:
- 多模态大语言模型(MLLM):负责解析复杂的试穿指令,理解物品类别、穿着方式、遮挡与叠穿关系,生成控制信号而非简单分割掩码。
- 变分自编码器(VAE)与多模态扩散 Transformer(MDT):VAE 将图像压缩至潜空间,MDT 在潜空间中进行条件生成。扩散过程以主体特征、参考物品特征及 MLLM 的语义理解为条件,逐步去噪生成试穿结果。
- 多参考条件注入:设计专门的交叉注意力模块,将多个参考物品的视觉嵌入与文本表征对齐后注入扩散 Transformer,实现无需掩码的区域感知生成。
训练与优化
训练遵循三阶段配方:
- 继续预训练(CPT):在大规模试穿相关图文对上进一步预训练,使基础模型获得时尚领域先验。
- 监督微调(SFT):使用高质量试穿配对数据进行指令微调,对齐人类意图。
- 强化学习(RL):采用混合奖励模型——融合自研的试穿专用奖励模型(监督细粒度一致性)与一个基于评分量规的通用模型(监督指令级质量)。RL 阶段使模型在保持物品一致性的同时,学会遵循如姿势变换等通用编辑指令。
数据引擎通过采集、合成、自动标注与多重过滤,制造海量且高质量的试穿对,涵盖多视角、多遮挡、多品类的复杂场景,是方法成功的基础。
输出与推理
推理时,给定输入后模型端到端生成输出图像,无需人工指定掩码或额外后处理。系统还能在同一前向过程中响应简单的编辑指令(如“请他抬起右手”),实现内置通用编辑。
与同类方法的差异:区别于将通用图像编辑器(如 FLUX)通过提示工程强行用于试穿的主流方案,Oxygen-TryOn 从数据到训练完全为时尚试穿原生设计,避免了物品细节幻觉与主体漂移,并首次以理解驱动方式解决多物品、复杂穿着的生成问题,而非依赖掩码的局部修补。
实验
实验设计
- 基准选择:在公开的 VITON-HD、DressCode、DeepFashion2 以及自有 Oxygen-TryOn Bench 上进行评测,涵盖工作室拍摄与真实场景(in‑the‑wild)的单件/多件试穿任务。
- 对比模型:与商业系统 Nano Banana Pro、GPT‑Image‑2、Seedream5 Lite 及开源模型 FLUX.2 对比,重点衡量身份保持、物品纹理还原与整体真实感。
- 评估维度:标准学术指标(如 SSIM、FID、KID)结合人工评估,特别针对多物品自由组合与指令跟随编辑(如姿态修改)进行案例研究。
关键发现
- Oxygen-TryOn 在单件试穿的一致性/真实感上达到 SOTA,多件试穿任务显著领先,首次实现上衣、下装、鞋帽、箱包等多种品类的一次性组合生成。
- 相比通用图像编辑器的重构方案,时尚原生设计大幅减少衣物细节幻觉与主体漂移,尤其在野榜测试中纹理、logo、结构廓形保持更准确。
- 三阶段训练配方(CPT→SFT→RL)中的强化学习混合奖励(自研试穿奖励模型 + 通用 rubric‑guided 模型)有效平衡了细粒度一致性与指令级质量控制。
基线对比解读
- 过往方法多为单品类、掩码式修复,面对多物品叠加、遮挡与变形时容易失效;Oxygen-TryOn 将任务重新定义为理解驱动生成,通过多参考编码与自然语言指令推理穿戴关系,实现了更灵活的跨品类泛化。
- 与闭源通用模型相比,Oxygen-TryOn 虽以专门优化见长,但在复杂语义编辑(非试穿类)上仍依赖额外指令;开源对比 FLUX.2 时,在纹理精度与主体一致性上表现更优,验证了领域定制的大规模数据引擎与训练配方的重要性。
行业影响
落地场景
Oxygen-TryOn 可直接嵌入电商虚拟试穿、社交内容创作及虚拟造型推荐等产品线。 电商平台可让用户上传个人照片,同时试穿多件商品(如外套、鞋、包),实时查看整体搭配效果; 时尚类应用可提供“衣橱组合”功能,将用户已有衣物或新品进行多物品自由搭配生成。 该模型支持任意时尚品类和野生拍摄背景,能覆盖从商品详情页到个性化推荐的多种业务触点。
商业价值
- 降低退货率:通过更真实的试穿预览减少“实物与想象不符”导致的退货,直接节约逆向物流成本。
- 提升转化与客单价:多物品搭配展示激发连带购买,可提高单次购物篮价值。
- 削减内容制作成本:无需为每个商品组合拍摄模特棚拍图,大幅减少平面拍摄与后期成本,且能快速响应潮流更迭。
- 增强用户黏性:交互式试穿与分享机制增加用户在平台停留时长,促进复购。
与现有工作流的集成
模型以多参考物品图像 + 目标人物图像为输入,输出高保真合成图,接口友好。 可通过 RESTful API 或模型即服务(MaaS)方式接入现有电商中台或内容管理系统,与商品图像库、用户画像及推荐引擎联动。 其理解驱动的生成范式无需预置掩膜,减少人工标注环节,可直接对接已标注好类别的商品图库,实现零样本新品类扩展。
具体落地用例
- 全球化时尚电商平台:用户选中上衣、长裤、运动鞋及背包后,平台调用 Oxygen-TryOn 生成该用户穿戴全部商品的全身效果图,辅助下单决策。 此流程可与穿搭推荐算法集成,在购物车或愿望清单页面自动生成效果预览。
- 虚拟时尚社交应用:允许创作者上传个人照片并混合使用多个品牌的虚拟单品,一键生成穿搭内容用于分享; 应用可内置“潮流复制”功能,用户上传街拍或 runway 图,模型提取多物品并试穿到自己照片上,驱动 UGC 内容生产。
局限
- 模型在处理极端形变(如大幅度的肢体扭转、复杂褶皱)与多重遮挡(如穿着多层衣物时内侧物品的可见部分)时,可能仍会产生不自然的扭曲或丢失细微纹理,论文未提供针对此类困难场景的专项消融实验,实际鲁棒性有待验证。
- 数据引擎的大规模收集、制造与标注流程高度依赖自动化管线,可能引入系统性偏差(例如对非标准身材、罕见品类或特定肤色群体的表现未充分评估),且在长尾物品类别上的泛化能力缺乏严格量化,影响模型在真实开放场景下的公平性与覆盖面。
- 模型为时尚试穿任务深度定制,其多参考理解生成架构与专用奖励函数虽然带来了同类最佳表现,但也限制了它作为通用视觉生成平台的潜力;与可灵活处理各类编辑任务的大语言模型驱动方案相比,Oxygen-TryOn 难以直接迁移到非时尚领域的生成或编辑场景。