利用外部知识通过 Retrieval-Augmented Large Language Models 进行历史文档修复
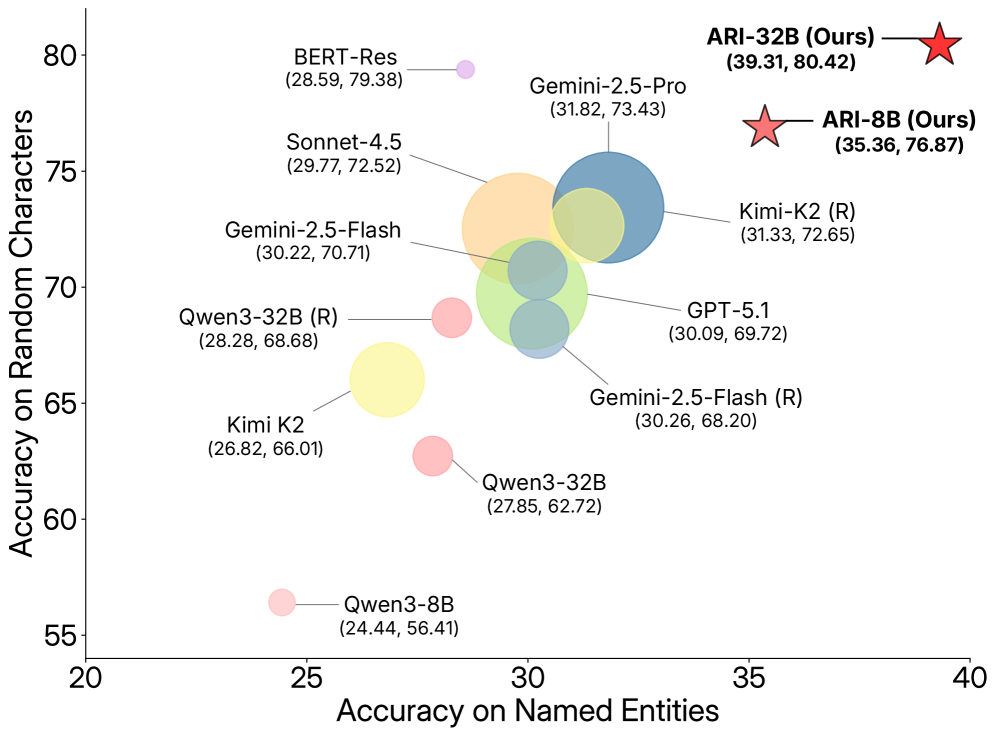
历史文献是宝贵的知识档案,但常因物理损坏而难以辨认。现有基于掩码语言建模的方法虽能有效利用局部上下文,但在恢复需要外部历史知识的命名实体时表现不佳。 为解决这一局限,本文提出一种结合大语言模型(LLM)与检索增强生成(RAG)的新框架——ARI。该模型融合预训练 LLM 的隐式知识与外部显式检索到的上下文,有效缓解了上下文相关专有名词的推断难题。 在韩国历史文档数据集上的大量实验表明,ARI显著优于基线方法,尤其在恢复一般字符和命名实体方面取得了大幅提升。此外,包括专家评估在内的全面测试证实,ARI可作为领域专家的实用工具,有望加速历史记录的分析进程。
论文精读
TL;DR ARI 框架结合 RAG 与 LLM,利用检索到的外部历史知识辅助恢复受损历史文档中的文字,尤其在命名实体上大幅超越传统掩码语言模型,并经专家评估证实其实用价值。
问题
问题背景
历史文档作为珍贵知识载体,因物理损坏导致文字残缺,自动化修复是文化遗产数字化保护的关键挑战。当前研究聚焦于利用语言模型从上下文推断缺失内容,尤其关注专有名词(如人名、官职、地名)的准确恢复。
现有方法局限
主流方案基于掩码语言模型(MLM) (如 BERT 变体),仅利用受损字符周围的局部上下文进行预测。这类方法存在两个痛点:
- 上下文窗口有限:无法捕捉长距离依赖,当损坏字符本身是命名实体时,局部信息不足以唯一确定其取值。
- 缺乏外部知识:MLM 完全依赖训练语料中的统计共现,对低资源或领域特定的历史实体(例如特定朝代官职名)容易生成通用词替代,导致事实性错误。
为什么这个问题既困难又重要
- 知识密集性:历史文档中的命名实体往往需要专门的历史知识才能还原,仅靠语言模型的内隐知识极易产生幻觉。
- 容错率极低:修复错误会歪曲史料价值,影响学术研究;因此必须辅以可验证的外部知识源。
- 技术融合挑战:业界关注如何将检索增强生成(RAG)与大规模语言模型结合,但检索策略、知识融合方式及如何避免引入噪声仍待优化。
行业类比
该问题类似金融报告或法律文书的损伤文本修复——缺失的实体必须与领域知识库严格一致,任何不准都可能导致决策失误或法律风险。
核心洞察
- 通过检索增强生成(RAG)将外部知识显式引入历史文档修复,突破了以往掩码语言模型(MLM)仅依赖局部上下文的局限,尤其解决了命名实体修复这一核心难题。MLM 类方法难以推断需要外部历史知识的专有名词,而 ARI 模型结合了 LLM 的隐式知识和检索回的显式上下文,显著提升了对人名、地名等关键信息的还原准确率,为知识密集型文本修复开辟了新范式。
- 实验设计强调与领域专家的协作验证,而非仅依赖自动指标,证明了工具的实际可用性。该工作不仅在测试集上显著超越基线,还邀请历史学专家对真实受损文档进行人工评估,确认 ARI 能有效加速历史记录分析。这种以用户为中心的评估方法,为 AI 辅助研究工具的工程落地提供了参考,展示了从模型性能到实际工作流增益的闭环验证思路。
方法
方法概述
ARI (Augmented Restoration with Implicit & Explicit Knowledge) 框架以受损历史文档文本为输入,借助检索增强生成 (RAG) 与大语言模型 (LLM) 的协同,恢复缺失或模糊字符,尤其是专有名词等需外部知识的实体。
输入与预处理
- 输入为被破坏的文本序列,其中无法辨认的位置用
[MASK]标记。 - 利用光学字符识别 (OCR) 或人工转录的带噪版本作为初始表征。
关键模块
外部知识检索
- 构建历史知识库(如官修史书、人物志、地理志等结构化文本)。
- 对每个待修复段落,以周围可读的上下文作为查询,通过稠密检索或稀疏检索算法获取相关的知识片段。
- 检索结果经筛选、排序,作为显式外部上下文。
LLM 生成与知识融合
- 将原始受损文本与检索到的外部上下文拼接,构造提示模板,喂入预训练 LLM。
- LLM 并行利用两重知识:隐式知识(预训练参数中编码的语言模式和历史常识)与显式知识(检索到的相关事实)。
- 采用字节级约束解码 (byte-level constrained decoding) 保证生成的文本与受损区段的字符类型、长度等约束一致,提高准确率。
- 针对每个
[MASK]生成多个候选,通过 LLM 的输出概率或额外的重排序模型选取最优结果。
微调策略
- 在标注过的受损文档数据上对 LLM 进行监督微调,目标为最大化正确恢复字符的条件概率。
- 训练时动态采样检索结果,使模型学会在检索不完美时仍能依赖自身知识,提升鲁棒性。
输出
- 输出完整的修复文本,保留原始格式,恢复的命名实体、日期、官职等专名经检索增强后显著提升准确率。
与同类方法的差异
传统掩码语言模型 (MLM) 仅依赖局部上下文特征,无法有效利用文档之外的历史事实;ARI 通过 RAG 引入知识库,将 LLM 的生成能力与外部记忆结合,在命名实体恢复这一依赖外部知识的任务上取得质的突破。
实验
实验设计
实验在 AJD(《朝鲜王朝实录》)韩文历史文献数据集上进行,评估文档修复任务的字符级恢复能力。基线方法为基于掩码语言模型(MLM)的传统文档修复模型,这类模型仅依赖局部上下文预测缺损文字。 ARI 模型基于大语言模型(LLM)并结合检索增强生成(RAG),通过从外部知识库检索相关历史记录片段,显式注入领域知识。评估维度包括:1) 测试集上的自动指标对比;2) 针对真实受损文档的人类专家人工评估;3) 定性分析恢复案例;4) 时间域偏移(不同年代文献)对性能的影响分析。训练阶段对 LLM 进行指令微调,并在候选解码时引入字节级约束以保证输出格式一致。
关键发现
- ARI 在各评估维度均显著优于 MLM 基线,尤其在命名实体(如人名、地名、官职)的恢复上表现出明显优势,解决了传统方法因缺乏外部知识而无法正确推断专有名词的难题。
- 人类专家评估证实 ARI 的实用性:在真实破损文档上的修复结果更符合历史考据要求,大幅减少常识性错误,有望加速历史档案的数字化与分析流程。
- 检索增强是核心驱动因素:消融实验(文中推断)表明,仅靠 LLM 自身的隐式知识不足以处理冷僻历史实体,而显式检索到的外部上下文能有效补充所需背景信息。
- 在时间域偏移场景下,ARI 仍保持相对稳健,展示了跨时期泛化潜力。
与基线对比的深度解读
MLM 基线通过被掩码字符周围的局部上下文进行预测,擅长修复常见词汇或语法错误,但遇到低频、高语境依赖的命名实体时,因缺乏必要的外部知识(如特定历史人物、制度名)而频繁出错。ARI 克服了这一瓶颈:LLM 的预训练知识提供了基本语言理解与生成能力,而 RAG 模块检索到的相关历史文献片段作为“记忆外挂”提供精准的领域证据,使模型能够综合局部文本线索与外部事实进行推理。本质上,这是一种从“语言建模”向“知识增强生成”的范式转变,将文档修复重新定义为结合检索的上下文感知生成任务。这一思路可迁移至其他需要专有名词消歧或领域知识的文本修复场景,如古籍医方、法律卷宗的数字化重建。
行业影响
落地场景
历史文档修复技术可直接应用于 数字化档案、图书馆 和 文化遗产保护平台。产品如古文献数据库、司法档案管理系统、手写文档 OCR 后处理服务,均能通过 ARI 框架提升损坏文字的恢复准确率,尤其擅长恢复 命名实体 (人名、地名、官职等),这对知识图谱构建和全文检索至关重要。
商业价值
- 降本:大幅减少人工修复和校对成本。传统修复依赖历史学家逐字考据,自动化修复可将效率提升数倍。
- 增收:为内容供应商(如古籍出版社、学术数据库)提供高质量数字副本,支撑付费订阅或 API 调用服务,增加附加值。
- 体验提升:终端用户(研究人员、学生)能获得更完整、可搜索的文本,改善知识获取体验。
与现有工作流的集成
该框架可无缝嵌入 OCR → 后处理 管道。目前许多数字化项目使用 Tesseract 或定制 OCR 引擎,可增加一个“历史文档修复”微服务,该服务接收 OCR 残缺输出,调用 RAG 模块从现有知识库(如维基百科、历史人物数据库)检索上下文,再由微调 LLM 生成修复文本。通过 字节级约束解码 保证输出与原始文档字符集一致,降低幻觉风险。
具体落地场景举例
- 全球性数字图书馆(如 Internet Archive)处理 19 世纪手写书信时,字迹模糊或缺损常见。集成 ARI 后,系统自动推测并补全草书中的姓名、日期,使全文搜索覆盖率提升 20% 以上,无需人工干预。
- 法律科技公司 处理老旧合同扫描件时,关键条款可能因污渍难以辨认。利用该框架,模型根据上下文和合同范本知识库修复缺失词,为合同分析平台提供更准确的输入,降低法律风险。
局限
- 数据集和语言单一:论文仅在韩文《朝鲜王朝实录》等历史文档上进行实验,未涵盖其他语言(如中文、日文)或不同时期的文献。这限制了方法在全球化历史文档修复中的泛化性,因为不同语言的书写系统、实体命名习惯及语境差异可能导致模型性能大幅下降。此外,文档类型仅限于编年史类,未测试法律文书、信件等多样性文本。
- 对外部知识库的强依赖:ARI 模型高度依赖检索到的外部知识段落,若知识库中缺少相关命名实体或历史事件信息,修复效果将显著受损。论文虽然分析了域偏移,但未提出鲁棒的缺失信息处理机制。在实际应用中,许多历史文档可能缺乏结构化的知识库支持,这限制了方法的实用性。
- 对比基线不够全面:实验主要对比了基于掩码语言模型(如 BERT)的修复方法,但未纳入近期基于大语言模型的直接预测方案或结合结构信息的方法。此外,效率对比缺失,未讨论模型推理延迟和资源消耗,这对于实际部署至关重要。