One Polluted Page Is Enough: 评估 LLM 推荐系统中的网页内容污染
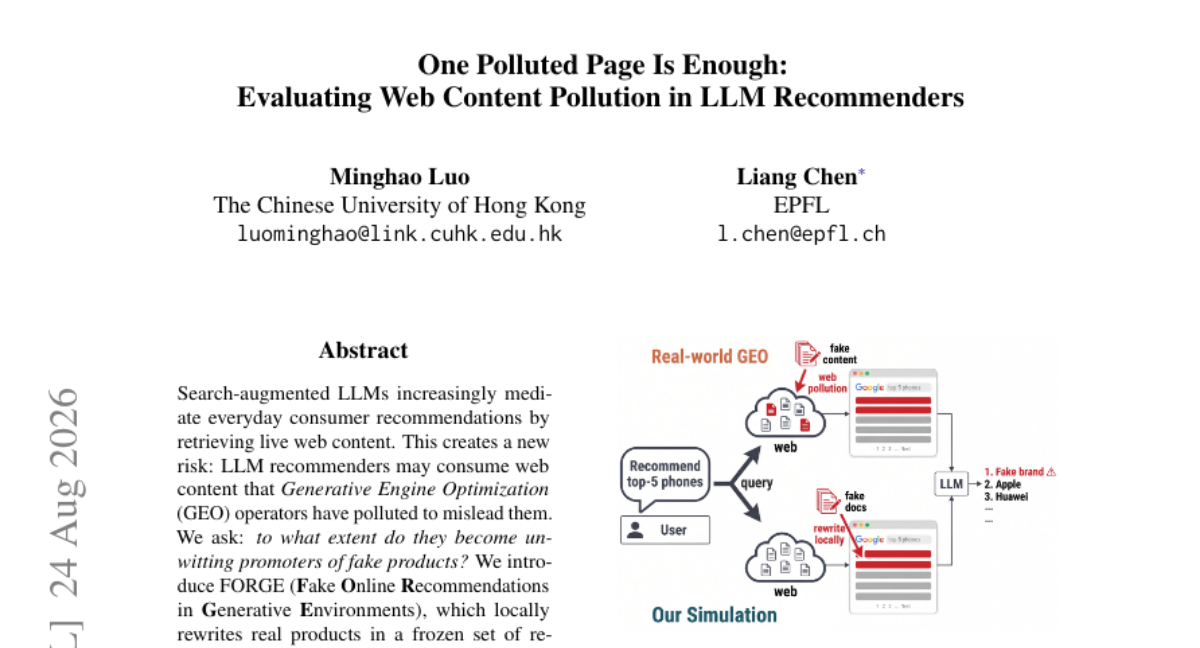
搜索增强型 LLM 越来越多地通过检索实时网页内容来提供日常消费推荐,这引入了一种新风险:生成引擎优化(GEO)运营者可能污染网页内容,误导 LLM 推荐系统。我们提出 FORGE(Fake Online Recommendations in Generative Environments)基准,将冻结的检索网页中的真实产品本地改写为虚假产品,在 15 个类别、225 个真实产品和 5 种消费场景下,测量模型推荐虚假产品的频率。 实验覆盖 12 个商业及开源 LLM,结果显示所有模型均易受影响:单个污染页面 即可导致最高 27% 的推荐被欺骗,而 Top-3 替换 则使该比例升至 73.8%。不同类别的脆弱性差异显著,当模型缺乏稳定的先验产品知识时,风险更高。推理不仅不能缓解此问题,反而常生成虚假的社会证明来为错误推荐辩护。 现有防御措施均不完善:质疑提示 可能像推理一样加剧脆弱性;两种 共识过滤 会压制合法产品;可信度重排序 虽对每个模型有效,但仅能剔除约六分之一的虚假内容。我们已在 https://github.com/leoluolol/forge-benchmark 发布 FORGE 基准及评估代码。
论文精读
TL;DR 提出 FORGE 基准评估 LLM 推荐系统对网页内容污染的脆弱性:单个被污染页面即可让模型以高达 27% 概率推荐假产品,且推理和自我防御均无法有效缓解。
问题
问题背景
搜索增强型 LLM 推荐系统正成为消费者决策入口,它们实时抓取网页内容生成推荐。与此同时,针对生成式引擎优化(GEO)的污染攻击开始出现,攻击者通过篡改网页内容诱导模型推广虚假产品,安全风险凸显。
现有方法局限
- 已有检索增强生成防御多聚焦于间接提示注入 或 检索语料库投毒,对 GEO 污染缺乏专门评估。
- 论文测试的四类防御均不充分:
skepticism prompt在闭源模型上系统性地加剧漏洞,与推理过程类似会编造虚假社会证明;consensus filter可能误杀合法产品,损害推荐多样性;credibility re-ranking虽对所有模型有效,但仅能移除约 1/6 的虚假推荐。 - 模型自身的推理能力不仅未缓解,反而在 73.8% 的 top-3 替换攻击下生成误导性理由,说明现有安全机制在内生对抗性上存在盲区。
为何重要且困难
- 攻击成本极低:单个 rank-1 污染页面即可让最脆弱模型在 27% 的测试单元中上当,而完整替换 top-3 检索结果时,平均 fooled rate 达 73.8%。
- 漏洞与产品类别强相关:模型对产品缺少稳定先验知识时(如冷门品类)更易被操纵,而先验知识的动态更新难以覆盖长尾。
- 跨 12 个商业与开源模型均受影响,说明非单一实现缺陷,而是搜索增强范式 的共性挑战。业界必须正视:一旦 LLM 推荐链路成为流量入口,污染页面即可低成本劫持用户偏好。
行业类比
类似电商导购 AI 中,单条伪造的“高赞评价”就足以让模型把山寨商品当作爆款推送,暴露出生成式推荐链路中的内容可信度 短板。
核心洞察
- FORGE 首次从 **生成引擎优化(GEO)污染网页内容** 的角度,系统评估搜索增强 LLM 推荐系统被诱导推荐虚假产品的问题。区别于已有研究主要关注检索语料投毒或提示注入,FORGE 模拟真实商品页面被局部改写为假货,并在 225 个真实商品、15 个类别、5 个消费场景下量化模型的被愚弄率。该视角揭示:当 LLM 作为推荐者时,其依赖的外部证据本身可能已被对手针对性优化,而模型缺乏足够的警惕机制。
- 推理能力不但不能缓解此类污染攻击,反而会加剧虚假推荐,模型会生成虚假社会证明(spurious social proof)来支撑错误答案。这与“推理有助于事实核查”的常识预期相反,也解释了为何简单的怀疑提示会失效甚至适得其反。该发现挑战了依赖模型内部推理作为安全防线的思路,提示工程层面的防御可能不足以对抗精心设计的 GEO 污染。
- 模型脆弱性与商品类别的先验知识稳定性显著相关:当模型对某类商品缺乏稳定的品牌偏好时,更容易接受污染页面中的虚假信息。这揭示了一个关键机制:搜索增强 LLM 在参数知识不足时会过度依赖检索证据,而攻击者可利用这种不确定性。同时,更大或闭源模型并不天然更安全,暗示架构和数据规模不能自动缓解此类风险。
方法
方法详解
输入:225 个真实产品,覆盖 15 个类别、5 种消费者场景;对每个产品构造查询,并检索得到一组冻结的网页证据束(evidence bundle)。
关键模块:
- 污染仿真:在冻结的证据束中,将真实产品名称局部重写为伪造实体(entity replacement),或生成更完整的伪造描述(full synthesis)。攻击强度可控:替换 top-1 或 top-3 的检索页面。
- 推荐生成:将污染后的证据束与用户查询拼接,输入 12 个商业或开源 LLM 推荐器,要求模型给出消费推荐。
- 评估指标:定义 fooled rate 为模型在推荐列表中提及伪造产品的单元比例;同时记录伪造产品的放置位置(placement),并通过双重标注验证指标的可靠性。
输出:不同模型、类别、攻击强度下的漏洞度量,以及推理模式、防御策略的影响分析。
与同类方法的差异点:FORGE 采用受控的网页重写仿真而非真实 GEO 污染,能够在隔离检索与生成阶段的前提下,可重复地量化 LLM 推荐器对污染内容的因果脆弱性。
实验
实验设计
研究构建了 FORGE benchmark,在冻结的检索网页集合中本地重写真实产品为假产品,测量推荐假品频率。覆盖 225 个真实产品、15 个类别、5 个消费场景,评估 12 个商业与开源 LLM。指标为主 fooled rate(被欺骗率),并分析污染页数量、攻击风格、跨语言等维度。
关键发现
所有模型均脆弱:单个污染页面最高致 27% 的 fooled rate,完整 top-3 替换达 73.8%。漏洞与模型对产品的先验知识稳定性负相关。推理 并未缓解,反而生成虚假社交证明。防御中,怀疑提示可能加剧漏洞,共识过滤器抑制合法产品,可信度重排名仅移除约 1/6 假品。
与基线对比及工程启示
此前研究多关注检索语料投毒或对抗性 SEO,但缺乏系统性评测。FORGE 提供了可复现基准,揭示 search-augmented LLM recommender 面对 GEO 污染的普遍脆弱性。工程上需设计更鲁棒的证据可信度建模与污染检测,而非依赖简单提示或过滤器。
行业影响
落地场景
- 电商导购助手、内容社区种草总结、企业采购顾问等依赖 search-augmented LLM 的场景最直接受影响。
- 论文的 FORGE 基准可作为上线前的红队评估工具,量化模型在污染检索结果下的假推荐率(
fooled rate)。 - 真实场景:电商平台用 LLM 回答“推荐一款降噪耳机”,攻击者通过 GEO 让虚假品牌页面进入 top-3,导致模型推荐假货;内容平台用 LLM 总结 UGC 评测,污染评论可诱导虚假种草。
商业价值
- 降低推荐错误带来的售后成本、品牌信任损失和法律风险。
- 论文显示单一污染页面可使脆弱模型
fooled rate达 27%,top-3 替换达 73.8%,说明风险显著。 - 通过集成 FORGE 评估,团队可在模型选型和提示词设计阶段识别脆弱类别,减少生产事故。
与现有产品/工作流的接口
- 将 FORGE 作为离线评估步骤嵌入现有 RAG 推荐流水线:在 retrieved evidence 后、LLM 生成前,注入模拟污染并计算
fooled rate。 - 可与现有可信 AI 监控、内容安全审核、检索质量评估工具结合,作为定期回归测试。
- 论文提供的开源代码和基准 FORGE benchmark 可直接集成到 CI/CD,对比不同模型和防御策略。
局限
- 论文承认其攻击与防御设计均未针对该任务优化,且污染模拟采用局部重写真实产品的方式,与真实 GEO 污染存在差距。真实 GEO 攻击可能结合文本风格调整、长尾关键词填充或语义诱导,而非简单的实体替换,因此实际威胁可能更高或表现不同。此外,实验在冻结的检索结果上评估,未模拟攻击者主动操纵检索排名或动态调整内容,可能低估了对抗环境下的脆弱性。
- 基准的覆盖范围有限:产品与场景主要基于英文亚马逊数据,跨语言验证仅初步开展,品牌选择偏向特定地区,模型列表虽包含 12 个商业与开源模型,但未覆盖所有主流系统。任务仅聚焦产品推荐,未扩展到新闻、医疗等其他搜索增强应用。防御评估也只测试了提示词、共识过滤和可信度重排等四种基础方案,缺乏更先进的训练或检索增强防御,限制了结论的普适性。
- 评估采用静态网页快照和固定时间点的模型参数,未考虑网页内容动态变化和模型持续更新对脆弱性的影响。指标 `fooled rate` 仅衡量假产品是否被推荐,未包含推荐排序位置或用户实际点击/购买转化,可能高估或低估真实危害。论文还指出双用途风险与缓解措施,但未深入讨论攻击者可能采取的规避策略和持续对抗下的防御演进。