面向异构多任务强化学习的 GPU 并行框架
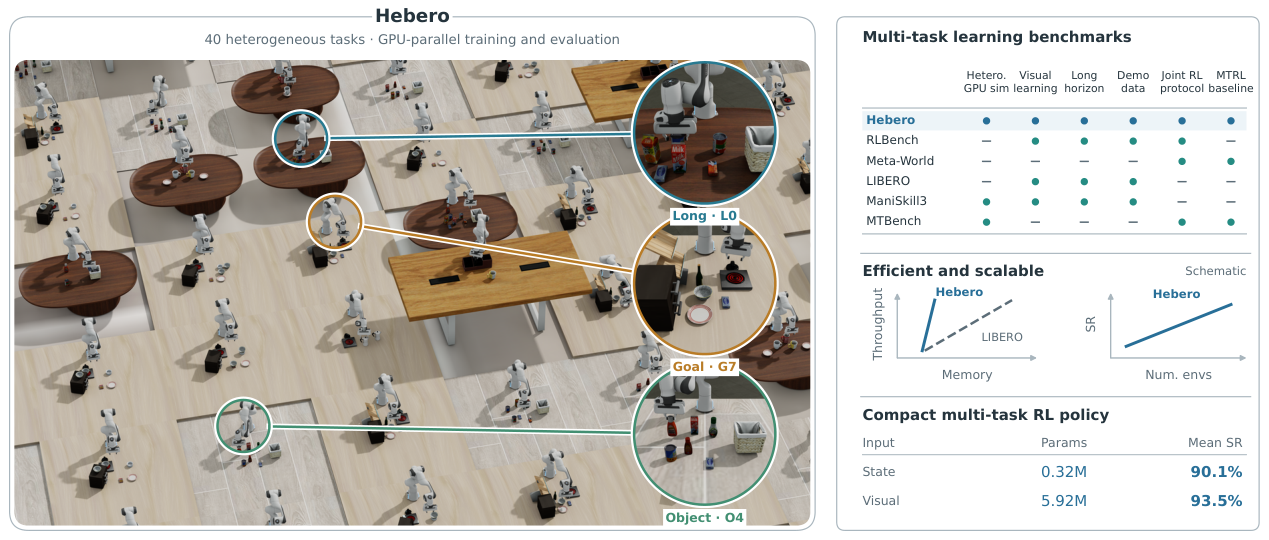
GPU 并行仿真能提供海量机器人交互数据,但现有基准很少把这种规模与异构操作任务、以及标准化的多任务强化学习评估结合起来。 为此,作者提出 Hebero(Heterogeneous Benchmark for Robot Learning),一个基于 Isaac Lab 的 GPU 并行基准,可在全部 40 个异构任务上高效联合训练并评估单一策略。扩展实验显示,在固定 wall-clock 预算下,增加每个任务的并行副本数能提升成功率。为应对稀疏奖励与有限示教,进一步提出 DGPO(Demonstration-Guided Policy Optimization),复用示教来构建密集跟踪奖励与非对称价值学习;其共享技术栈支持在 PPO 内对各 learner 特有的示教接口做受控对比。 在 DGPO 框架内,作者提出 IW-ABC:用轻量的逐任务学习进度信号来协调 ABC 与 IW 两种机制,前者(自适应行为克隆)随任务进展放松示教引导,后者(重要性加权)在 PPO 更新中侧重落后任务。 每任务仅 50 条示教时,IW-ABC 取得 90.1% 的状态输入平均成功率,比最强基线 FAMO-ABC 高 7.8 个百分点;其视觉版本达到 93.5% 平均成功率。真实世界实验进一步表明,在仿真中训练的单一多任务策略可成功驱动实体 Piper 机器人完成四个任务。
论文精读
TL;DR 提出 Hebero 基准与 DGPO 框架,在 GPU 并行仿真中联合训练 40 个异构机器人任务,仅用 50 个演示达到 90%+ 成功率,并完成实机验证。
问题
问题背景
机器人学习正加速转向 GPU 并行仿真 以获取海量交互数据,多任务策略训练要求基准覆盖异构操作、统一接口并支持标准化评估。
现有方法局限
- 任务同质化:多数基准仅在同一机械臂上变换物体位姿或单一技能,异构任务 的动作空间、观测模式与奖励函数差异大,难以直接联合训练。
- 计算资源瓶颈:GPU 并行模拟大量环境时,若每个任务独立实例化资产和物理上下文,内存占用高、吞吐受限;现有框架缺乏对异构向量化仿真的优化。
- 演示利用低效:传统行为克隆固定权重或需要复杂多目标优化(如 FAMO),在稀疏奖励下无法根据任务学习进度自适应调节引导强度,导致简单任务过拟合、困难任务欠拟合。
为什么这个问题难/重要
- 任务干扰:异构任务梯度方向冲突,联合优化容易牺牲部分任务成功率。
- 稀疏奖励探索:长时序操作任务奖励稀疏,纯 RL 从零探索代价极高,必须借助演示但不完全依赖。
- 可扩展部署:工业界需要单策略在真实机器人上执行多任务,而仿真训练必须同时满足高吞吐、低内存和标准化评估,对系统架构要求严苛。
类比:类似大模型多任务指令微调 中,需动态平衡不同任务的数据比例与损失权重,防止模型偏向高频或简单任务。
核心洞察
- Hebero 将 GPU 并行仿真与异构多任务机器人操作结合起来,提供了一个标准化的多任务 RL 基准。与以往只关注同质任务或缺少统一评估接口的基准不同,它构建了 40 个异构操作任务,并定义了统一的动作空间、观测和奖励接口,使单个策略能够高效地联合训练和评估。其规模化实验进一步表明,在固定墙钟预算下增加每个任务的并行副本数可以提升成功率,这为大规模 robot learning 的资源分配和训练效率提供了直接的工程参考。
- DGPO 框架将演示引导与多任务学习解耦为可替换组件,并提出 IW-ABC 方法,用轻量级任务进度信号协同自适应行为克隆与重要性加权。其核心差异在于:行为克隆强度随任务进展动态衰减,同时 PPO 更新偏置向落后任务,从而缓解稀疏奖励下的演示过度依赖和多任务梯度冲突。在每任务仅 50 条演示下,IW-ABC 取得 90.1% 的状态输入平均成功率和 93.5% 的视觉平均成功率,比 FAMO-ABC 提升 7.8 个百分点,并成功迁移到真实机械臂执行四个任务,展示了有限演示下单一多任务策略的部署潜力。
方法
输入:每个任务提供 50 条状态-动作演示轨迹、任务观测(状态或视觉)、任务编码以及仿真交互数据。
关键模块:
- 演示轨迹命令流:将演示中的状态/动作序列转换为时间索引的目标命令,生成密集跟踪奖励,替代稀疏奖励信号。
- 非对称评论家:评论家网络接收额外信息(如目标物体姿态、演示信息),而演员仅使用自身观测,提升价值估计精度。
- 自适应行为克隆 (ABC):使用轻量级每任务学习进度信号(如当前成功率)动态调节行为克隆损失权重,任务初期强引导,随任务掌握逐步减弱。
- 重要性加权 (IW):在 PPO 更新中根据各任务最新成功率调整采样权重,使训练更关注滞后任务,改善多任务平衡。
- PPO 共享策略栈:所有任务共用同一策略网络,通过任务编码区分,支持同时训练 40 个异构任务。
输出:单一多任务策略,可处理状态输入或视觉输入,并在真实机器人上执行多个操作任务。
与同类方法的差异:与基于损失平衡的 FAMO-ABC 不同,IW-ABC 将基于学习进度的自适应行为克隆与基于任务滞后的重要性加权结合,避免静态权重调参,实现更优的多任务收敛速度和最终成功率。
实验
实验设计
在 Hebero 基准上,研究者构建了40个异构操作任务,统一到单一策略的联合训练与评估。实验使用 DGPO 框架,每个任务仅提供50条演示,分别在状态输入和视觉输入两种设置下对比 IW-ABC 与基线 FAMO-ABC。扩展实验考察了增加每任务并行副本数量对固定墙钟预算下成功率的影响。最后,将训练好的多任务策略部署到实体 Piper 机器人,验证四个任务的 sim-to-real 迁移。
关键发现
- IW-ABC 在状态输入下达到 90.1% 平均成功率,比最强基线 FAMO-ABC 高 7.8 个百分点。
- 视觉输入的对应版本达到 93.5% 平均成功率。
- 扩展实验表明,增加并行副本能提升固定时间内的学习效率。
- 实体机器人实验成功完成全部四个任务,证明单一多任务策略的实用性。
与基线的对比解读
IW-ABC 的核心优势在于利用轻量级每任务学习进度信号协调 自适应行为克隆(ABC)与 重要性加权(IW)。ABC 随任务进度减弱演示引导,避免过度约束;IW 则对滞后任务给予更高更新权重,缓解多任务学习中的任务不平衡。与 FAMO-ABC 相比,这一组合更有效地利用了有限演示和稀疏奖励,带来显著提升。视觉版本成功率更高,可能因为视觉特征提供了更丰富的任务判别信息。
行业影响
落地场景
Hebero 基准和 DGPO 框架适用于需要单一策略处理多种异构操作任务的机器人产品,如:
- 电商仓储自动化:单一策略同时处理抓取、插入、堆叠等 40 类任务,覆盖多 SKU 分拣与装箱,无需为每个 SKU 单独训练模型。
- 医疗辅助机器人:在病房或家庭场景中,统一策略可执行递送物品、开关柜门、辅助穿衣等不同操作,降低部署与切换成本。
商业价值
- 降本:GPU 并行仿真可在固定 wall-clock 预算内提升成功率;IW-ABC 仅需 50 条示教即可达到 90.1% 状态输入成功率,显著减少真实示教采集成本。
- 增效:单一多任务策略替代多个任务专用模型,减少推理服务器数量和版本管理开销;同时避免了任务切换时的模型重新加载和策略间歇。
- 体验提升:视觉版本达到 93.5% 成功率,并成功部署于物理 Piper 机器人,证明 sim-to-real 可行性,可提升机器人产品可靠性。
与现有产品/工作流的接口
- 仿真端:Hebero 基于 Isaac Lab,可作为现有 GPU 并行 RL 训练流水线的标准基准和训练框架,无缝替换现有单一任务训练脚本。
- 学习接口:标准化 action space / observation / reward 设计使其易于对接企业已有 PPO 实现或开源 RL 库(如 rllib / CleanRL)。
- 部署端:策略可导出为 ONNX/TensorRT 运行在边缘设备(如 Jetson),通过 ROS 2 话题订阅相机与本体状态;论文已展示在 Piper 机器人上的四任务执行,可作为迁移参考。
局限
- **真实世界验证有限**:论文仅在物理 Piper 机器人上验证了四个任务,与基准中 40 个异构任务的规模相比,sim-to-real 迁移的泛化性证据不足。视觉输入的成功率(93.5%)虽高于状态输入,但论文未充分讨论视觉输入的 sim-to-real 差距及域随机化策略,实际部署时可能面临更大挑战。此外,每任务需 50 条演示,对新任务的采集成本仍较高,演示质量会直接影响 IW-ABC 的性能。
- **任务异构性边界**:Hebero 的 40 个任务虽涉及不同物体与操作技能,但全部基于 Isaac Lab 中的机械臂操作,动作空间统一为末端执行器控制,可能未覆盖移动操作、多臂协作或接触丰富等更广泛场景,限制了策略在真实世界复杂任务上的泛化评估。同时,GPU-parallel 框架的内存与计算开销未与现有轻量级基准(如 Meta-World)进行详细对比,在资源受限环境下的可部署性存疑。
- **方法依赖演示与 PPO**:DGPO 及 IW-ABC 构建于 PPO 之上,并假设每任务至少有 50 条演示,而 FAMO-ABC 等基线可能同样依赖演示,但消融实验中未系统分析演示数量对性能的影响。多任务学习中的负迁移问题未深入剖析,IW-ABC 的重要性加权机制在某些任务分布下可能失效,论文缺少失败案例的定性分析,难以评估方法在极端任务不平衡下的鲁棒性。