星海图展出VLA模型G0.5 具身智能聚焦泛化精度效率
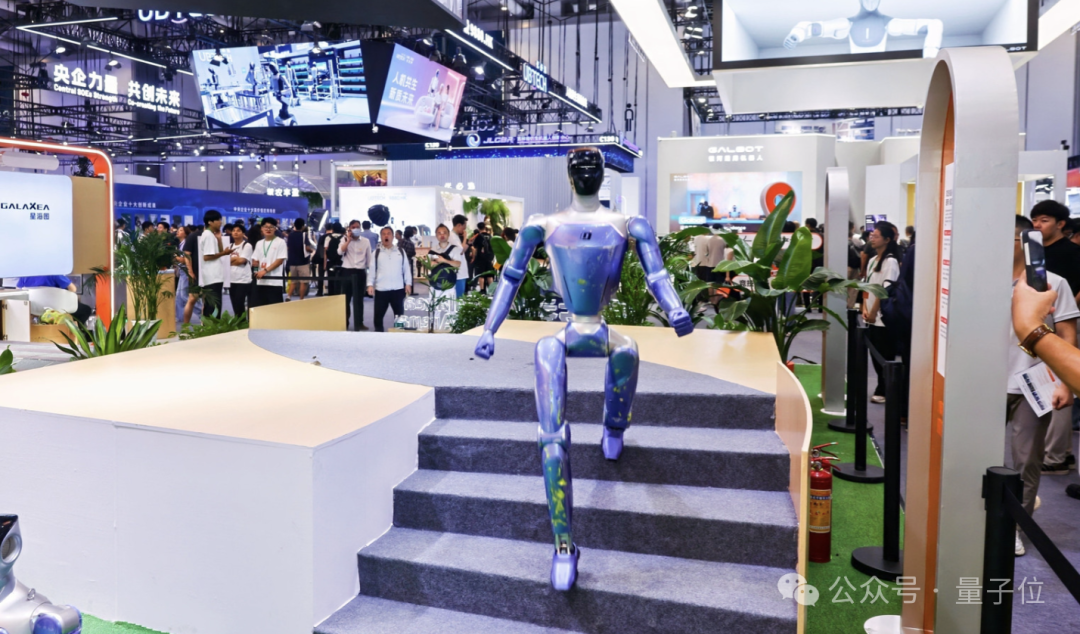
星海图用VLA模型G0.5把机器人自主性往前推了一步,强调泛化、精度、效率三者兼顾,值得关注。
星海图在WRC展台展示具身智能新进展,其VLA模型G0.5(视觉语言动作模型,统一自回归架构)在多个权威基准测试中登顶,实现百万SKU泛化和1mm级精度,推理延迟降至约190ms。公司强调全栈自研和数据飞轮,推动机器人从自主干活迈向快准稳的生产力。
正文摘录
今年 WRC 最大展台,预告具身智能未来 就算绕着展台兜了一圈,没找到人,很快也会发现,机器人来来回回演示的,多半还是提前编好的一套“公式动作”。 各家展台上,自主干活几乎成了标配,后面拿着遥控器的人明显少了,就算偶尔还能看到遥操作,多半也是在采数据。 老实说,虽然目前机器人自主干活仍然不甚丝滑,而且难免会看到抖动、抽搐、失败,但起码,这活真是机器人自己干的,实乃一大进步。 不过逛了一圈之后,我们又发现,事情显然还没结束。因为机器人自己把活干起来,只能证明它有了“自主性”。 500 平方米,10 组 Demo,一排机器人同时开工。从前置仓、工业装配、礼盒折叠,到双足、轮式新品,几乎把机器人真正进入生产现场之后会碰到的几类问题,都搬到了一个展台上。 还有,当整个行业都开始强调“自主干活”之后,星海图又想把具身智能往前推到哪一步? 就在我们以为是瓶子太重、太粗不好夹的时候,机器人调整了几次动作,最后还是成功放了上去。 货架没有为了方便机器人抓取而刻意摆开,从下单、抓取,到移动、打包、交付,整套流程都由机器人端到端完成。 机器人在这里既需要完成长程规划,移动操作,“下蹲抓取”,也涉及到对不同 SKU、塑料袋这类刚性和柔性物体的交互。 为此,星海图在基础模型之上引入强化学习,将操作精度做到 1mm 以内、成功率 99.9% ,同时把工作效率提升了 400% 。 这里的难点在于,纸板和刚性零件不一样:折过去会回弹,状态一变,后面的动作也得跟着变。 但 G0.5 可以根据纸盒的实时状态调整动作,我们在现场站了一会,成功率已经没的说了。 毕竟,以后机器人真进了家庭、工厂和仓库,能不能走过没见过的路,本身也是泛化的一部分。 早在 2023 年,联合创始人赵行团队的 Robot Parkour Learning,就曾入选 CoRL 2023 Oral,并跻身最佳系统论文候选 Top 3;