colibri
纯 C 写的 MoE 推理引擎,把 VRAM/RAM/NVMe 视作统一的三级存储层次,按路由热度把专家权重分片流式加载,让 744B 到 2.8T 的稀疏模型跑在已有的消费级硬件上。八个模型家族各一个 .c 文件加共享头文件,零依赖、不强制 GPU,还带可视化专家路由的 web dashboard,适合做推理系统层实验。作者明确表示不承诺速度 SLA,只保证不静默改动模型精度与 router 语义。
README

网站 · Discord · English · 简体中文 · 繁體中文 · Italiano
微小引擎,巨大模型。 在消费级与异构硬件上运行前沿 MoE 模型——744B 到 2.8T 参数,纯 C 实现,引擎零依赖——办法是把存储、RAM 与 VRAM 当作统一的推理层级(AI 内存多级分层)。
目前已有八个家族可以运行:GLM-5.2/5.3(744B)、GLM-5.3-Flash(321B,含视觉)、Inkling(975B)、Kimi K3(2.8T)、DeepSeek V4 Flash(284B)、Qwen3.8-Flash-Next(125B + 51B n-gram)、Qwen3.6(35B-A3B)以及 OLMoE(7B)——
每个只需一个 C 文件,共用同一套 coli chat / coli serve / coli web 前端。
完整名单 ↓
Colibrì 是一个今天就能跑的推理引擎,也是一个开放的研究平台。 它的首要目标是在整个软硬件边界上追求推理侧的性能——模型格式、内存层级、存储 I/O、放置策略、调度、kernel、投机解码以及 CPU/GPU 重叠——从而让大模型对稀缺硬件的依赖更少、运行成本更低。
Colibrì 把 VRAM、RAM 与存储视为单一的多级层级,并且刻意作为测试激进系统设想的地方——因此没有速度 SLA,但对语义有硬性保证:实验必须通过可复现的端到端测量来证明自身价值,而默认策略绝不会静默改变模型精度或 router 语义。快速内存不足可能降低速度;但它绝不能悄悄重新定义模型。
$ ./coli chat
  🐦 colibri v1.10.2 — GLM-5.2 · 744B MoE · int4 · streaming CPU
  ✓ ready in 32s · resident 9.9 GB
  › ciao!
  ◆ Ciao! 😊 Come posso aiutarti oggi?
看看它跑起来
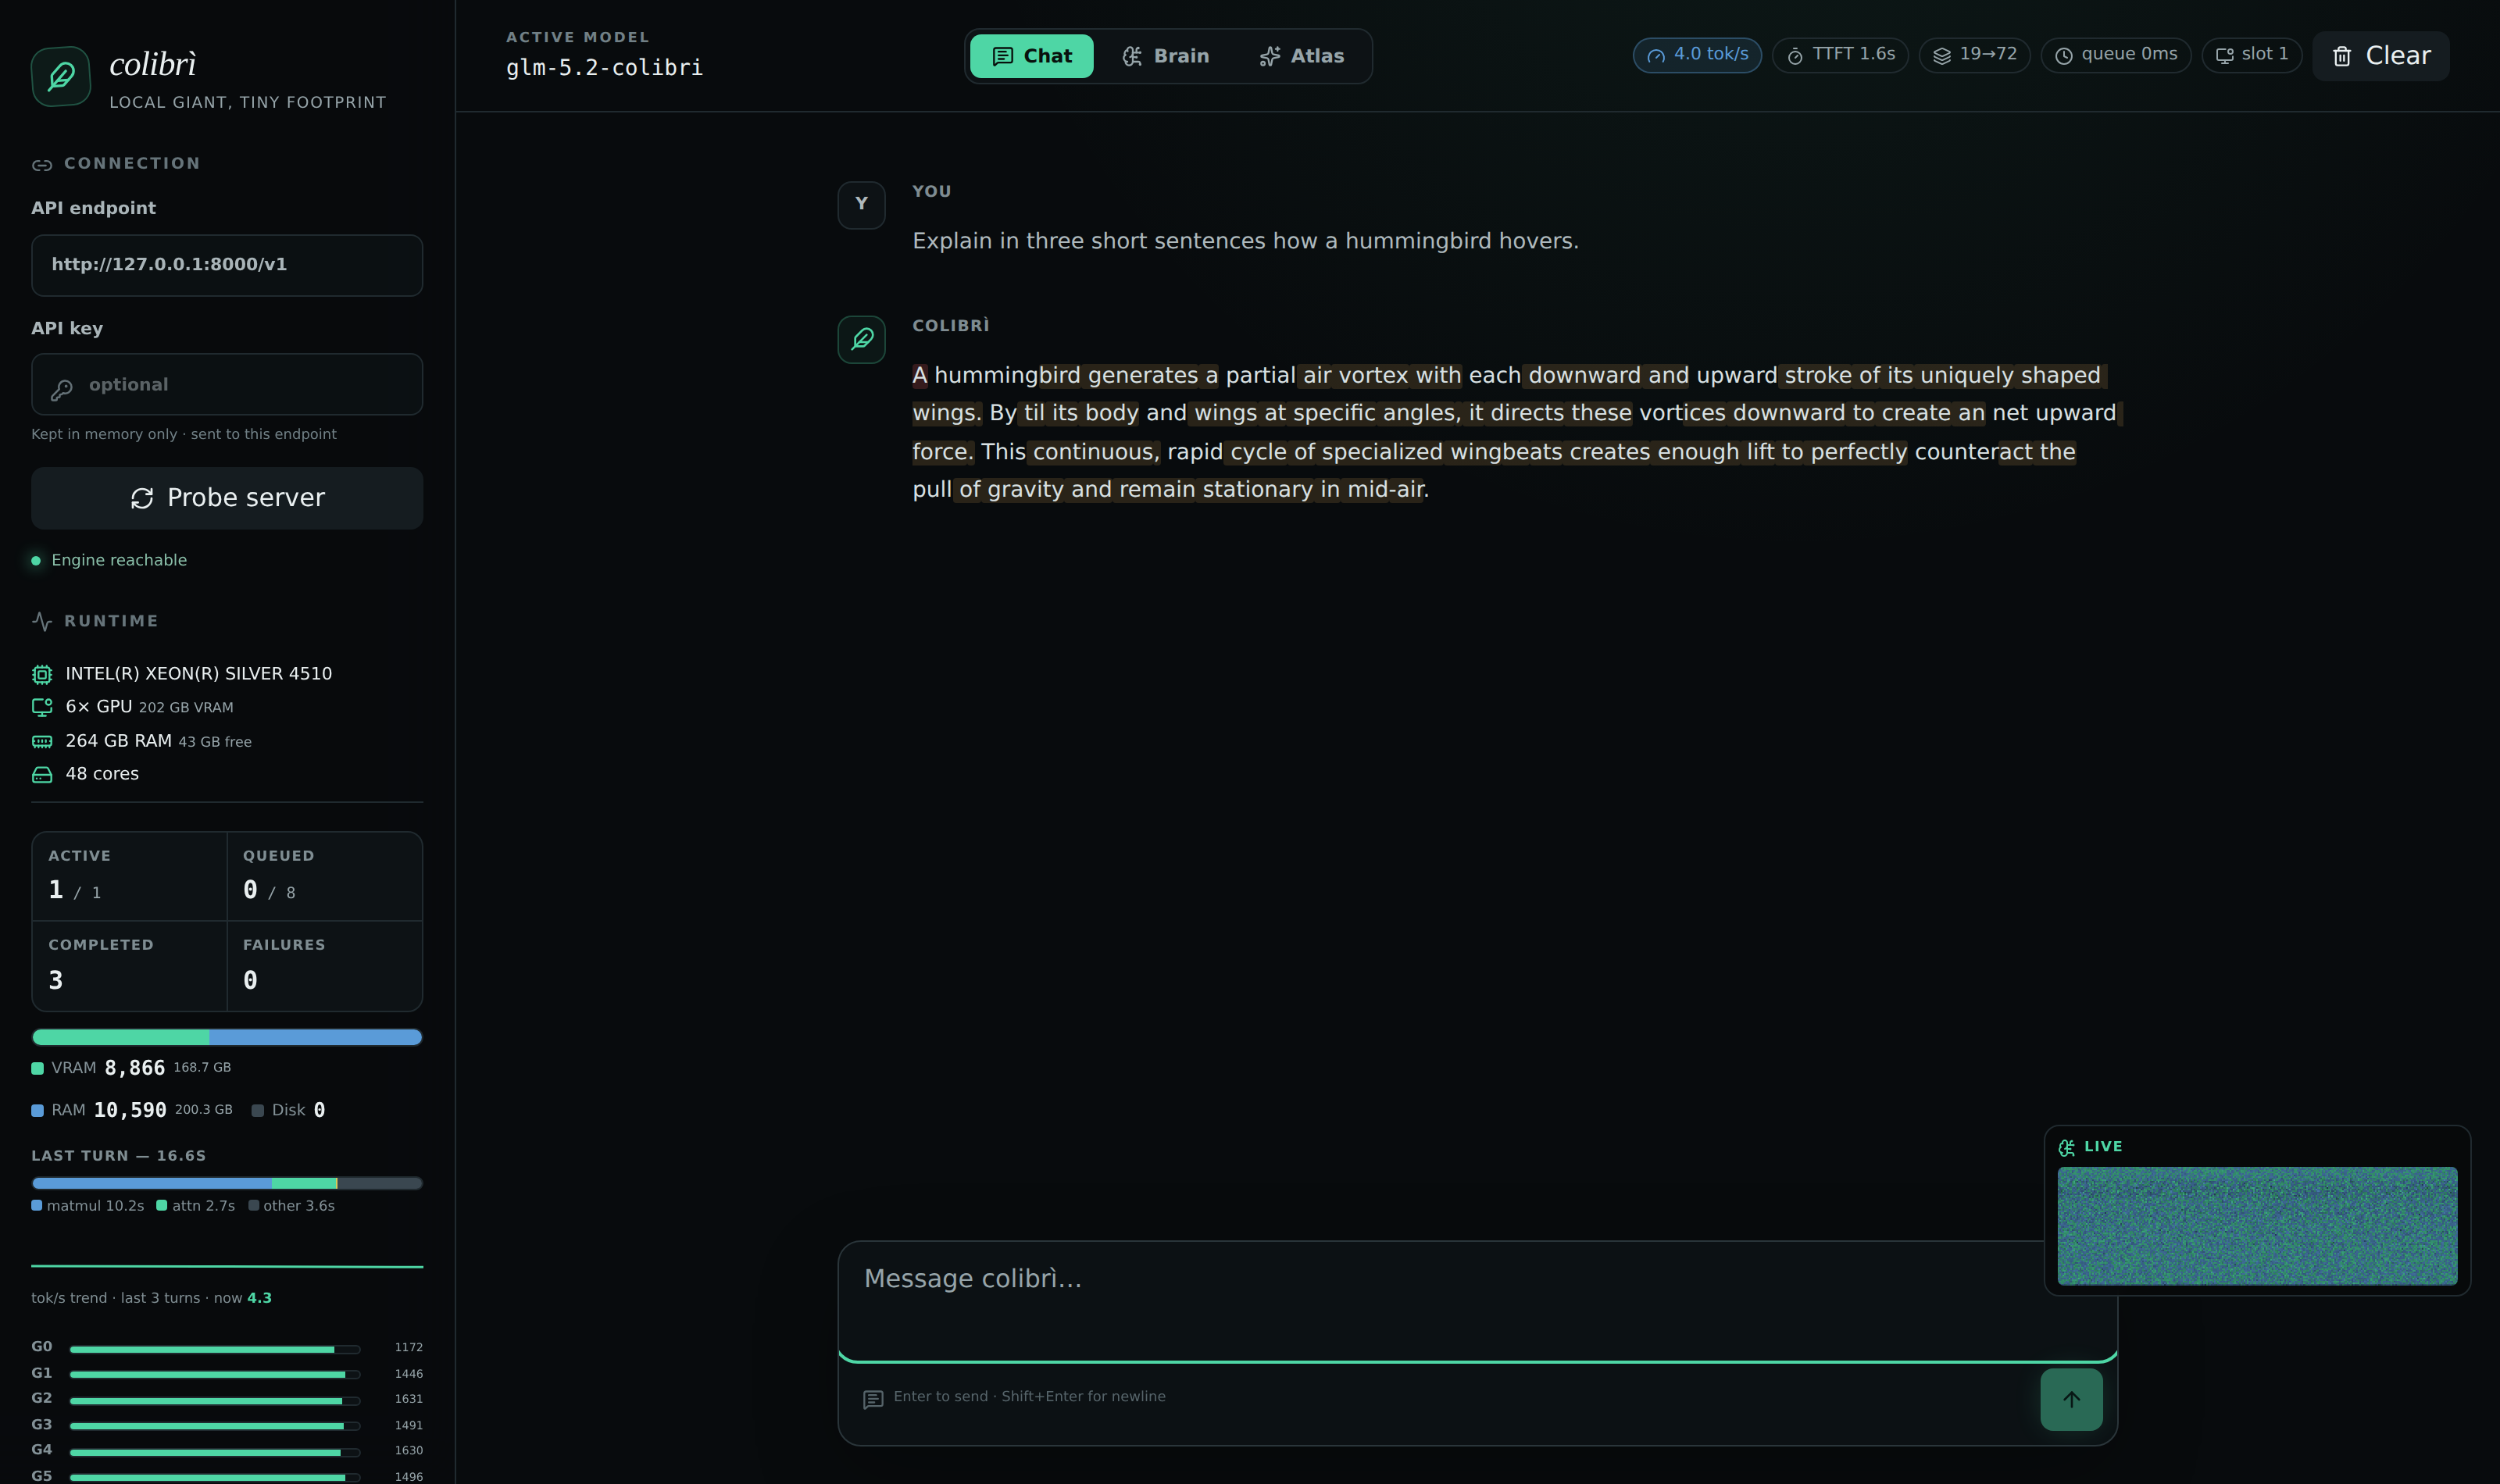
Web dashboard(./coli web):744B 模型达到 4 tok/s,TTFT 1.6 s,disk 0——在 6× RTX 5090 上实现专家完全驻留,并附带实时 token 指标、每轮耗时分解、VRAM/RAM/disk 层级条,以及角落里的实时 mini-brain。
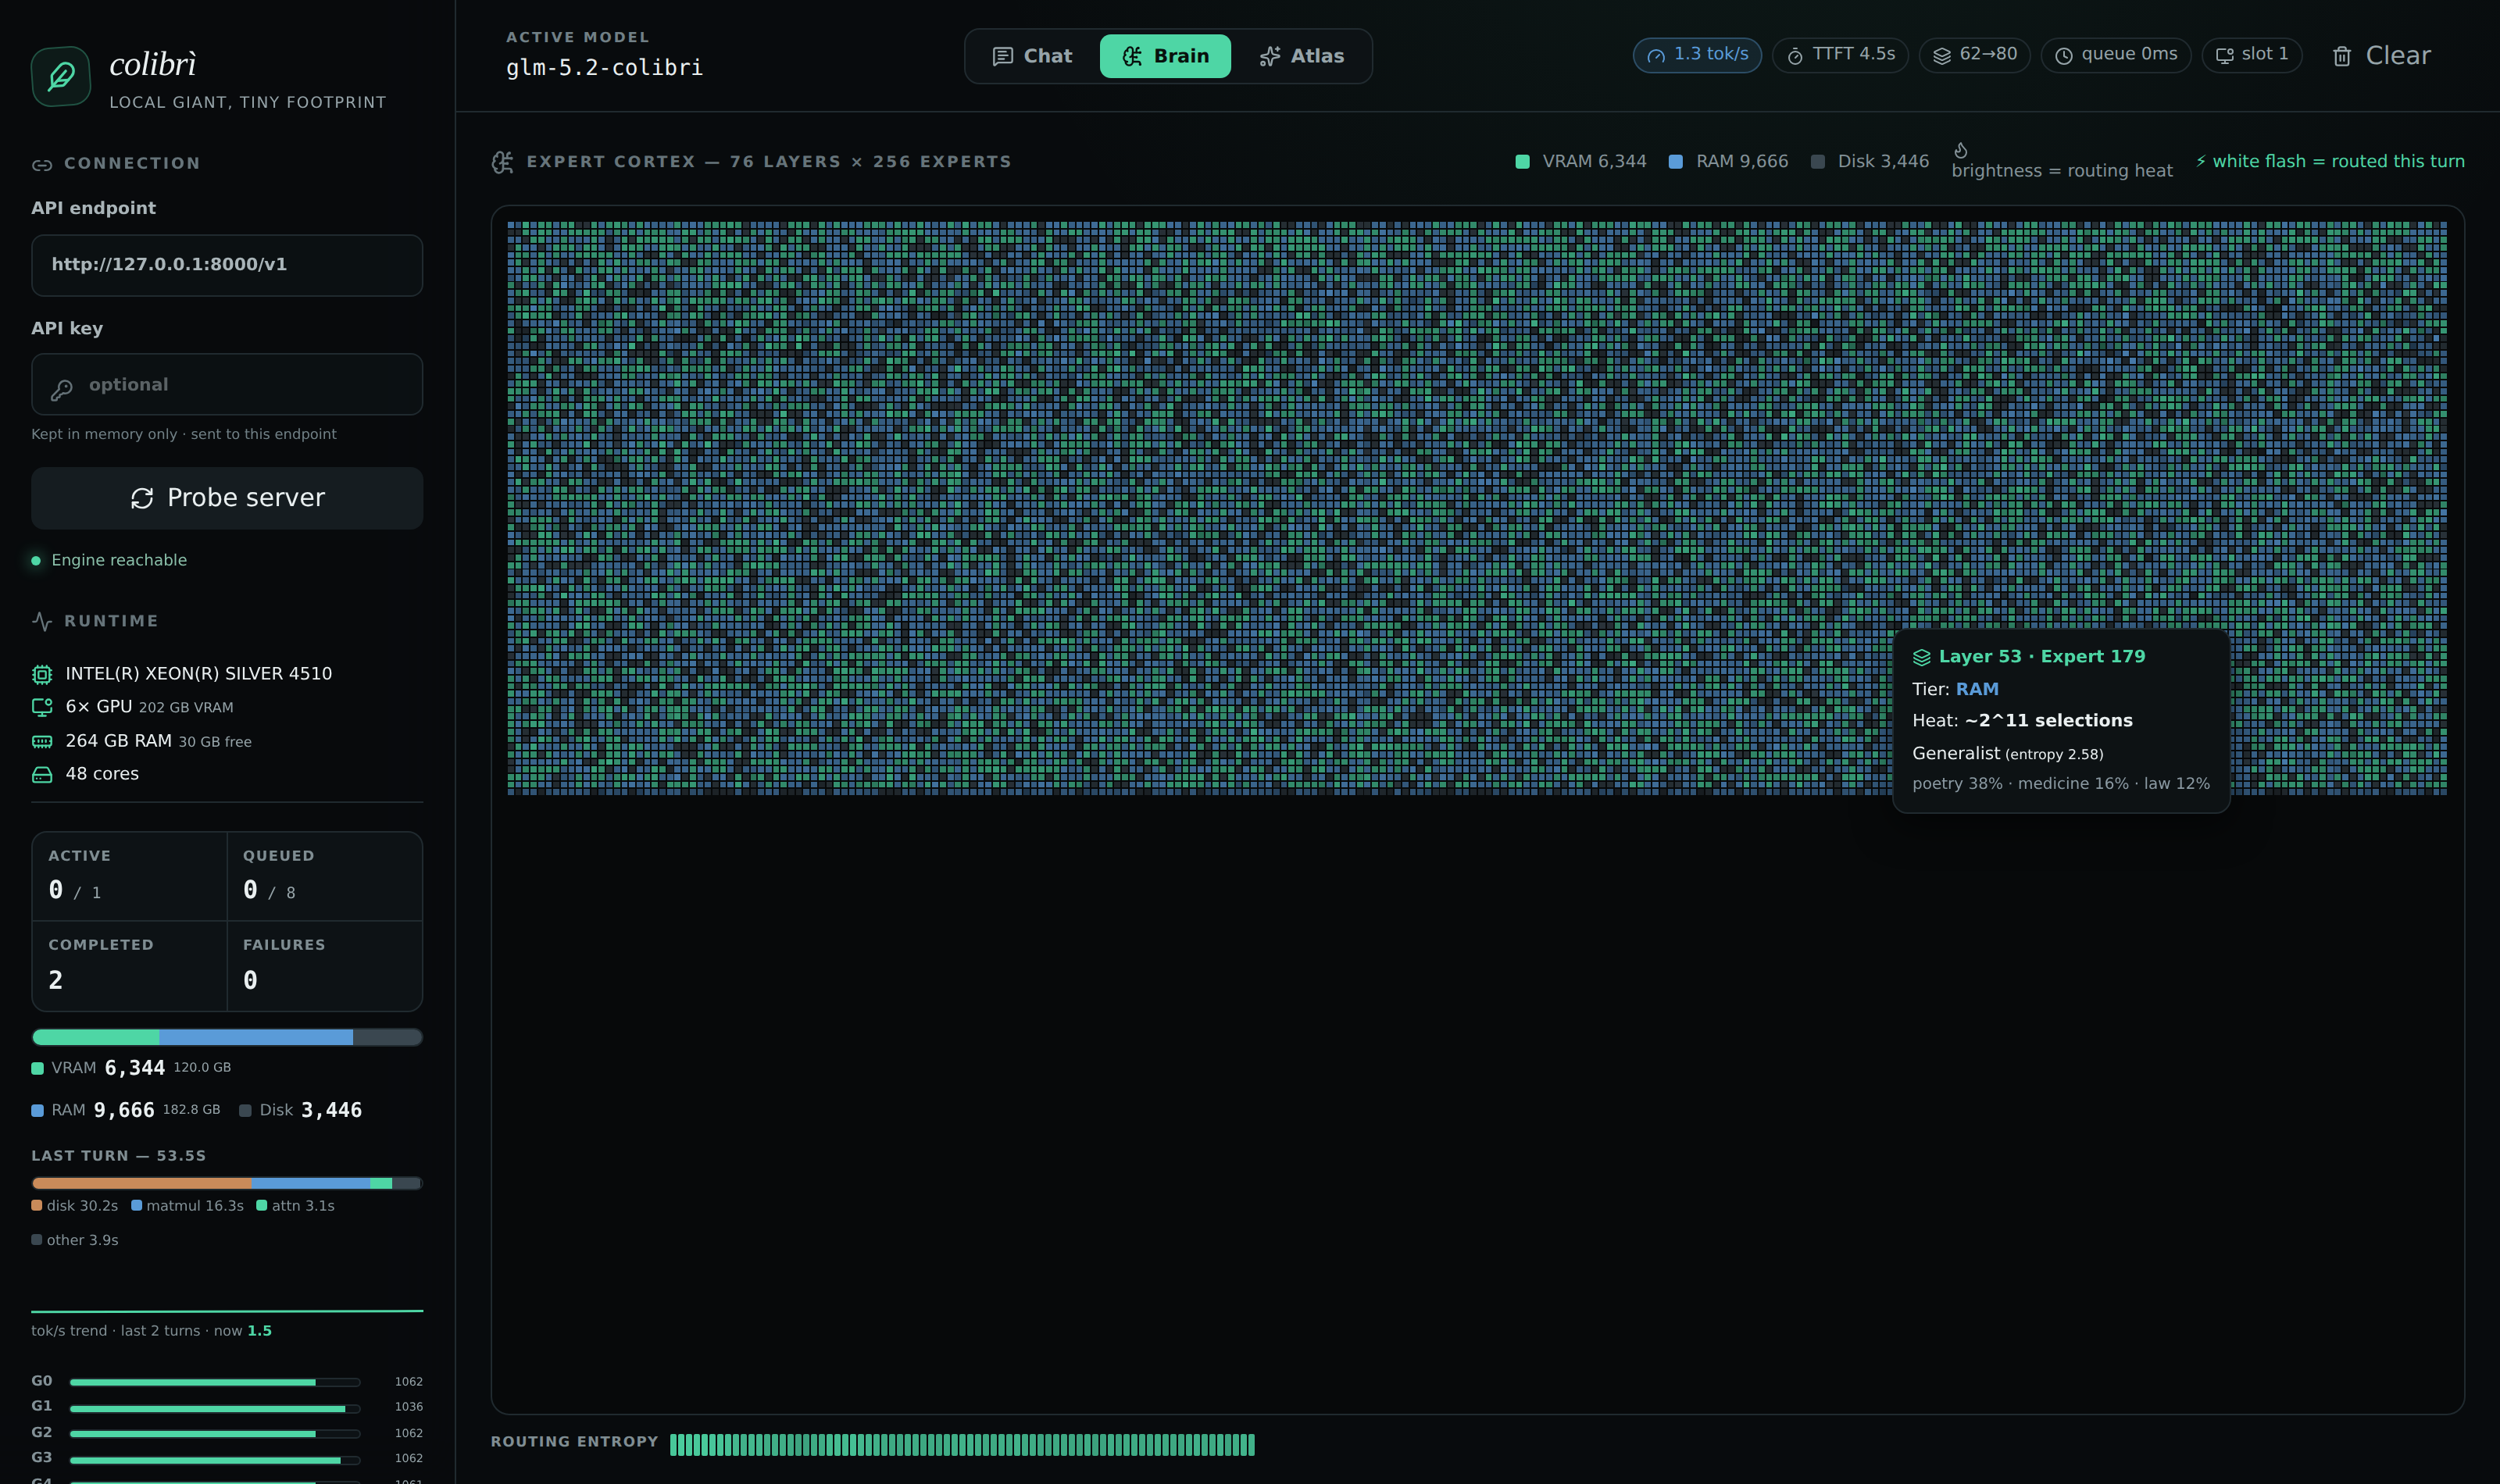
Brain 页面:全部 19,456 个专家构成一个活的皮层——颜色代表存储层级,亮度代表 routing 热度,每一轮中被路由到的专家都会闪白。悬停可显示该专家的 实测主题亲和度。
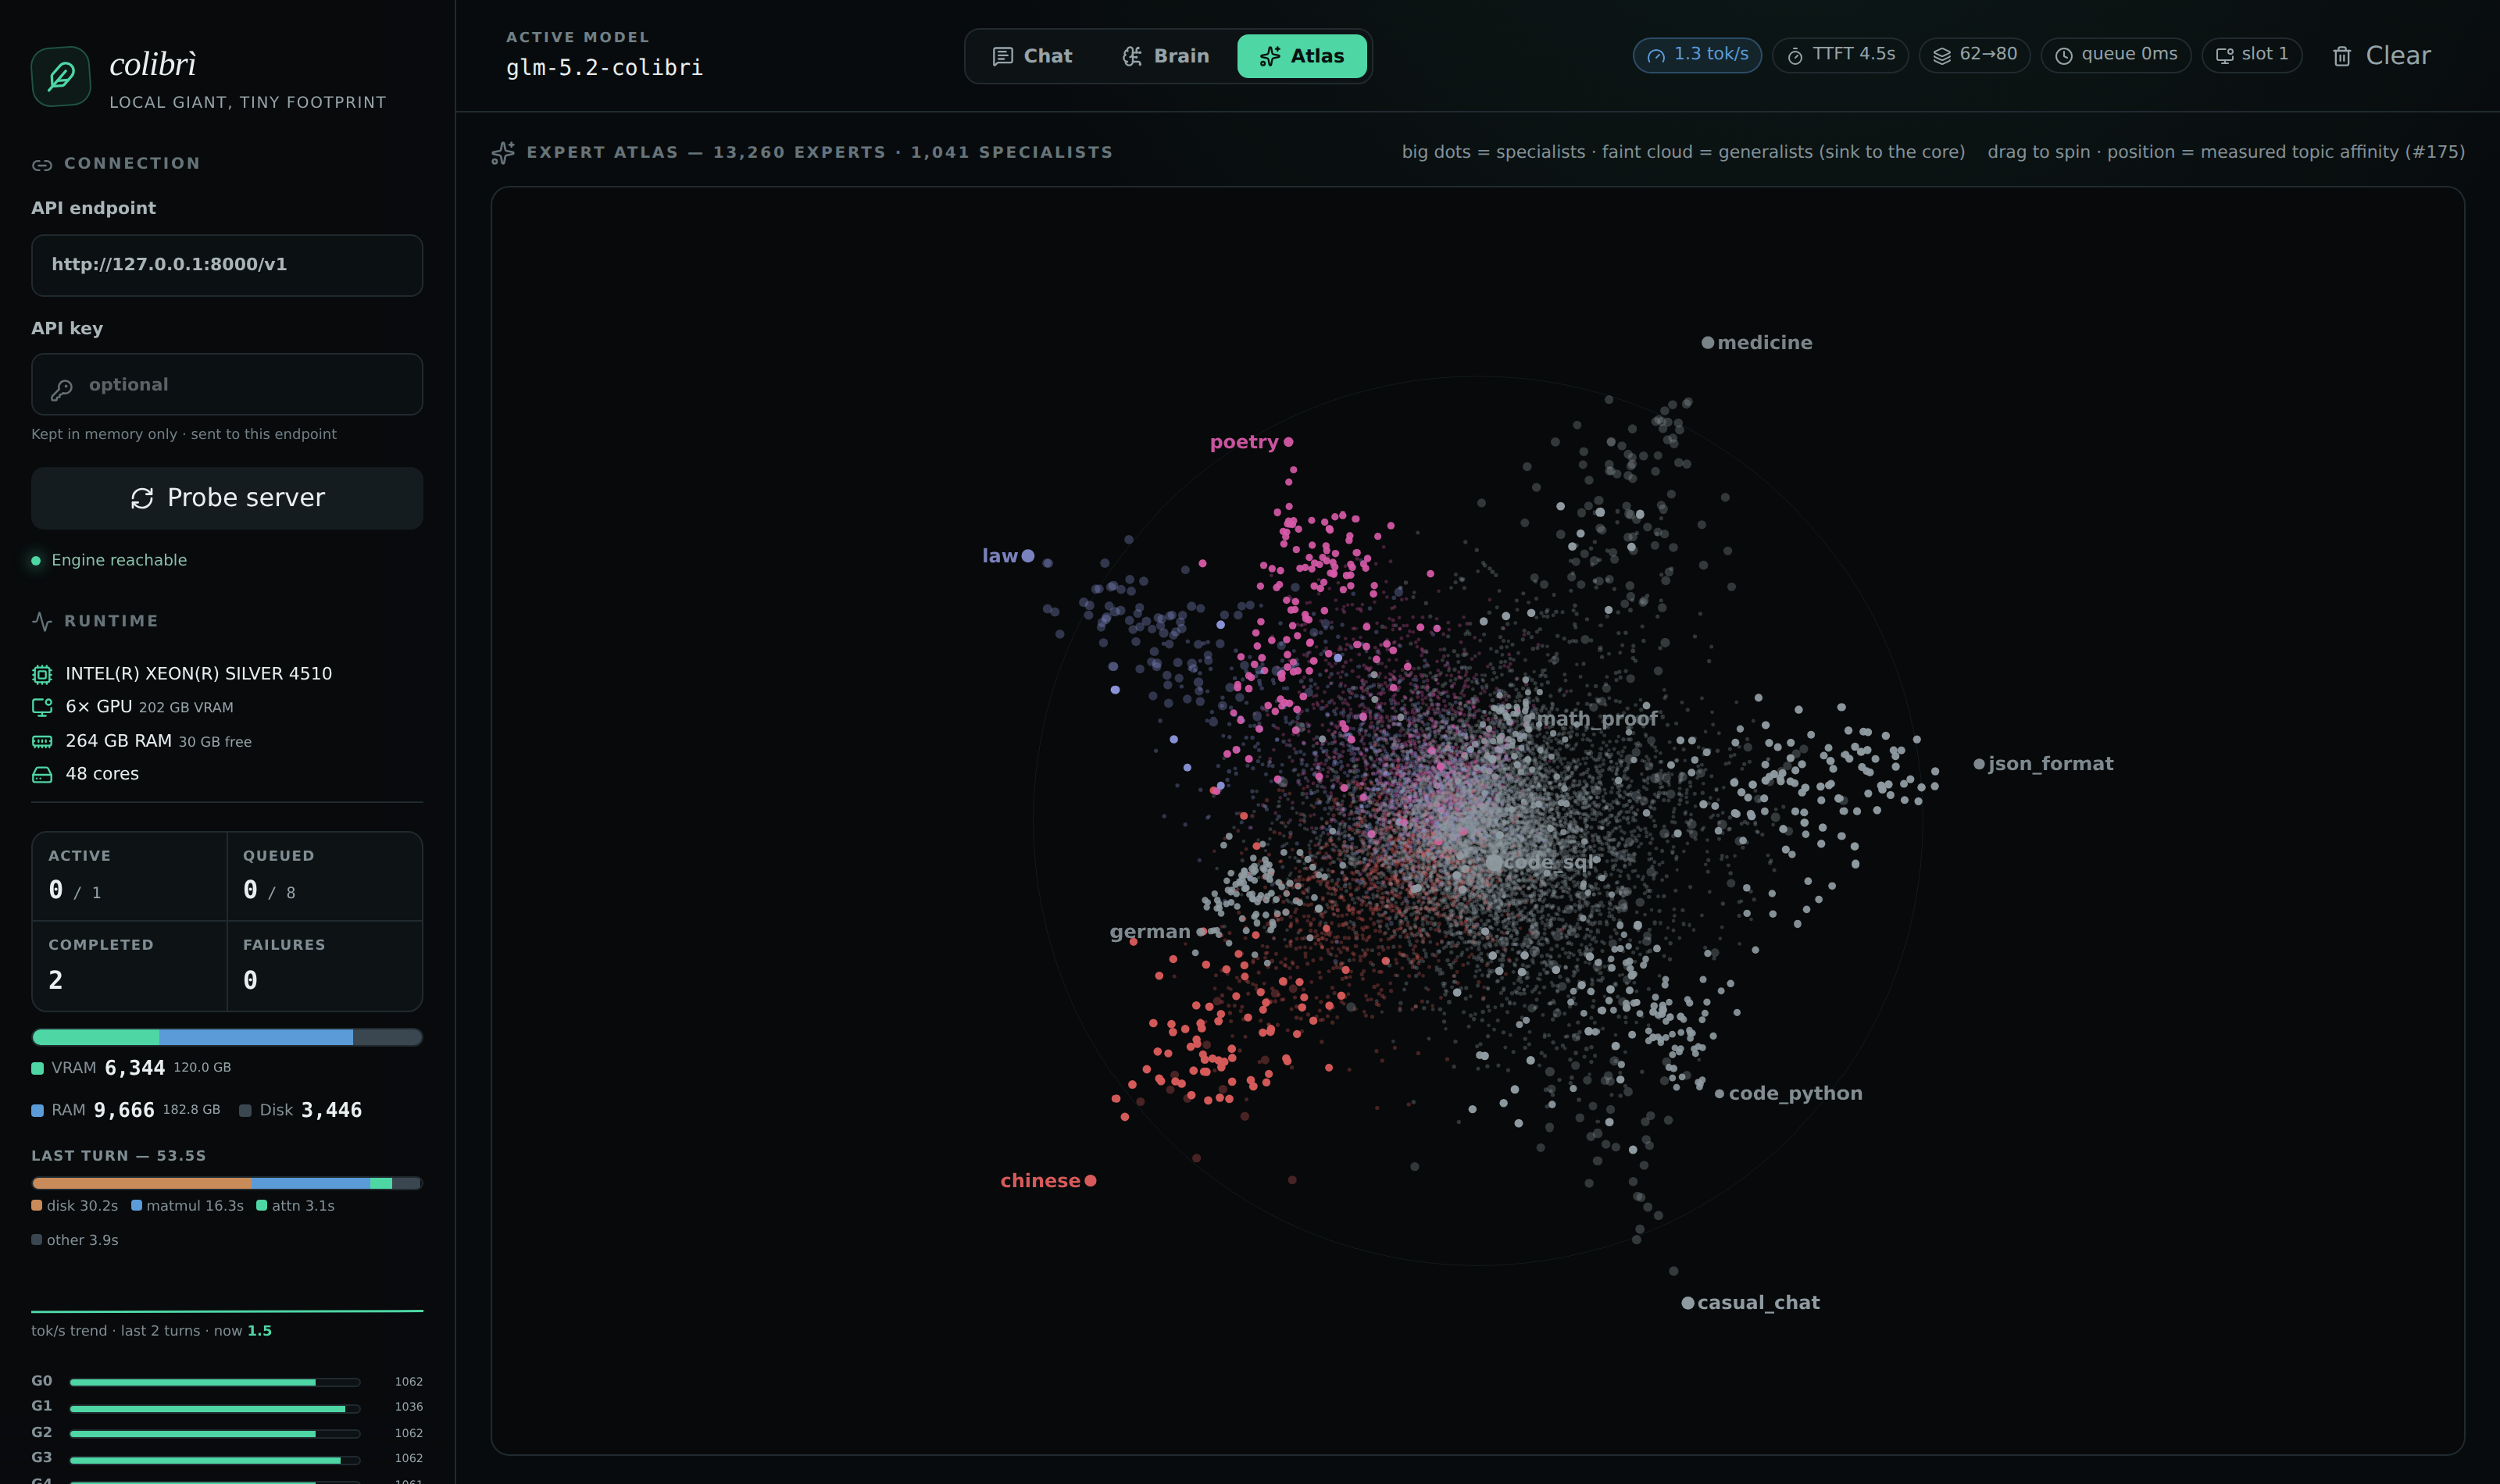
Atlas 页面:把实测专家图谱 呈现为 3D 星系——13,260 个已表征专家,其中 1,041 个复现的专精专家按主题聚集 (诗歌、法律、中文、SQL……)。位置来自实测的 routing 亲和度,而不是学习得到的 embedding。拖动可以旋转。
研究使命
借助 Colibrì,私有前沿模型的访问不再受限于超大规模数据中心级硬件的可获得性。
借助其多级分层特性,Colibrì 在积极优化推理引擎功能流水线的同时,消除对专有硬件的依赖。
我们的实际使命包括:改变权重的表示与搬运方式,决定什么放在 VRAM、RAM 或存储中,重叠异构计算,降低启动与同步开销,利用稀疏性与复用,并测试新的解码算法。任何东西都不会仅仅因为它是惯例做法而受到保护;任何东西也不会仅仅因为 microbenchmark 看起来快就被采纳。决定性的结果是在真实机器上的端到端推理,同时测量正确性与质量,以及吞吐、延迟、内存和成本。
实际带来的结果是可及性:在你自己已有的硬件上运行 744B 参数模型,实时观察每个专家的触发,并修改实现它的代码。不是通过 API 租用智能——而是持有它:探究它、测量它、改进它。这个引擎刻意做得足够小,使得下一个有用的优化可以来自任何愿意测量它的人。
核心技术与实测发现
- 一套层级,不受层级容量限制。 VRAM、RAM 与 NVMe 是同一批权重的放置层级;快速内存有限只改变速度,不改变模型语义。
- 面向权重的 JIT。 实测的 routing 热度驱动逐层 LRU、学习得到的 pinned 热存储,以及提前一层的 prefetch,而不是加载每一个专家。它在可重复的工作负载上胜出;历史可能过拟合,前瞻在某些主机上也可能失手,因此两者都是可测量的策略而非承诺。
- I/O 是引擎的一部分。 批量专家并集、读取与计算重叠、
O_DIRECT,以及加权双 SSD 条带化,都是在正面攻击流式路径,而不是假装存储延迟不存在。O_DIRECT依赖具体硬盘,双 SSD 也仍需要更广泛的端到端社区 A/B。 - 异构执行。 CPU、CUDA、Metal、NUMA 内存,以及专家的部分或完全驻留,共享同一套运行时,并可根据机器组合使用;有利可图的组合取决于算力、带宽、驻留程度与工作负载。
- 压缩状态,而非另一个模型。 token 精确的前向校验、缩小 57× 的 MLA KV 状态、持久化的热会话,以及忠实的 DSA,使优化始终与正确性绑定。这些是内存、延迟与正确性属性——不是笼统的吞吐量声明。
- 必须证明自身价值的投机解码。 原生 MTP 与语法强制 draft 都经过端到端测量,当接受率不足以回报验证成本时可以关闭。
开放假设、实验与如何参与
在受控的端到端 A/B 给出不同结论之前,Colibrì 把每一项优化都视为假设。以下是目前的主要问题:
| 假设 | 目前证据 | 仍需的实验 |
|---|---|---|
| routing 历史能比普通 LRU 更好地放置专家 | 学习得到的 pin 改善了重复工作负载,但可能对某个 prompt 过拟合 | 在编码、聊天、多语言与长上下文工作负载上做留出、跨会话的 A/B |
| 多块 SSD 可以把独立带宽转化为解码速度 | 加权镜像/分流路由已实现并验证;带宽模型成立 | 在真实、独立的控制器上做冷缓存单盘 vs 双盘的 GLM-5.2 运行 |
| 硬件感知的规划器能自动逼近每台机器的最优配置 | 目前已能检测 RAM/VRAM 预算与多个后端 | 把生成的方案与在笔记本、工作站、NUMA 主机和多 GPU 系统上的受控参数扫描做对比 |
| 无损或质量有界的表示能把权重搬运量减少到有意义的程度 | 已有格式与量化消融,并带有正确性/质量门禁 | 同时复现质量、搬运字节数、延迟与每有效 token 成本——而不只是压缩率 |
| routing 感知的投机解码能在接近完全驻留之前就开始获益 | MTP 与语法 draft 可用,但 MTP 也曾在专家命中率约 85% 时测得 32% 的损失 | 在接受率、专家命中率、batch union 与 draft 深度上描绘盈亏平衡面 |
| CPU/GPU 重叠可以隐藏传输与同步,而不只是把瓶颈挪个位置 | CUDA 与 Metal 确有收益,但快速 CPU 与低驻留可能抵消它们 | 跨 PCIe、统一内存与完全驻留机器做逐阶段 profile 与单变量 A/B |
想帮忙?挑一行,并把负面结果也公开出来。记录硬件、commit、模型/容器、确切命令、prompt、缓存状态、吞吐、TTFT、专家命中率、读取字节数和质量检查;每次只改一个变量,重复运行,并附上原始日志。从 CONTRIBUTING.md 开始,对照 基准测试协议,然后 开一个实验 issue。 在这里,一个控制良好的失败比一个无法解释的快数字更有价值。
思路
744B 的 Mixture-of-Experts 模型每个 token 只激活约 40B 参数——而其中仅约 11 GB 会随 token 变化(被路由的专家):
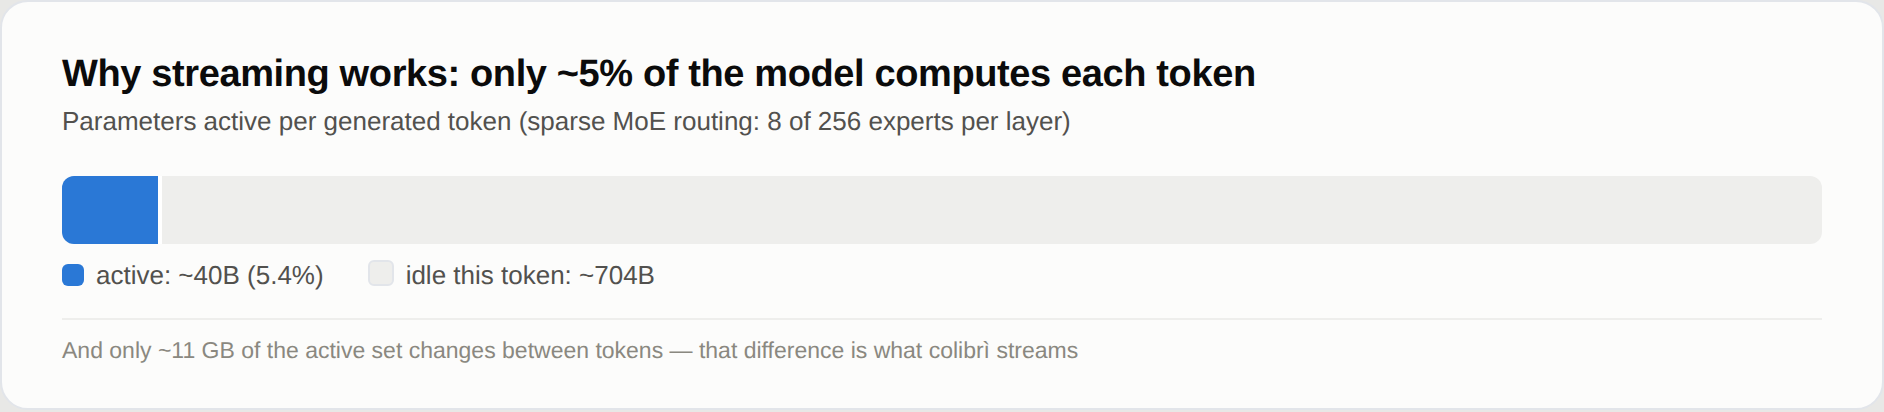
所以模型并不需要装进快速内存——它需要被放置:
- 稠密部分(attention、共享专家、embedding——约 17B 参数)以 int4 常驻 RAM(约 9.9 GB);
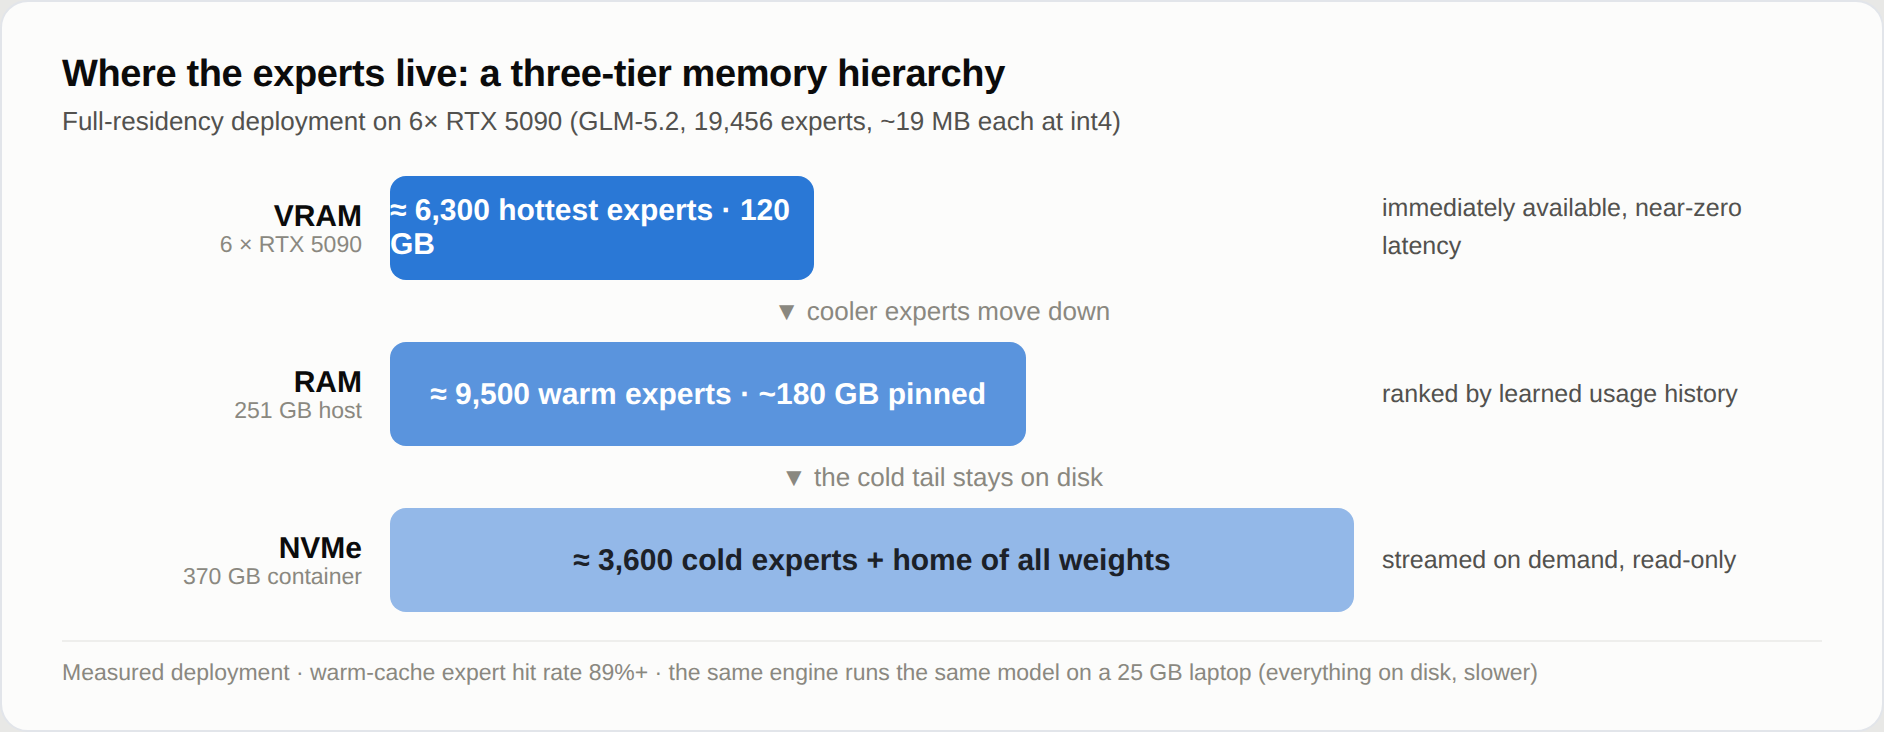
- 19,456 个被路由的专家(75 个 MoE 层 × 256 + MTP head,int4 下每个约 19 MB)放在磁盘上(约 370 GB),并按需流式读取,配有逐层 LRU 缓存、学习得到的 pinned 热存储,以及可选的 VRAM 层级。
可以把核心算法理解为一个 JIT,但作用于权重。编译器 JIT 从不编译整个程序——它观察实际运行的部分,并及时编译热路径。colibrì 对 744B 参数空间下的也是同样的赌注:参数不是要被持有的常驻状态,而是要跨异构存储层级(VRAM / RAM / NVMe)进行分阶段调度的数据,且恰好在 router 证明需要它们时调度。实测的 routing 热度决定哪些专家该进哪一层,router 提前一层运行,使 prefetch 能隐藏分阶段调度的延迟,而且——就像 JIT 一样——引擎会学习你的工作负载:你跑得越多,正确的专家就越"热"。它之所以可行,是因为 routing 具有可测量的结构(见 专家图谱)——而结构是可缓存的。
引擎是一个 C 文件(c/colibri.c)加上一些小的 header。没有 BLAS,运行时不用 Python,不需要 GPU。
本地集群模式
协调者把 token 生成、routing 与 KV 状态保留在本地,而由磁盘支撑的专家 worker 在其他 Mac 上执行被路由的 FFN。一层的 routed batch-union 作为单个持久 TCP 请求发送,因此一个 token 不会为每个专家各付一次往返。
启动可选的注册服务:
./coli cluster coordinator --host 0.0.0.0 --port 8765
在每个 worker 上,本地已有同一份转换后的模型:
./coli cluster worker --model /nvme/glm52_i4 --port 9100 \
  --coordinator http://COORDINATOR:8765 --advertise-host WORKER_IP
以服务发现方式运行协调者,或者为静态部署提供 --cluster-workers HOST:PORT,...:
./coli serve --model /nvme/glm52_i4 \
  --cluster-coordinator http://127.0.0.1:8765
除非配置了 worker,否则该传输通道是关闭的,因此现有的单机路径保持不变。稠密层分片与浏览器/WebGPU worker 是各自独立的后续切入点。
工作原理
每 token 路径
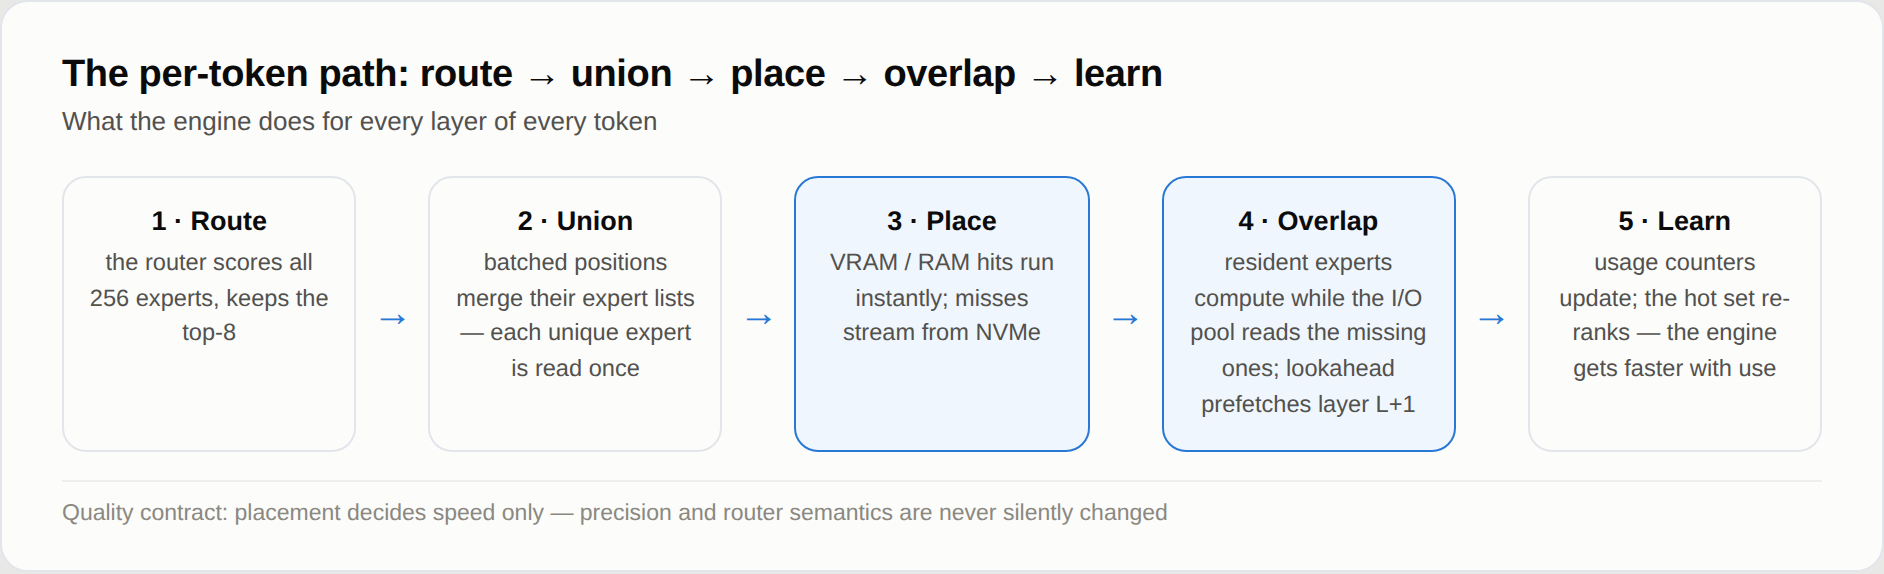
每个 token 的每一层都走同样的五步。设计目标是放置只决定速度——无论一个专家是从 VRAM 还是从磁盘作答,router 的决策与权重的精度都是相同的。
一套内存层级,而不是一项内存要求
双 SSD:模型两份副本,读取带宽翻倍
在大多数机器上解码受磁盘限制,而专家读取是只读的——所以如果你有第二块 SSD,把模型的完整副本放上去,让引擎同时从两块盘流式读取:
COLI_MODEL=/fast/glm52_i4 COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat
COLI_DISK_WEIGHTS=9,3 ...   # optional: primary,mirror bandwidth ratio (else measured at startup)
每个专家通过确定性哈希路由到某一块盘,权重按两块盘实测(或声明的)带宽分配,因此 readahead/PILOT prefetch 与按需读取总是命中同一块盘,任何东西都不会被缓存两次。总带宽是两块盘之和——9 GB/s 加 3 GB/s 的组合比只用快盘读取专家快约 33%,而 OMP 并行的 pin/warmup 加载会从两块盘同时流式读取。一些值得了解的细节:
- 镜像在启动时会校验(逐文件大小 + safetensors header 必须与主盘逐字节一致);不一致或缺失的文件会静默留在主盘,因此部分镜像是可以的——第二块小 SSD 只放一部分 shard 也仍然有帮助;
- 镜像永远不被写入:
.coli_usage、.coli_kv以及所有 sidecar 都留在主盘; - 镜像上的读取错误会回退到主盘(只警告一次,不会崩溃),所以运行中拔掉第二块盘只会降级,而不会杀死服务;
- routing 从不改变 token——两份副本逐字节相同,而每次运行的
MIRROR:统计行会显示每块盘各自服务了多少 GB。
同一个引擎覆盖全区间:在 25 GB 笔记本上,一切都从磁盘流式读取(慢但正确);在大型主机上,整个专家集合可以变成常驻(CUDA_EXPERT_GB=auto PIN_GB=all),磁盘完全退出解码路径。层级之间是一个学习型缓存:引擎记录