llmwiki
基于 Karpathy 的 llm-wiki 模式实现的跨平台桌面应用,用 LLM 把 PDF/DOCX/EPUB 等文档增量编译成带 wikilink 的持久化 wiki,而不是每次查询都重跑 RAG。亮点是两步 CoT ingest、四信号相关性知识图谱配 Louvain 社区发现、可选 LanceDB 向量检索,以及内置 MCP server 与本地 HTTP API,可直接接入 Claude Code 等 agent。GPL-3.0 开源。
README
LLM Wiki
一个自我构建的个人知识库。
LLM 读取你的文档,构建结构化 wiki,并保持其最新。
这是什么? • 功能 • 技术栈 • 安装 • 致谢 • 许可证
功能
- 两步 Chain-of-Thought(思维链)导入 — LLM 先分析,再生成可溯源、带增量缓存的 wiki 页面
- 多模态图片导入 — 从 PDF 中提取嵌入图片,用 vision LLM 生成事实性 caption,在图片感知搜索结果中展示,支持 lightbox 预览和跳转到源文件
- 多格式文档解析 — 导入 PDF、Office 文档、EPUB/MOBI、Org mode、图片、媒体、网页剪藏,以及批量 URL,支持内置、云端或本地 MinerU PDF 处理
- 灵活模型配置 — 按项目配置模型,独立路由 Chat 和 Ingest,管理自定义 provider、headers 和 streaming 输出
- 基于来源的检索 — 使用 Read Sources Only 模式,仅从原始导入材料中回答
- 项目管理与迁移 — 跨设备导出和导入完整项目归档,并从现有页面重建 Wiki 索引
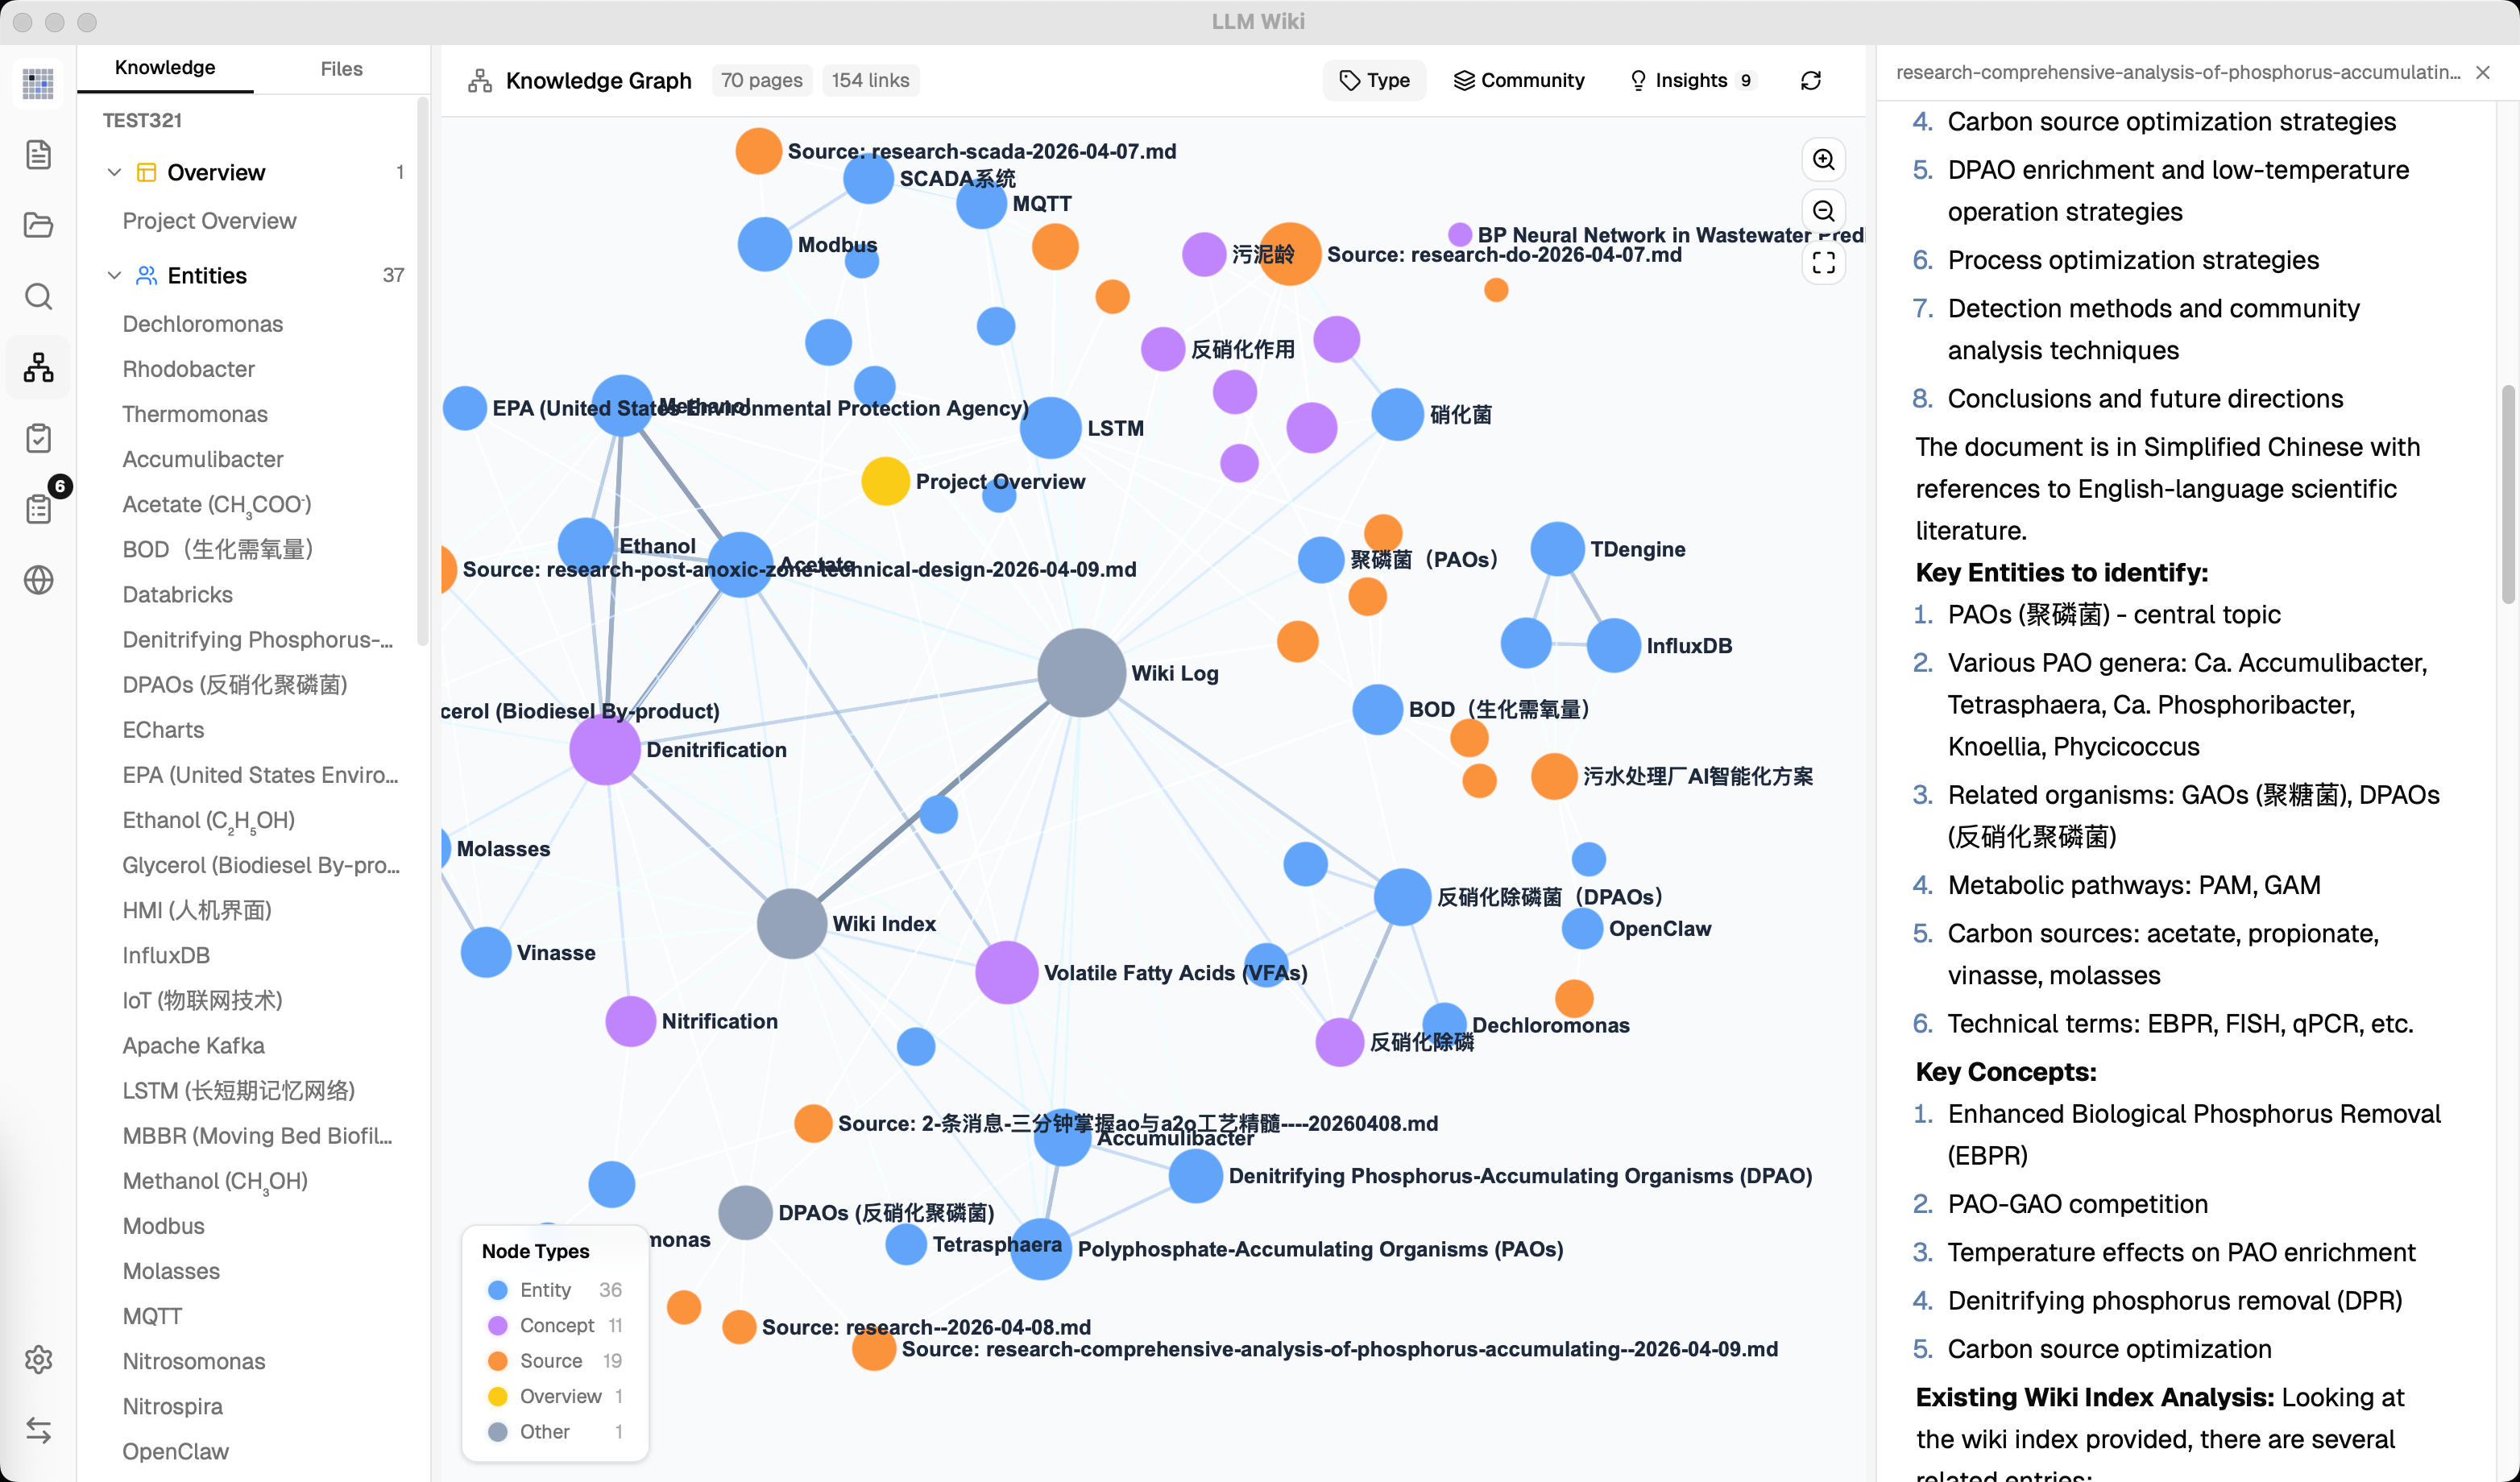
- 4-Signal 知识图谱 — 相关性模型包含 direct links、source overlap、Adamic-Adar 和 type affinity
- Louvain 社区检测 — 自动发现知识聚类,并计算 cohesion 分数
- 图谱洞察 — 发现意外连接和知识缺口,一键 Deep Research
- Vector 语义搜索 — 可选的基于 embedding 的检索,通过 LanceDB 实现,支持任意 OpenAI 兼容 endpoint
- 持久化 Ingest 队列 — 串行处理,支持崩溃恢复、取消、重试和进度可视化
- 文件夹导入 — 递归导入文件夹并保留目录结构,文件夹上下文作为 LLM 分类提示
- Source 文件夹自动监听 — 检测
raw/sources/中的外部更改,并同步 ingest/delete 清理 - Deep Research — LLM 优化搜索主题,通过 Tavily、SerpApi 或 SearXNG 进行多查询 Web 搜索,自动将结果导入 wiki
- Rust 后端 Chat Agent — 使用工具的聊天运行时,支持 wiki/source/graph/web 检索、工作区文件生成、shell 审批、取消和 streaming tool events
- Agent Skills — 扫描并启用本地
SKILL.md文件夹,使用/skill选择 skill,让 Agent 按需读取 skill 指令 - 生成输出预览 — Agent 创建的 Markdown、HTML、图片和其他工作区文件会作为 outputs 展示,支持预览和快速打开文件夹
- Mermaid 图表渲染 — 在聊天和预览中直接渲染 Mermaid 代码块,语法错误时显示紧凑错误卡片,而不是原始 parser 输出
- 异步 Review 系统 — LLM 标记需要人工判断的项目,提供预定义操作和预生成搜索查询
- Chrome 网页剪藏 — 一键捕获网页并自动导入知识库
- 本地 HTTP API + MCP Server + AI Agent Skill — 内置
127.0.0.1:19828JSON API 和捆绑的 MCP server,用于 hybrid search(混合搜索)、文件读取、图谱遍历和 source rescan;现成的 agent skill 可通过一条命令(npx skills add …)安装到 Claude Code / Codex
这是什么?
LLM Wiki 是一个跨平台桌面应用,可自动将你的文档转化为有组织、相互链接的知识库。相比传统 RAG(每次从零检索并回答),LLM 会从你的来源中增量构建并维护一个持久化 wiki。知识只需编译一次并保持最新,而不是在每次查询时重新推导。
本项目基于 Karpathy 的 LLM Wiki 模式 —— 一种使用 LLM 构建个人知识库的方法论。llm_wiki 由 nash_su 创建并维护,他将核心思想实现为一个完整的桌面应用,并做了大量增强。
致谢
基础方法论来自 Andrej Karpathy 的 llm-wiki.md,其中描述了使用 LLM 增量构建并维护个人 wiki 的模式。原始文档是一个抽象设计模式;本项目是一个具体实现,并做了大量扩展。
我们从原始方案中保留的内容
核心架构忠实遵循 Karpathy 的设计:
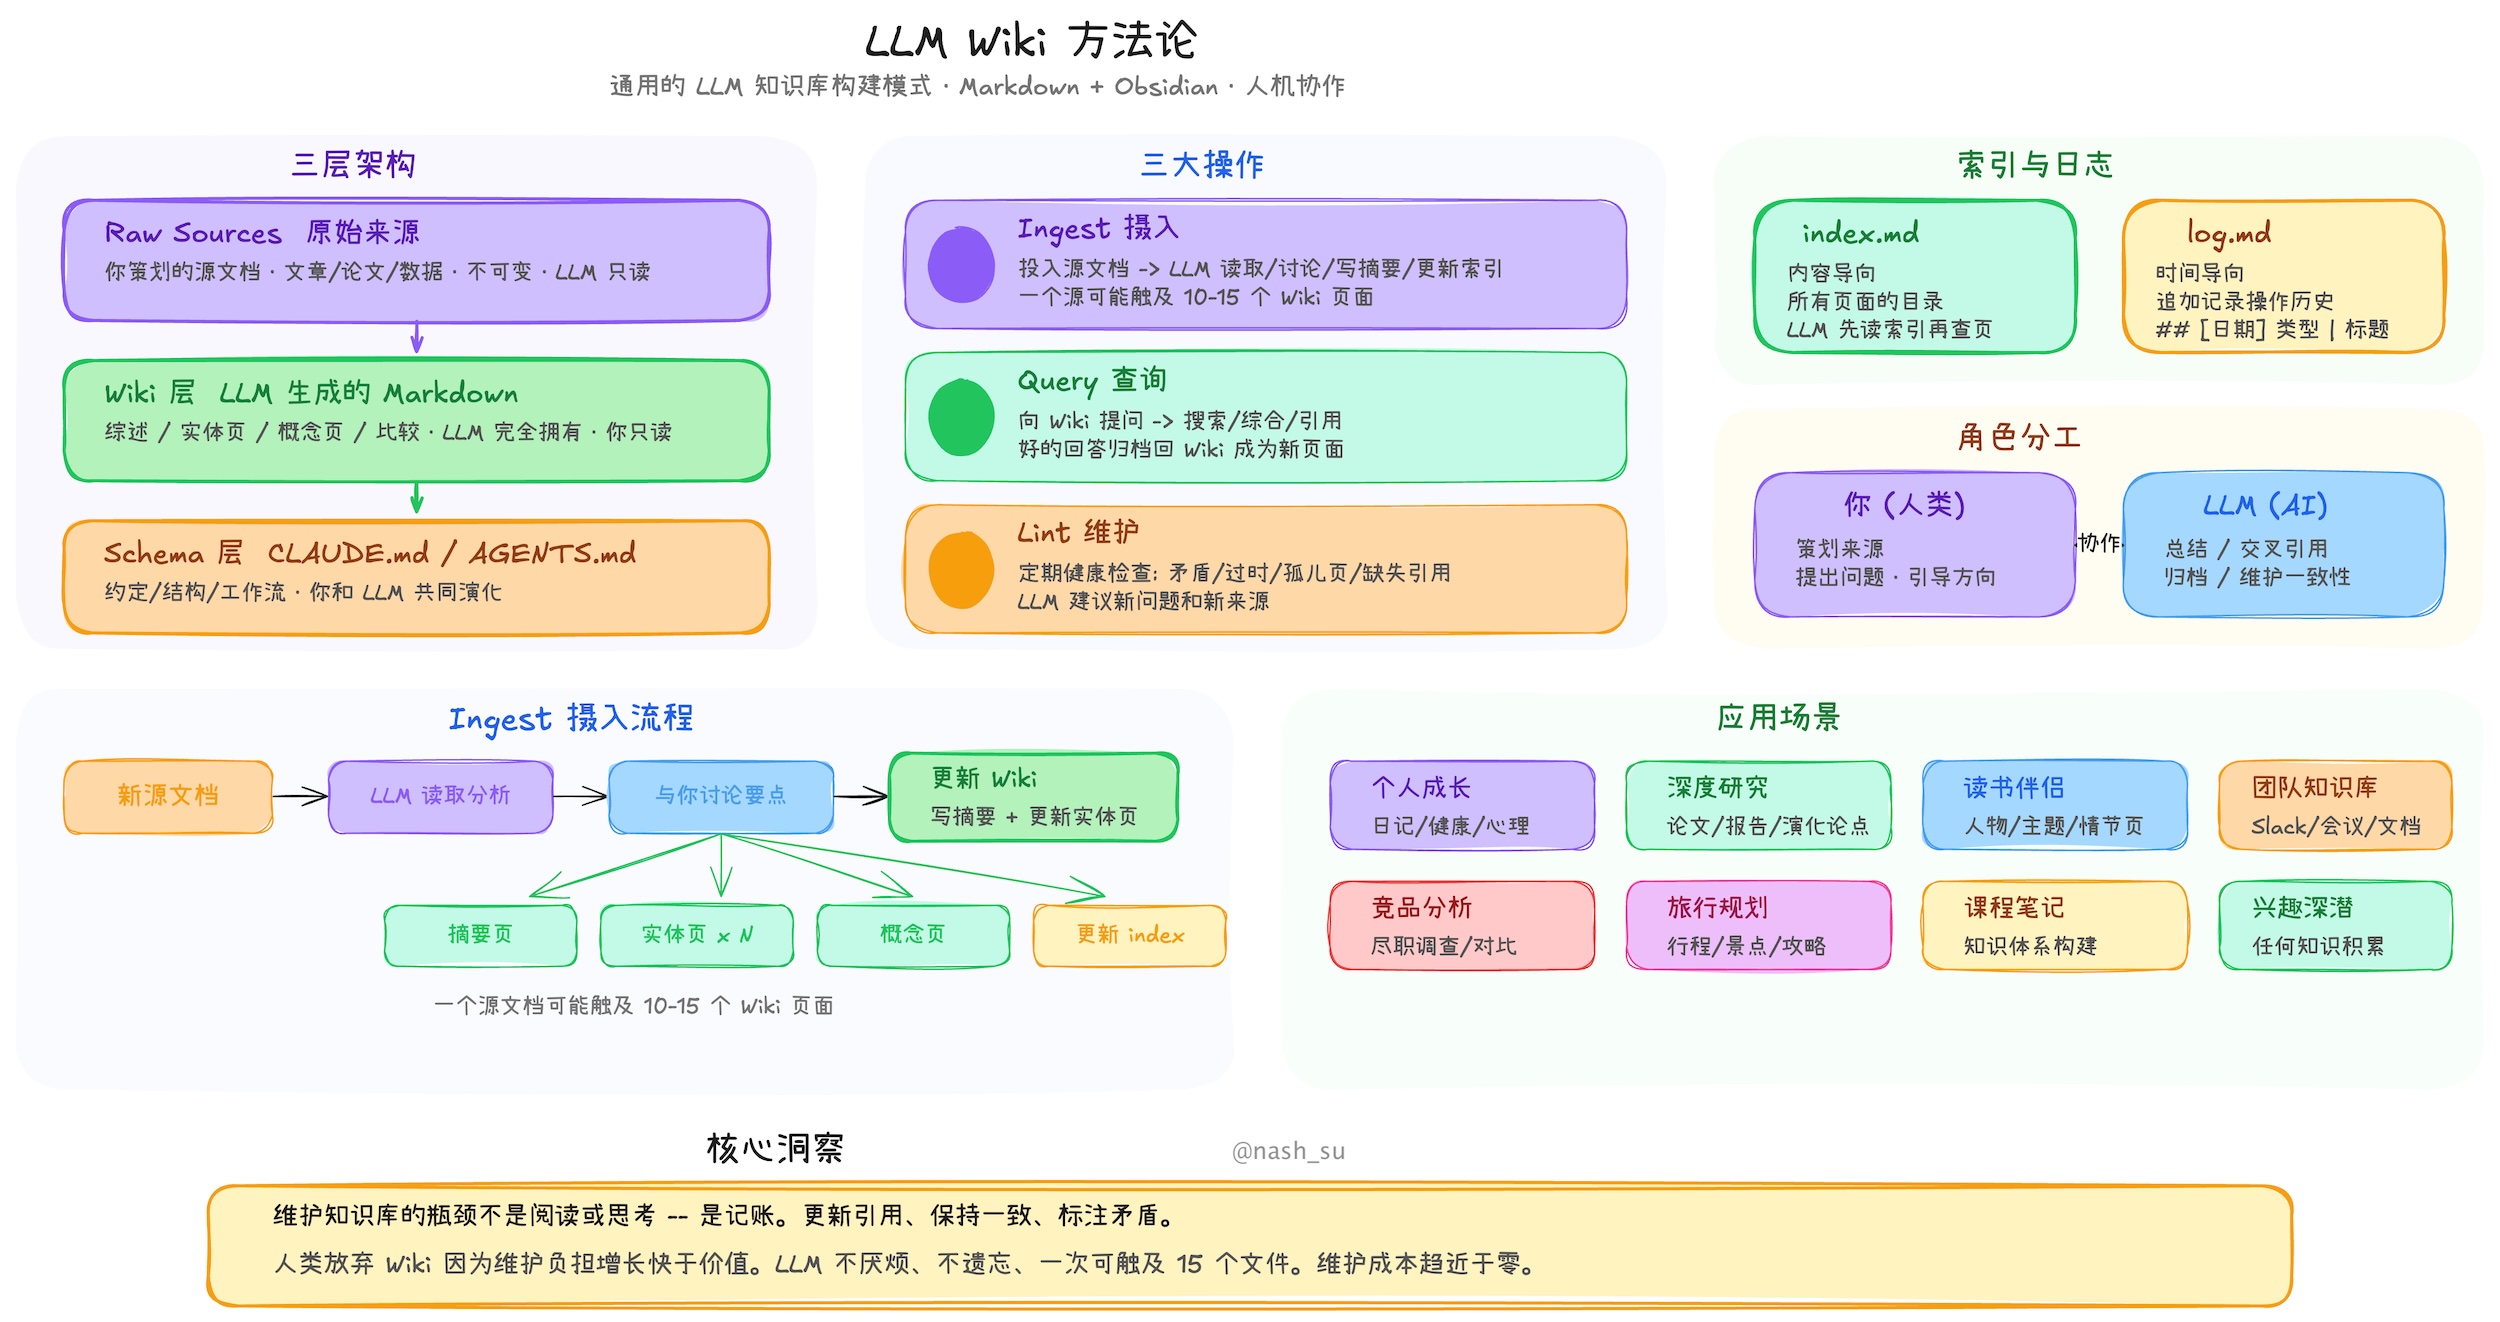
- 三层架构:Raw Sources(不可变)→ Wiki(LLM 生成)→ Schema(规则与配置)
- 三大核心操作:Ingest、Query、Lint
- index.md 作为内容目录和 LLM 导航入口
- log.md 作为按时间顺序记录的可解析操作日志
- [[wikilink]] 语法用于交叉引用
- 每个 wiki 页面都有 YAML frontmatter
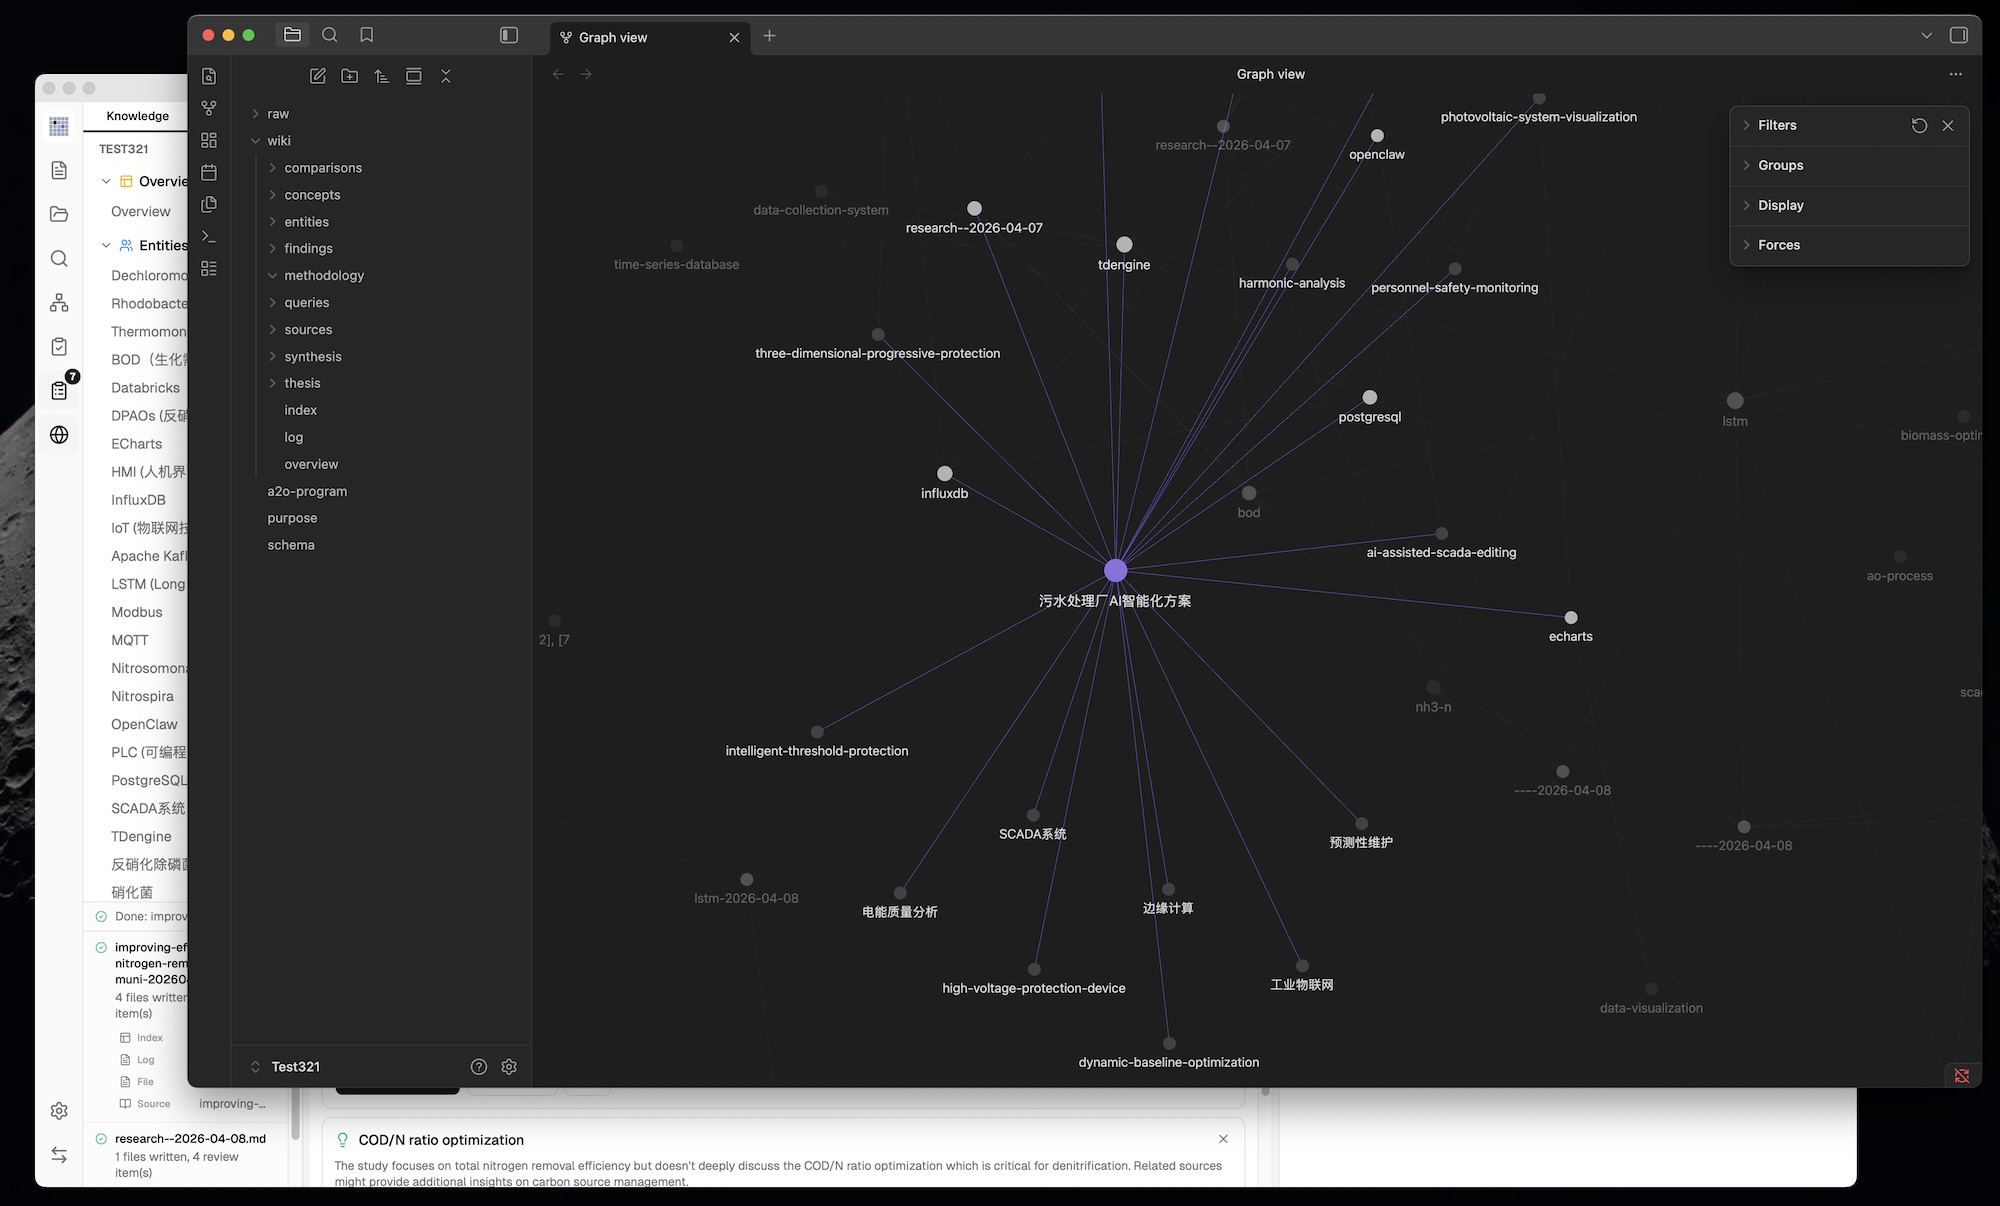
- Obsidian 兼容 — wiki 目录可作为 Obsidian vault 使用
- 人类策展,LLM 维护 — 根本角色划分
我们改变和新增的内容
1. 从 CLI 到桌面应用
原始方案是一个抽象模式文档,设计用于复制粘贴给 LLM agent。我们将其构建为一个完整的跨平台桌面应用,包括:
- 三栏布局:知识树 / 文件树(左)+ Chat(中)+ 预览(右)
- 图标侧边栏用于在 Wiki、Sources、Search、Graph、Lint、Review、Deep Research、Settings 之间切换
- 自定义可调整面板 — 左右面板可拖拽调整大小,并带最小/最大约束
- 活动面板 — 实时处理状态,显示逐文件导入进度
- 所有状态持久化 — 对话、设置、review 项、项目配置在重启后仍保留
- 场景模板 — Research、Reading、Personal Growth、Business、General — 每个都会预配置 purpose.md 和 schema.md
2. Purpose.md — Wiki 的灵魂
原始方案有 Schema(wiki 如何运作),但没有正式位置说明 wiki 为什么存在。我们新增了 purpose.md:
- 定义目标、关键问题、研究范围、演进中的论点
- LLM 在每次导入和查询时读取它作为上下文
- LLM 可以根据使用模式建议更新
- 与 schema 不同 — schema 是结构规则,purpose 是方向性意图
3. 两步 Chain-of-Thought 导入
原始方案描述的是单步导入,LLM 同时读取和写入。我们将其拆分为两次顺序 LLM 调用,显著提升质量:
Step 1 (Analysis): LLM reads source → structured analysis
  - Key entities, concepts, arguments
  - Connections to existing wiki content
  - Contradictions & tensions with existing knowledge
  - Recommendations for wiki structure

Step 2 (Generation): LLM takes analysis → generates wiki files
  - Source summary with frontmatter (type, title, sources[])
  - Entity pages, concept pages with cross-references
  - Updated index.md, log.md, overview.md
  - Review items for human judgment
  - Search queries for Deep Research
在原始方案之外的额外导入增强:
- SHA256 增量缓存 — 导入前对源文件内容进行哈希;未更改的文件自动跳过,节省 LLM token 和时间
- 持久化导入队列 — 串行处理避免并发 LLM 调用;队列持久化到磁盘,可在应用重启后恢复;失败任务自动重试最多 3 次
- 文件夹导入 — 递归导入文件夹并保留目录结构;文件夹路径作为分类上下文传给 LLM(例如 "papers > energy" 有助于内容归类)
- Source 文件夹自动监听 — 在应用外对
raw/sources/中添加、编辑或删除的文件会被自动拾取,并复用与应用内操作相同的导入/删除生命周期 - 队列可视化 — Activity Panel 显示进度条、待处理/处理中/失败任务,并带取消和重试按钮
- 自动 embedding — 当启用 vector search 时,新页面会在导入后自动 embedding
- 来源可追溯性 — 每个生成的 wiki 页面在 YAML frontmatter 中包含
sources: []字段,链接回贡献内容的原始源文件 - overview.md 自动更新 — 每次导入时重新生成全局摘要页面,以反映 wiki 的最新状态
- 保证 source summary — fallback 确保始终创建 source summary 页面,即使 LLM 遗漏
- 语言感知生成 — LLM 以用户配置的语言(English 或 Chinese)回复
- 渐进式 Sources 视图 — 大型 source 文件夹在滚动时渐进渲染,保持大量 source 集合的响应性
4. 带相关性模型的知识图谱
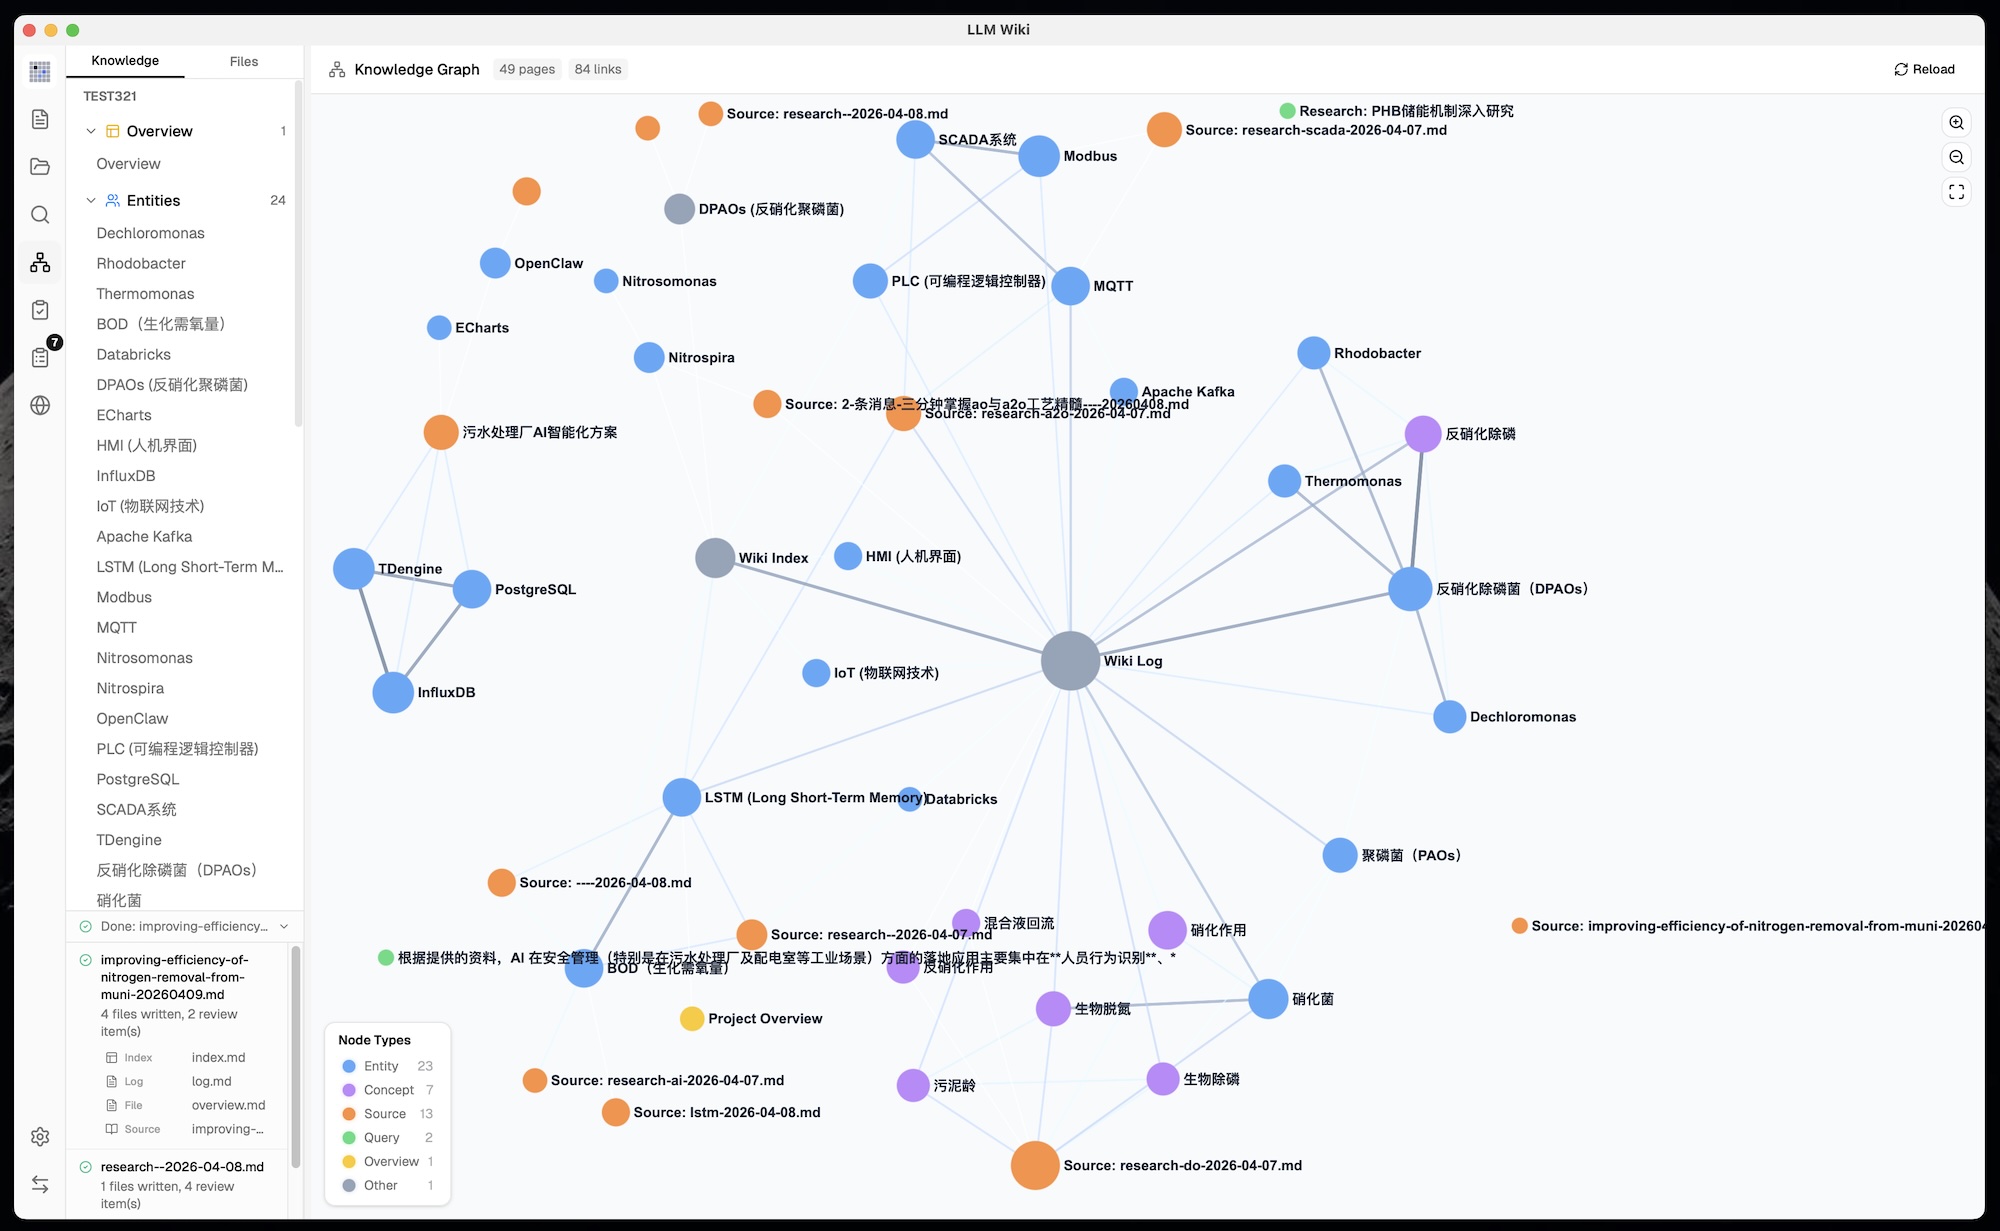
原始方案提到用 [[wikilinks]] 做交叉引用,但没有图谱分析。我们构建了完整的知识图谱可视化和相关性引擎:
4-Signal 相关性模型:
| 信号 | 权重 | 描述 |
|---|---|---|
| Direct link | ×3.0 | 通过 [[wikilinks]] 链接的页面 |
| Source overlap | ×4.0 | 共享同一原始来源的页面(通过 frontmatter sources[]) |
| Adamic-Adar | ×1.5 | 共享共同邻居的页面(按邻居度数加权) |
| Type affinity | ×1.0 | 相同页面类型的加分(entity↔entity、concept↔concept) |
图谱可视化(sigma.js + graphology + ForceAtlas2):
- 节点颜色按页面类型或社区区分,大小按链接数缩放(√ 缩放)
- 边厚度和颜色按相关性权重区分(绿色=强,灰色=弱)
- Hover 交互:邻居保持可见,非邻居变暗,边高亮并显示相关性分数标签
- 缩放控制(ZoomIn、ZoomOut、Fit-to-screen)
- 位置缓存防止数据更新时布局跳动
- 图例根据着色模式在类型计数和社区信息之间切换
5. Louvain 社区检测
原始方案中没有。使用 Louvain 算法(graphology-communities-louvain)自动发现知识聚类:
- 自动聚类 — 基于链接拓扑发现哪些页面自然分组,独立于预定义页面类型
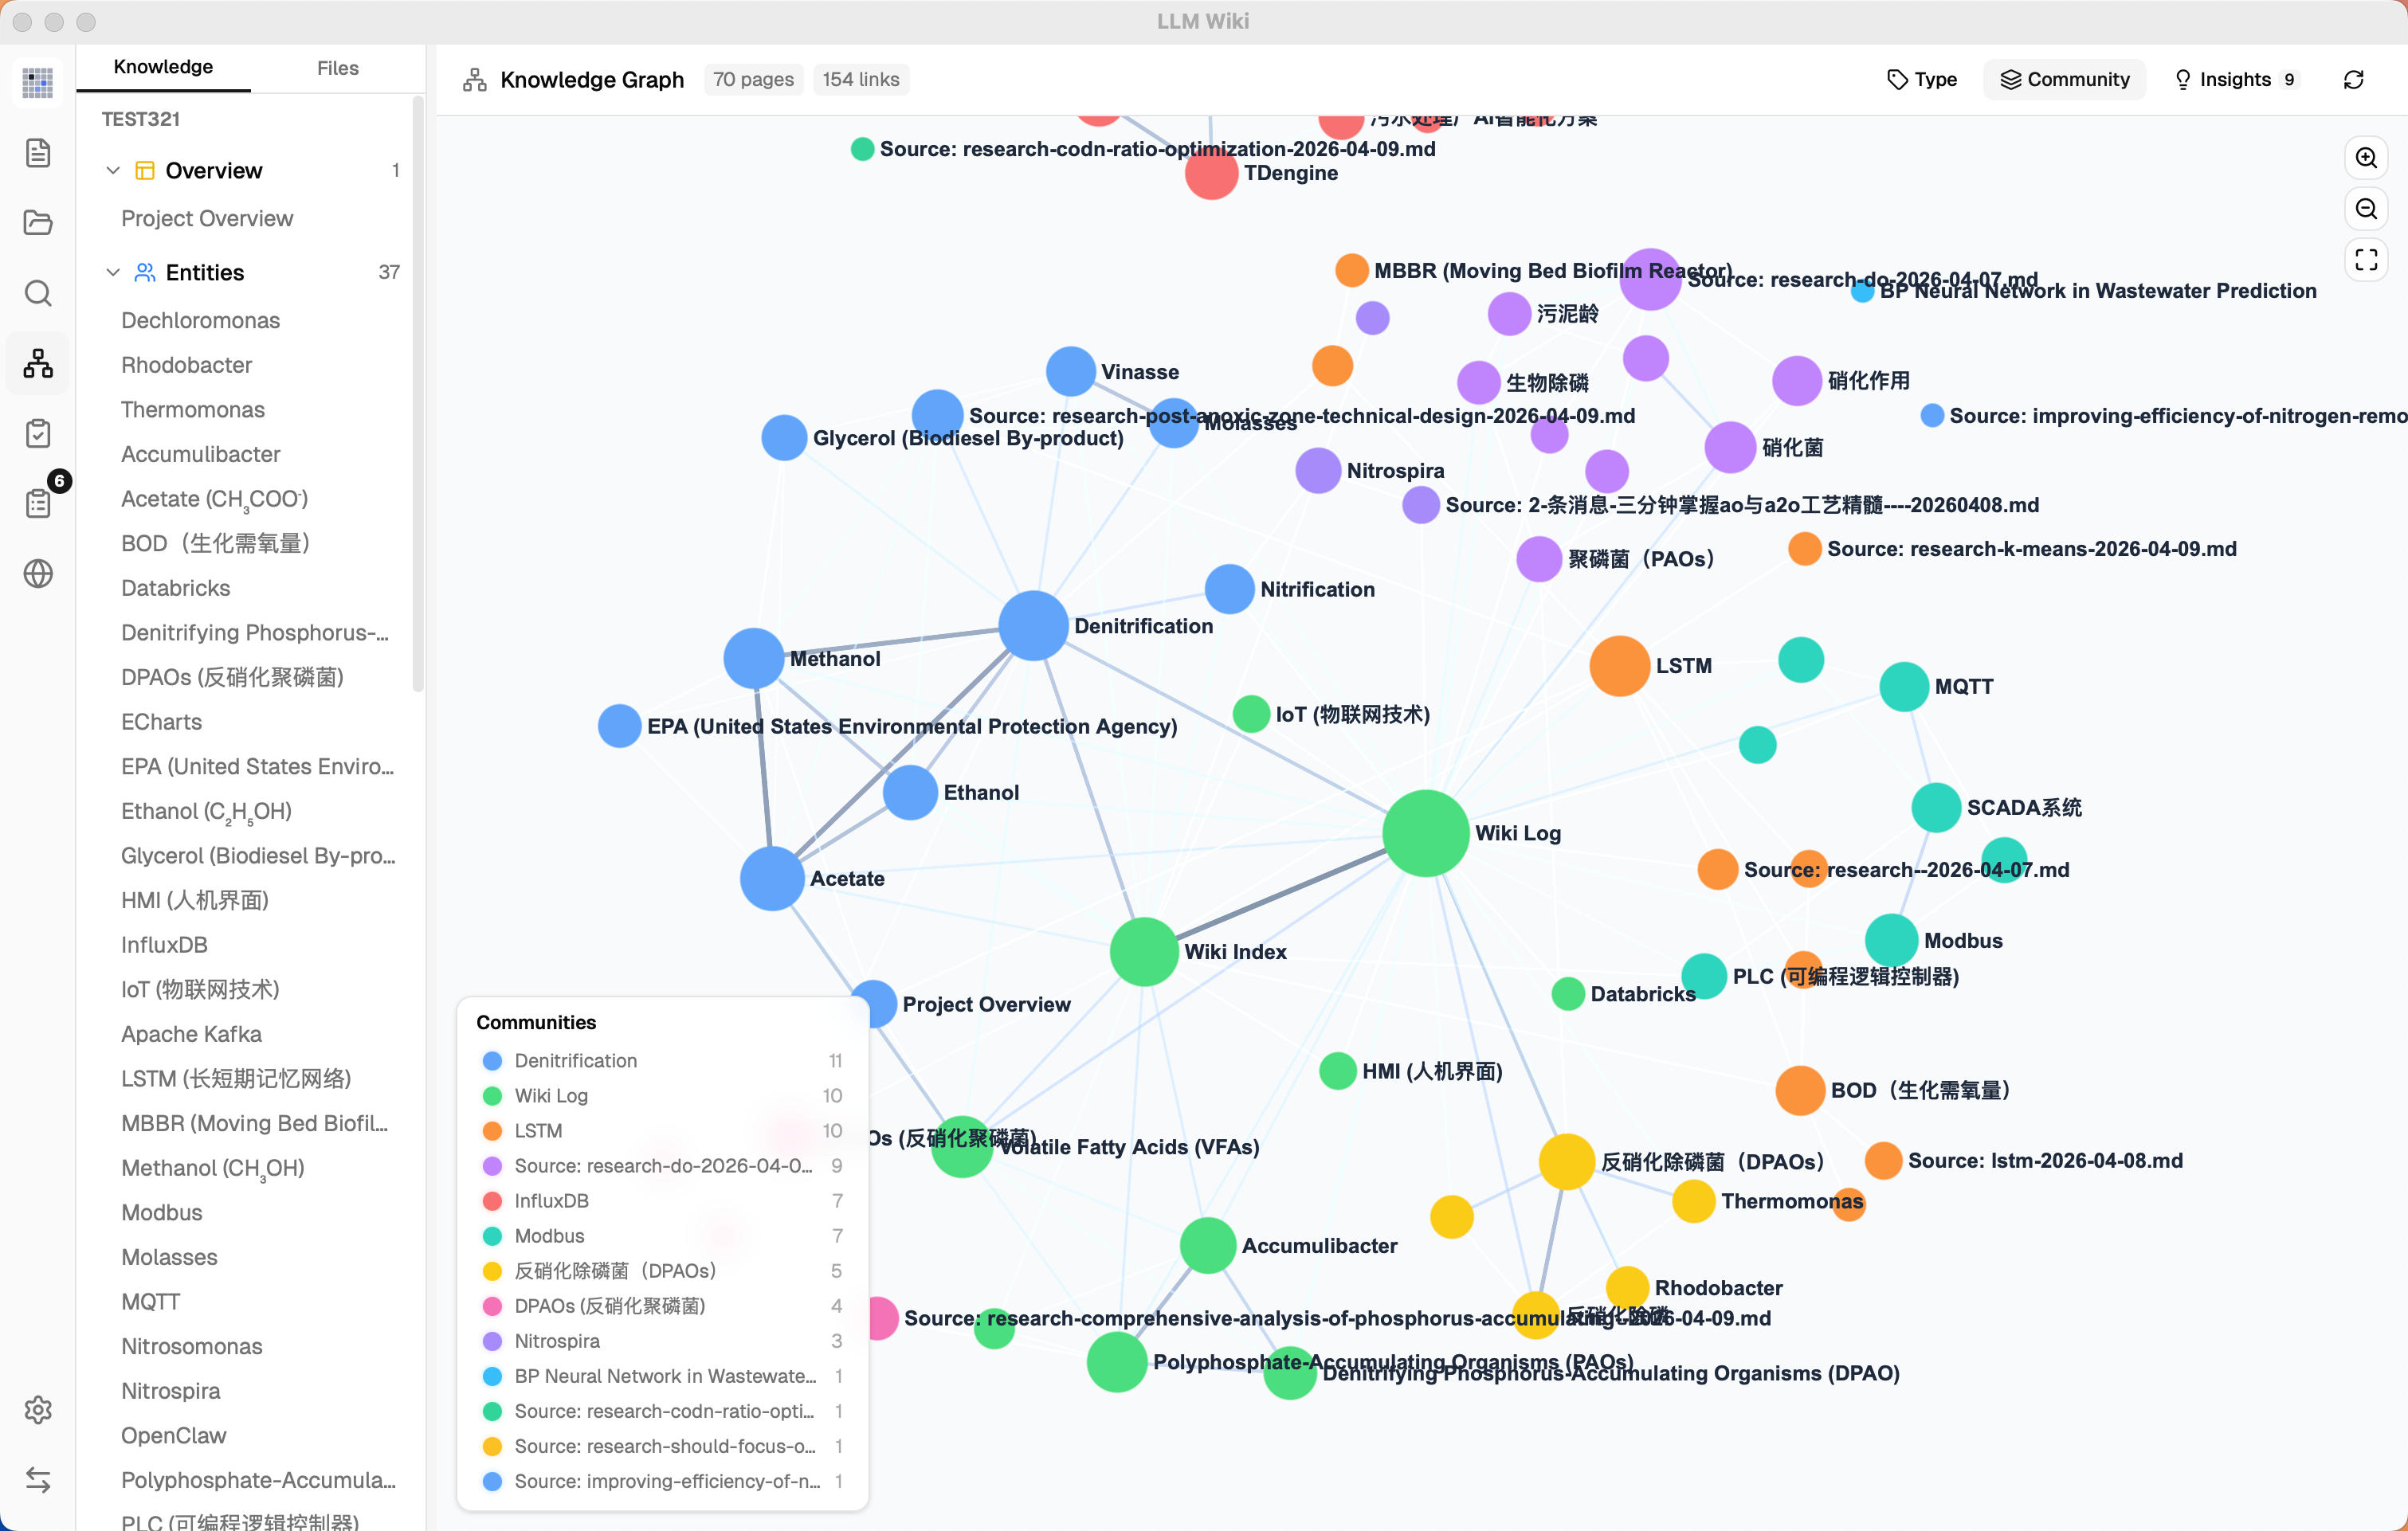
- Type / Community 切换 — 在按页面类型(entity、concept、source...)着色和按发现的知识聚类着色之间切换
- Cohesion 评分 — 每个社区按内部边密度评分(实际边 / 可能边);低 cohesion 聚类(< 0.15)会标记警告
- 12 色调色板 — 聚类之间有清晰的视觉区分
- 社区图例 — 显示每个聚类的 top 节点标签、成员数量和 cohesion
6. 图谱洞察 — 意外连接与知识缺口
原始方案中没有。系统会自动分析图谱结构,呈现可操作的洞察:
意外连接:
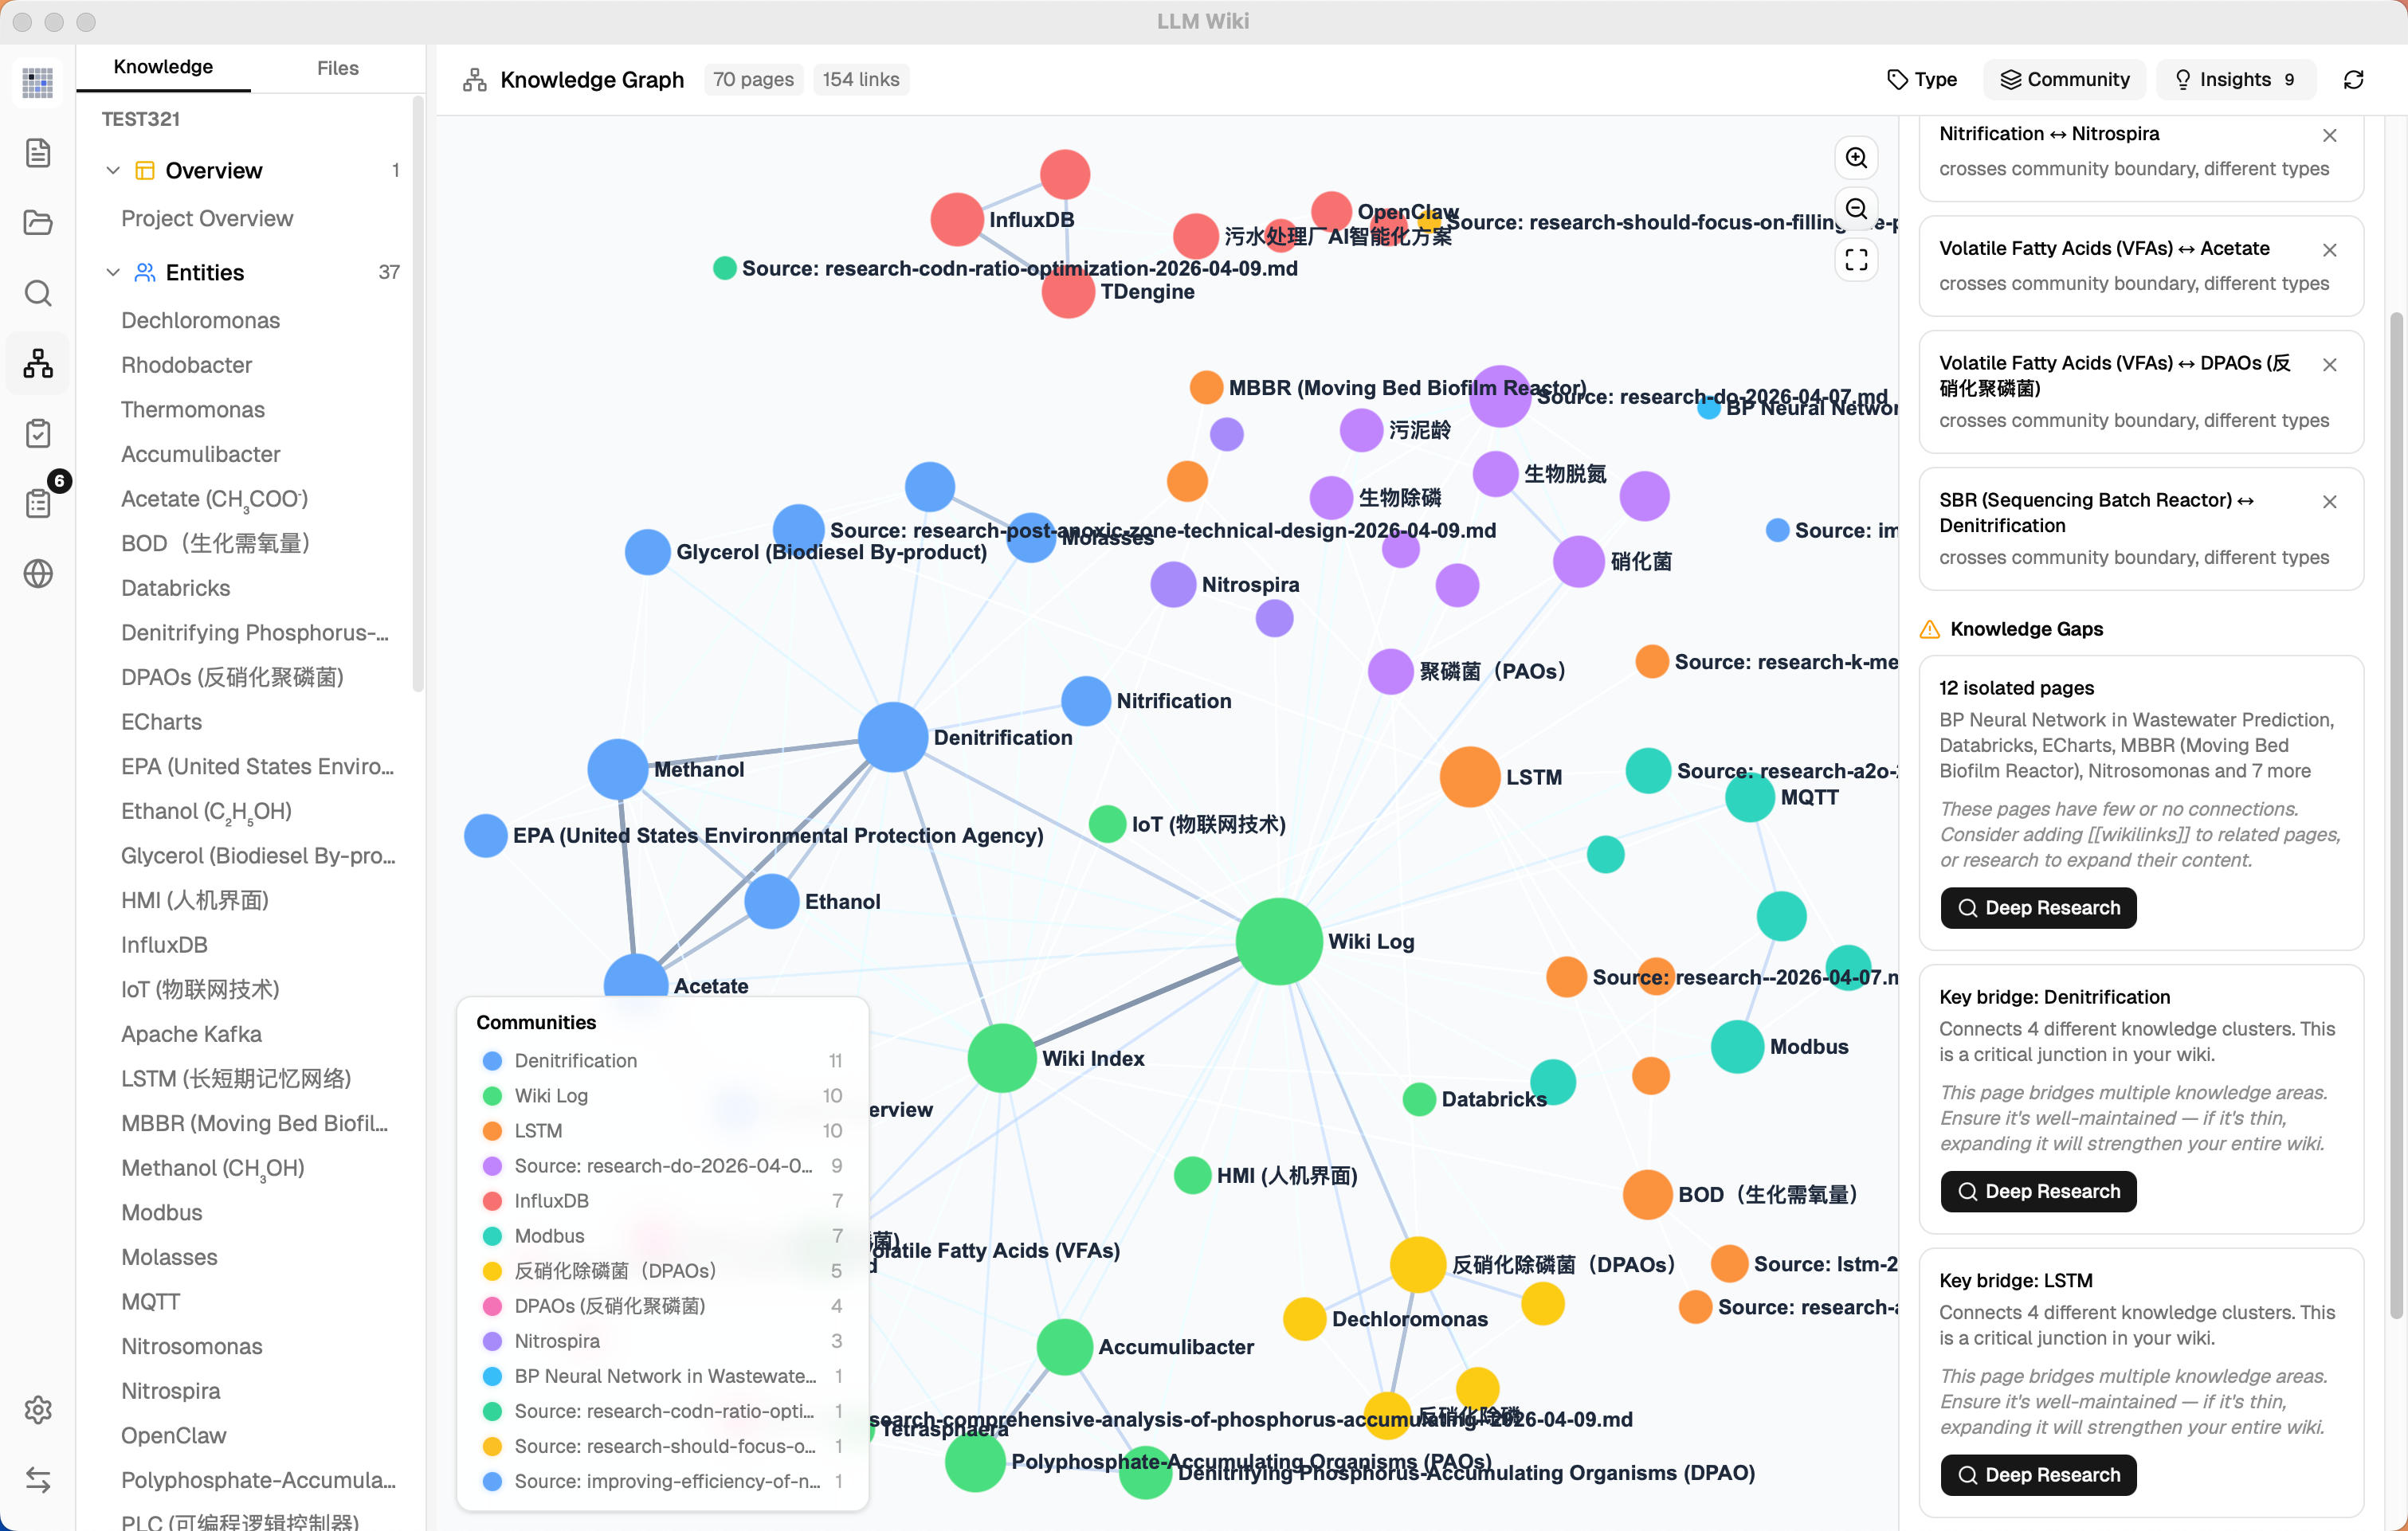
- 检测意想不到的关系:跨社区边、跨类型链接、peripheral↔hub 耦合
- 复合 surprise score 对最值得注意的连接进行排序
- 可忽略 — 将连接标记为已审查,使其不再出现
知识缺口:
- 孤立页面(degree ≤ 1)— 与 wiki 其余部分连接很少或没有连接的页面
- 稀疏社区(cohesion < 0.15,≥ 3 个页面)— 内部交叉引用较弱的知识领域
- 桥接节点(连接 3+ 个聚类)— 将多个知识领域连接在一起的关键枢纽页面
交互式:
- 点击任意洞察卡片可在图谱中高亮对应节点和边;再次点击取消选择
- 知识缺口和桥接节点带有 Deep Research 按钮 — 使用领域感知主题触发 LLM 优化的研究(读取 overview.md + purpose.md 作为上下文)
- 研究主题会在开始前显示在可编辑确认对话框中 — 用户可以细化主题和搜索查询
7. 优化后的 Query 检索流水线
原始方案描述了一个简单查询,让 LLM 读取相关页面。我们构建了多阶段检索流水线,支持可选 vector search 和预算控制:
Phase 1: Tokenized Search
  - English: word splitting + stop word removal
  - Chinese: CJK bigram tokenization (每个 → [每个, 个…])
  - Title match bonus (+10 score)
  - Searches both wiki/ and raw/sources/

Phase 1.5: Vector Semantic Search (optional)
  - Embedding via any OpenAI-compatible /v1/embeddings endpoint
  - Stored in LanceDB (Rust backend) for fast ANN retrieval
  - Cosine similarity finds semantically related pages even without keyword overlap
  - Results merged into search: boosts existing matches + adds new discoveries

Phase 2: Graph Expansion
  - Top search results used as seed nodes
  - 4-signal relevance model finds related pages
  - 2-hop traversal with decay for deeper connections

Phase 3: Budget Control
  - Configurable context window: 4K → 1M tokens
  - Proportional allocation: 60% wiki pages, 20% chat history, 5% index, 15% system
  - Pages prioritized by combined search + graph relevance score

Phase 4: Context Assembly
  - Numbered pages with full content (not just summaries)
  - System prompt includes: purpose.md, language rules, citation format, index.md