RecipeBook by Shofo RecipeBook 是一个视频数据集平台,为 AI 开发者提供海量视频片段搜索和购买服务,帮助快速构建训练数据。 热门评论 PH 用户What's up PH,我是 Braiden,Shofo (YC W26) 的联合创始人。每个训练模型的团队都面临同样的数据抉择:自建还是购买。自建意味着把工程天才花在采集上(逆向工程 API、应付代理、对抗爬取防御、过滤、维护)——所有这些只是为了收集本就公开的数据。购买也好不到哪去。价格从每小时 15 美元到 480 美元不等,而你理想的数据库仍然挡在销售电话、样本、以及数周(有时数月)的采集和迭代墙后面。这段时间可能就是 SOTA 与过时之间的差距。RecipeBook 让你能在同一天内从数百万公开视频中搜索、过滤并构建训练数据集。你用自然语言搜索,用元数据过滤器(fps、分辨率、时长、宽高比)缩小范围,并根据需要对片段投赞成票或反对票。投票后,我们会训练一个分类器,根据你的选择重新排序整个目录,使之符合你的偏好,这样你就能得到精确所需的数据集。(只需几票就能显著改变结果)对结果满意后,输入你需要的时长。比如你要 1000 小时,就会收到一份审查表:分数分布、一个可播放的最差片段网格(按顺序排列,让你看到下限)、以及一个调整滑块(时长和价格都在上面)。以 3 美元/小时的价格结账,几分钟内(取决于购买量,也可能瞬间)你的邮箱就会收到一份包含下载链接的 CSV 清单。最大的缺点是元数据目前还不够强大。语料库上还没有字幕或交互数据(目前),所以搜索纯粹基于视觉。(如果你觉得还有别的问题,请告诉我!!)我们的团队在数据采集和整理方面深耕多年。我们已经索引了互联网上的数十亿个视频,并构建了系统,能够按需以所有模态提供这些数据。在这个过程中我们认识到,你训练模型所需的数据已经公开了,只是你还没找到而已。如果你正在训练视频或多模态模型,试试看,然后告诉我你的想法。如果你知道有团队在寻找大规模视频数据(视频生成、VLM、世界模型、从种子轮到 A 轮),介绍给我们,我请你吃饭。PH 用户我搜索了一个一直想要的棘手烹饪动作,投了几票后的重新排序居然真的精准匹配了。这种无销售电话、按小时付费的体验太清爽了。PH 用户搜索然后购买的流程很巧妙,但在商业使用之前我想先搞清楚的是版权问题,而不是工作流程。“公开可用”和“可用于训练你要出售的模型”是两码事,而这个差距正是当前针对爬虫的许多诉讼的根源。这 2500 万个片段背后有许可/授权层吗?还是说买家得自己去确认某个片段是否安全到可以用于训练? 热门产品Braiden Dishman2026-07-28原文 打开互动版
每个训练模型的团队都面临同样的数据抉择:自建还是购买。自建意味着把工程天才花在采集上(逆向工程 API、应付代理、对抗爬取防御、过滤、维护)——所有这些只是为了收集本就公开的数据。购买也好不到哪去。价格从每小时 15 美元到 480 美元不等,而你理想的数据库仍然挡在销售电话、样本、以及数周(有时数月)的采集和迭代墙后面。这段时间可能就是 SOTA 与过时之间的差距。
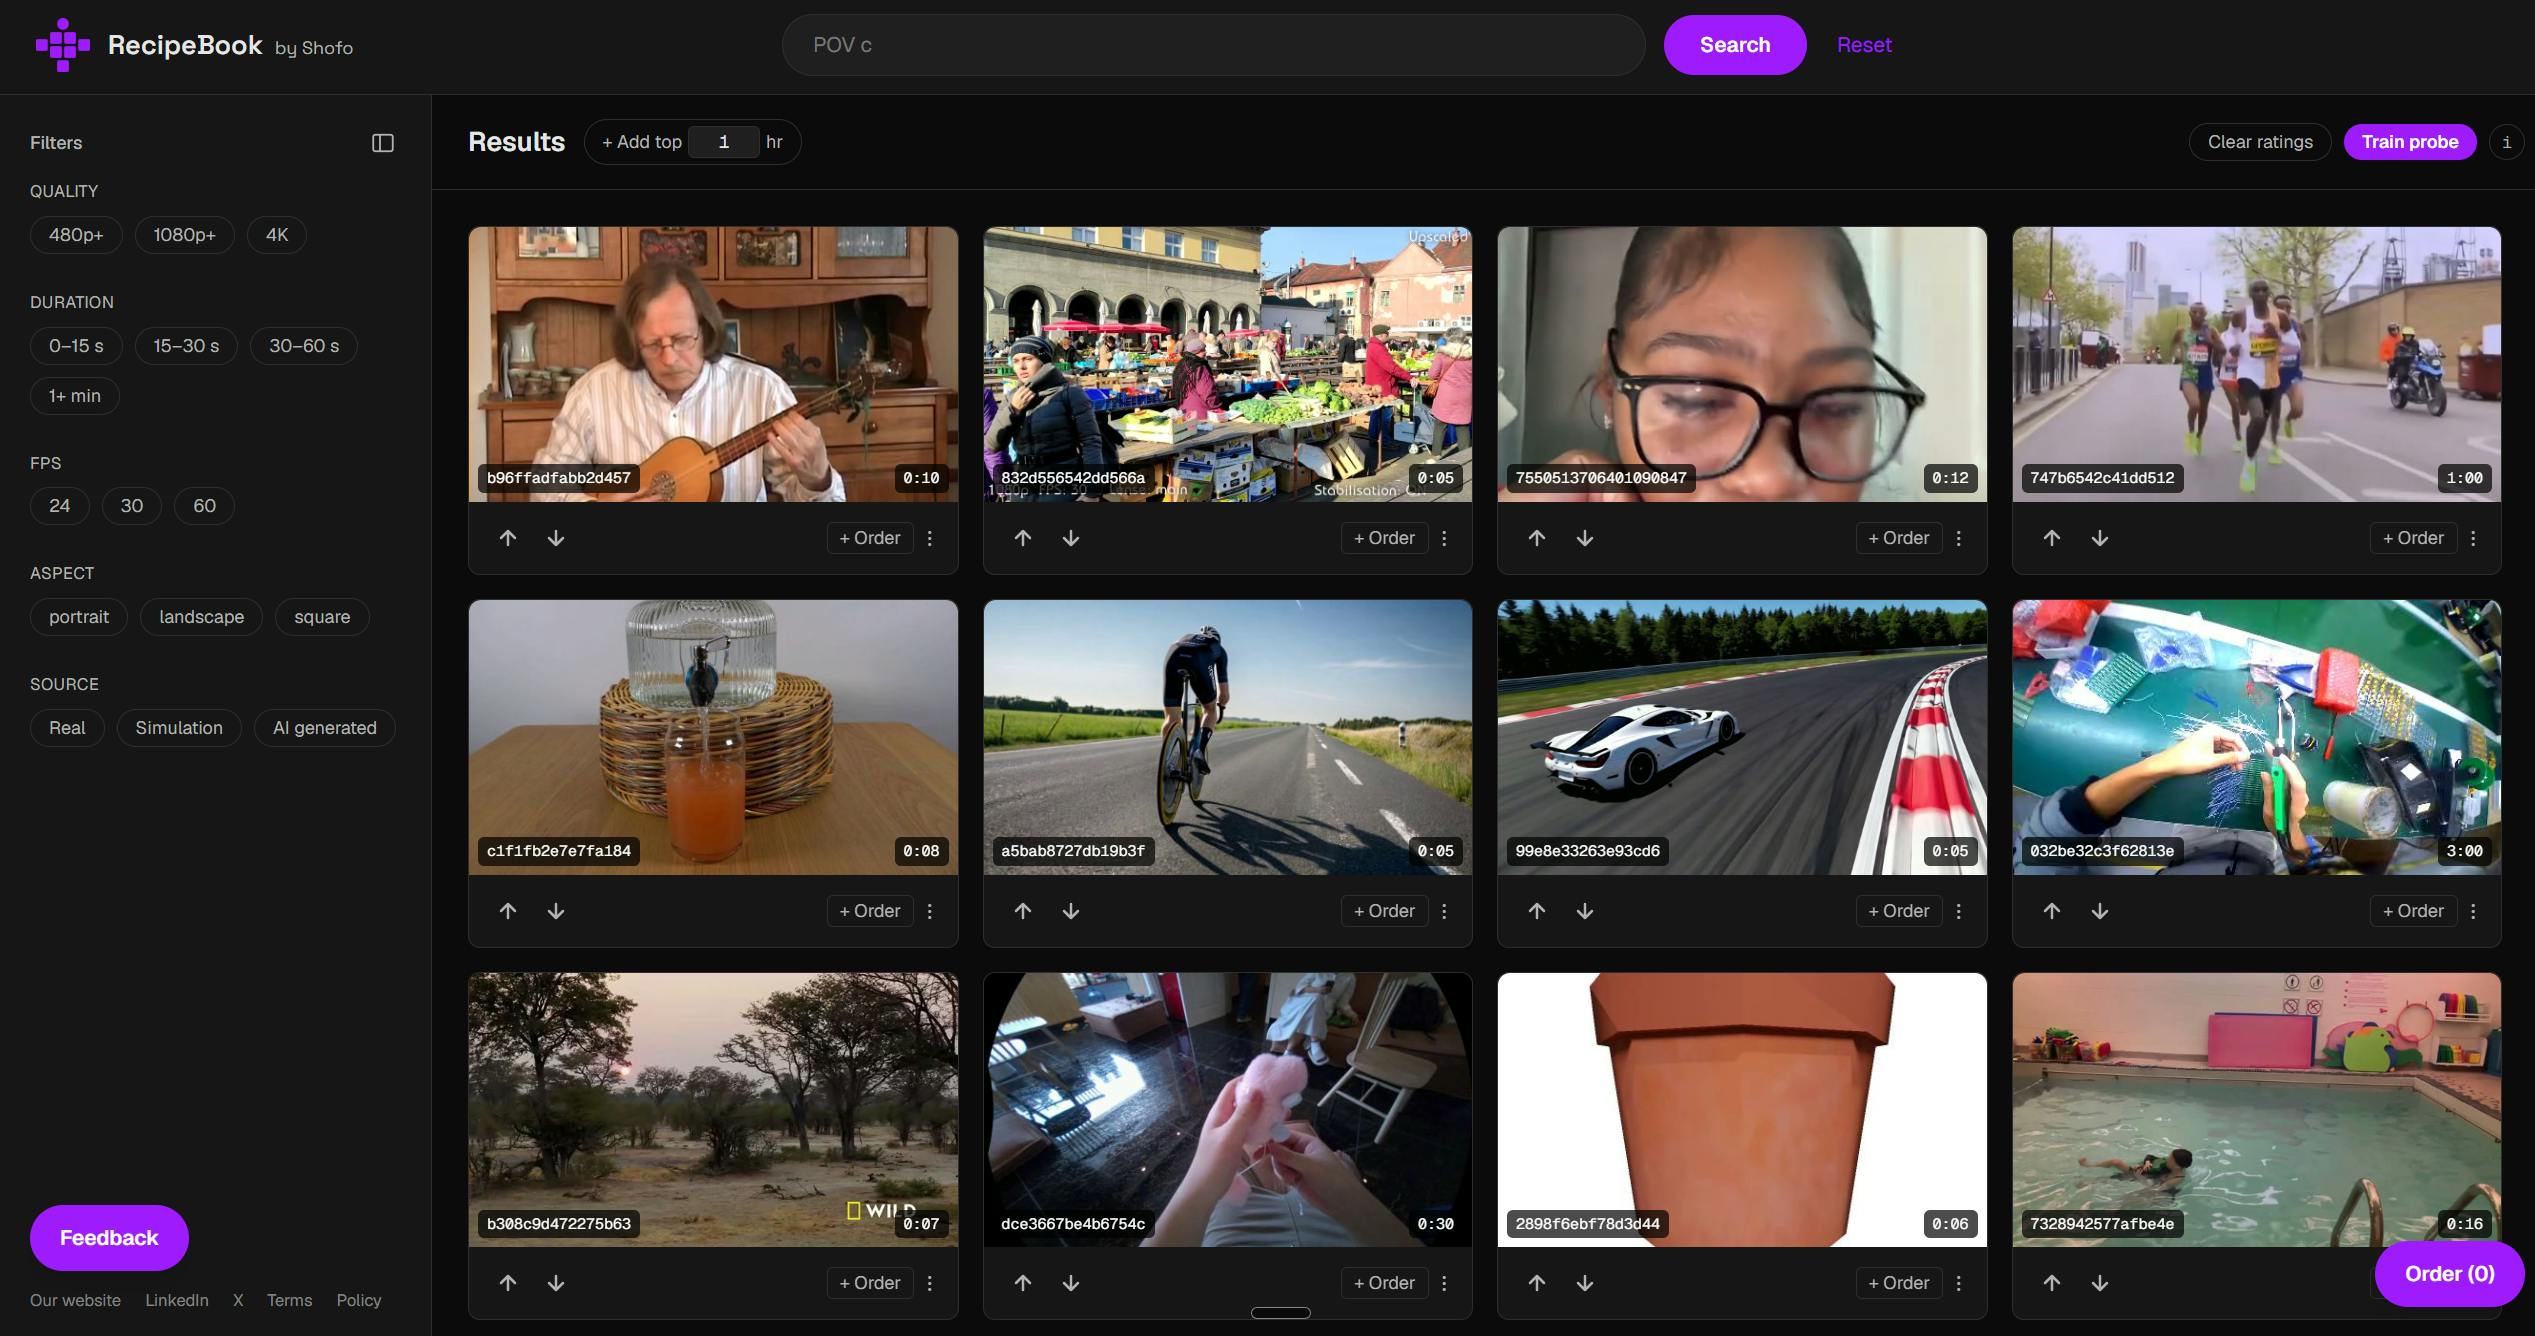
RecipeBook 让你能在同一天内从数百万公开视频中搜索、过滤并构建训练数据集。你用自然语言搜索,用元数据过滤器(fps、分辨率、时长、宽高比)缩小范围,并根据需要对片段投赞成票或反对票。投票后,我们会训练一个分类器,根据你的选择重新排序整个目录,使之符合你的偏好,这样你就能得到精确所需的数据集。(只需几票就能显著改变结果)
对结果满意后,输入你需要的时长。比如你要 1000 小时,就会收到一份审查表:分数分布、一个可播放的最差片段网格(按顺序排列,让你看到下限)、以及一个调整滑块(时长和价格都在上面)。以 3 美元/小时的价格结账,几分钟内(取决于购买量,也可能瞬间)你的邮箱就会收到一份包含下载链接的 CSV 清单。
最大的缺点是元数据目前还不够强大。语料库上还没有字幕或交互数据(目前),所以搜索纯粹基于视觉。(如果你觉得还有别的问题,请告诉我!!)
我们的团队在数据采集和整理方面深耕多年。我们已经索引了互联网上的数十亿个视频,并构建了系统,能够按需以所有模态提供这些数据。在这个过程中我们认识到,你训练模型所需的数据已经公开了,只是你还没找到而已。
如果你正在训练视频或多模态模型,试试看,然后告诉我你的想法。
如果你知道有团队在寻找大规模视频数据(视频生成、VLM、世界模型、从种子轮到 A 轮),介绍给我们,我请你吃饭。