Webhound Webhound是一个为智能体设计的研究引擎,用户设定预算后自动追踪线索并验证信息,生成带引用的报告,适合需要深度信息验证的场景。 热门评论 PH 用户Hi Product Hunt,我是 Moe,Webhound 的创始人。我从 2023 年开始做 AI 研究。我创办 Webhound 是因为研究类智能体有一个“何时停止”的问题。写代码的智能体可以在测试通过时停下来。研究没有类似的终点线。同一个问题,智能体可能花十分钟、两小时或二十小时,而且每个答案看起来都很完整。研究智能体往往在收集到足够证据、听起来很自信时就停下来。但你并不知道它跳过了哪些线索、哪些来源存在分歧,也不知道再多花一小时会不会发现那个改变你决策的事实。智能体替你做了停止的决定。我们的核心理念是:预算应该成为研究的一个基本原语。用大白话说,你的 prompt 告诉 Webhound 要研究什么,你的美元预算则告诉它投入多少工作量,并设定上限。按我们目前的费率,5 美元大约能支撑 75 分钟的研究。搜索会针对当前 query 找来源。研究则阅读这些来源,并顺着它们揭示的线索深入。一个来源可能改变 Webhound 下一步需要搜索的内容。你会得到一份带有引用的报告或附带来源的数据集,以及背后的来源和研究笔记。你可以查看 Webhound 是如何得出结论的,以及调查中还有哪些缺口。额外的预算必须物有所值。我们评判一次更大规模的研究,依据的是它增加了多少有用证据,以及这些证据是否改善了你的决策。单纯增加时长不算数。你可以在 Webhound 应用内使用它,也可以把它接入 Codex、Claude Code、Cursor、Manus 或你自己的软件。你的智能体可以移交一个问题,继续工作,稍后再取回已完成的研究结果。新账户会获赠一份 5 美元的报告或数据集。没有订阅。我希望得到关于核心想法的直言反馈:用美元预算来控制研究量,这个方式感觉有用吗?来源和研究笔记能帮你判断哪些信息值得信任吗?如果你有一个问题,缺失信息的代价可能超过研究本身,就在下面留言。我们今天会公开跑几个例子。PH 用户用美元预算作为停止原语,这个思路真的很干净。大多数研究工具只是在输出听起来很自信时就停下来,而不是真正验证过。有一点我没看到提及——当两个来源对某个说法确实存在分歧,而预算不足以彻底解决时,最终报告是会明确展示这种分歧,还是会选一个立场(多数来源、更高权威的域名等)并给出一个答案?对于一款带引用的研究工具,我其实希望看到未解决的分歧被指出来,而不是被平滑掉。PH 用户它只搜索公开网站吗,还是也能处理我自己的文档和内部知识库?PH 用户非常喜欢“用户引导应该是一个 MCP endpoint”这个框架——那种序列化的下一步模式很干净。有一个边界情况我很好奇:如果健康检查通过了,但 5 步中的第 3 步因为配置不匹配失败,endpoint 是期望智能体从该步骤重试,还是重新启动整个序列?在这种多步握手过程中的部分失败处理,似乎需要和正常流程分开单独设计。PH 用户透明度方面真的很吸引我。实际展示给用户的研究过程和推理逻辑,有没有什么限制?PH 用户Hi Product Hunt,我是 Theo,Webhound 的另一个创始人。既然 Moe 已经介绍了很多关于我们产品的内容,我想就设计这个更面向智能体的版本中学到的一些(确实有点乱)想法分享给大家。最近我和联合创始人注意到,我们很多最稳定的用户其实都是智能体,而且这个占比还在增长。当我们的讨论开始转向为智能体做设计时,我的问题变成了:我们真的应该这么做吗?我认为现在还不应该专门为智能体设计。这不(完全)是因为我倾向于以人为本的设计,而是出于一个归因问题/论点。当我们与那些可以自由使用我们产品的智能体背后的用户交流时,反复听到的是:“我不想离开我的第二大脑。” 记忆、上下文和集成正在造成类似社交媒体上社交图谱那样的锁定效应。我聊过的很多创始人都相信这种情况会改变,未来我们会使用各种不同的 AI 界面。我的反驳是回想到我当年在 iPod touch 上装过的无数 App(相比之下现在我只用 3-4 个 App,更不用说那些被浓缩进 iPhone 的硬件产品了)。每当新技术爆发时,工具似乎都会经历一个分化过程,然后我们又回归到单一界面模式。如果我们假设人们会从一个中心化界面工作,那么我开始思考的模型就高度依赖控制面(control surface)——人类意图如何注入其中,以及在这个平台/工具内部有哪些我看不到的步骤。当我谈论为智能体设计时,我不是把智能体当作最终用户。作为人机交互专业的学生,我仍然认为人类才是最终用户。只是人类意志和硅执行之间多了几层抽象。这就是为什么我认为把控制面纳入思维模型很重要——思考人类目标/输入是在哪里进入系统的。基于这个前提,以下是我实际学到的一些东西:对于开放式任务,预算是比“主观完成标准 + LLM 作为裁判(承包人)”更好的停止原语。记忆、工作区/文件结构以及集成会形成锁定。尽量构建一个让用户尽可能少离开他们第二大脑的产品。错误信息应该详细并暗示修复方法。因为很多失败和行为发生在用户智能体那一侧,很难观察到这些失败模式。尽量通过错误日志来捕获它们。定义你的交互规则/最佳实践,指导智能体如何与你的工具互动以及何时调用。不需要阻塞的时候就别阻塞。让状态和状态可见,避免挂起/阻塞主智能体。新手引导应该是一个 MCP 端点,并且通过用户的智能体完成。当用户创建密钥时,给用户一段文本提示让他们复制到智能体中以配置 MCP。在这段提示中,要求智能体说明它处于什么环境(Claude Code、Codex 等),使用该客户端支持的全局 MCP 配置(除非用户希望是项目级别),保存你给出的确切服务器配置,调用健康端点以避免安装成功的误报,然后调用你的新手引导端点。我们发现,当新手引导端点按顺序返回步骤,并且你要求用户的智能体持续调用“下一步”直到返回没有剩余步骤时,效果最好。还有一个意图监控功能,你可以通过工具搜索看到人们要求他们的智能体用你的工具做什么。我们决定不做这个,因为感觉太不礼貌了,不过我们确实考虑过。这些是深入钻研几周后学到的东西,希望对你们中的一些人有用,不过我也预计它们会随着界面演化而很快过时。 热门产品Moe Khalil2026-07-27原文 打开互动版
我创办 Webhound 是因为研究类智能体有一个“何时停止”的问题。
写代码的智能体可以在测试通过时停下来。研究没有类似的终点线。同一个问题,智能体可能花十分钟、两小时或二十小时,而且每个答案看起来都很完整。研究智能体往往在收集到足够证据、听起来很自信时就停下来。
但你并不知道它跳过了哪些线索、哪些来源存在分歧,也不知道再多花一小时会不会发现那个改变你决策的事实。智能体替你做了停止的决定。
我们的核心理念是:预算应该成为研究的一个基本原语。用大白话说,你的 prompt 告诉 Webhound 要研究什么,你的美元预算则告诉它投入多少工作量,并设定上限。按我们目前的费率,5 美元大约能支撑 75 分钟的研究。
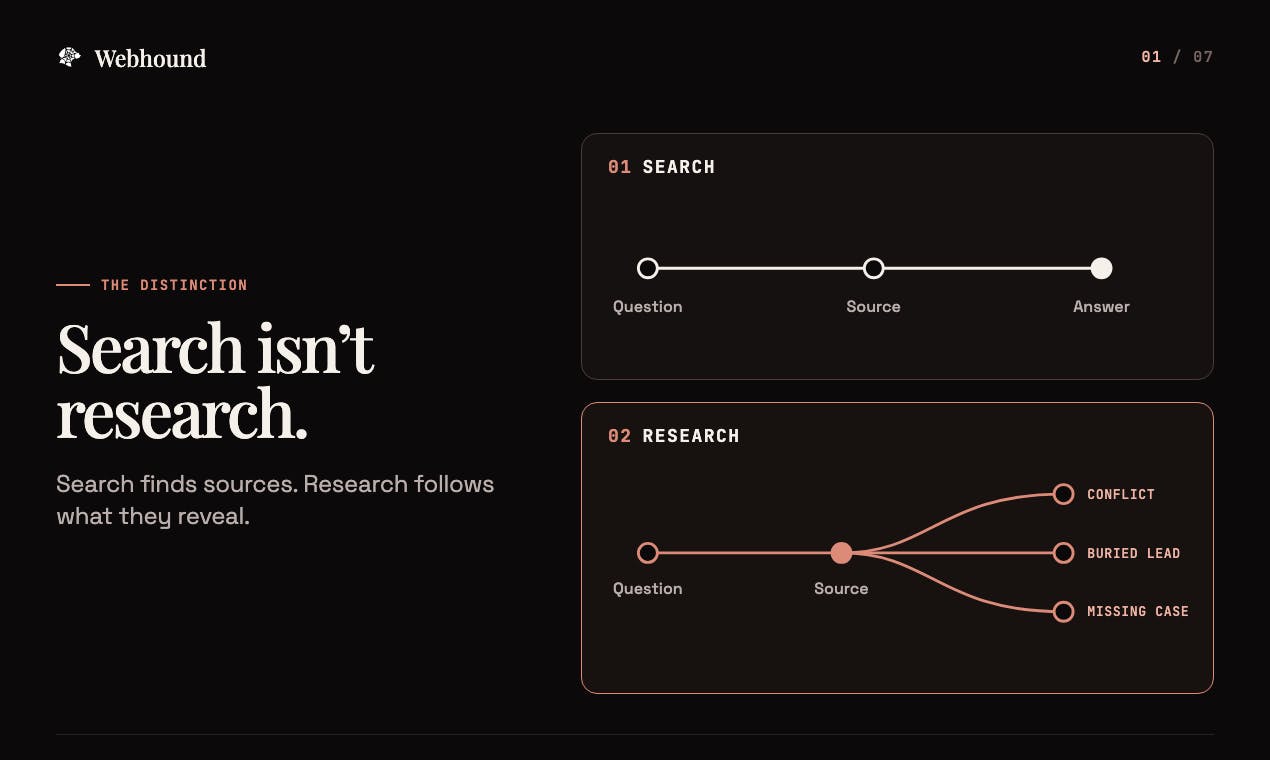
搜索会针对当前 query 找来源。研究则阅读这些来源,并顺着它们揭示的线索深入。一个来源可能改变 Webhound 下一步需要搜索的内容。
你会得到一份带有引用的报告或附带来源的数据集,以及背后的来源和研究笔记。你可以查看 Webhound 是如何得出结论的,以及调查中还有哪些缺口。
额外的预算必须物有所值。我们评判一次更大规模的研究,依据的是它增加了多少有用证据,以及这些证据是否改善了你的决策。单纯增加时长不算数。
你可以在 Webhound 应用内使用它,也可以把它接入 Codex、Claude Code、Cursor、Manus 或你自己的软件。你的智能体可以移交一个问题,继续工作,稍后再取回已完成的研究结果。
新账户会获赠一份 5 美元的报告或数据集。没有订阅。
我希望得到关于核心想法的直言反馈:用美元预算来控制研究量,这个方式感觉有用吗?来源和研究笔记能帮你判断哪些信息值得信任吗?
如果你有一个问题,缺失信息的代价可能超过研究本身,就在下面留言。我们今天会公开跑几个例子。
既然 Moe 已经介绍了很多关于我们产品的内容,我想就设计这个更面向智能体的版本中学到的一些(确实有点乱)想法分享给大家。
最近我和联合创始人注意到,我们很多最稳定的用户其实都是智能体,而且这个占比还在增长。当我们的讨论开始转向为智能体做设计时,我的问题变成了:我们真的应该这么做吗?
我认为现在还不应该专门为智能体设计。这不(完全)是因为我倾向于以人为本的设计,而是出于一个归因问题/论点。
当我们与那些可以自由使用我们产品的智能体背后的用户交流时,反复听到的是:“我不想离开我的第二大脑。” 记忆、上下文和集成正在造成类似社交媒体上社交图谱那样的锁定效应。
我聊过的很多创始人都相信这种情况会改变,未来我们会使用各种不同的 AI 界面。我的反驳是回想到我当年在 iPod touch 上装过的无数 App(相比之下现在我只用 3-4 个 App,更不用说那些被浓缩进 iPhone 的硬件产品了)。
每当新技术爆发时,工具似乎都会经历一个分化过程,然后我们又回归到单一界面模式。
如果我们假设人们会从一个中心化界面工作,那么我开始思考的模型就高度依赖控制面(control surface)——人类意图如何注入其中,以及在这个平台/工具内部有哪些我看不到的步骤。
当我谈论为智能体设计时,我不是把智能体当作最终用户。作为人机交互专业的学生,我仍然认为人类才是最终用户。只是人类意志和硅执行之间多了几层抽象。这就是为什么我认为把控制面纳入思维模型很重要——思考人类目标/输入是在哪里进入系统的。
基于这个前提,以下是我实际学到的一些东西:
对于开放式任务,预算是比“主观完成标准 + LLM 作为裁判(承包人)”更好的停止原语。
记忆、工作区/文件结构以及集成会形成锁定。尽量构建一个让用户尽可能少离开他们第二大脑的产品。
错误信息应该详细并暗示修复方法。因为很多失败和行为发生在用户智能体那一侧,很难观察到这些失败模式。尽量通过错误日志来捕获它们。
定义你的交互规则/最佳实践,指导智能体如何与你的工具互动以及何时调用。
不需要阻塞的时候就别阻塞。让状态和状态可见,避免挂起/阻塞主智能体。
新手引导应该是一个 MCP 端点,并且通过用户的智能体完成。当用户创建密钥时,给用户一段文本提示让他们复制到智能体中以配置 MCP。
在这段提示中,要求智能体说明它处于什么环境(Claude Code、Codex 等),使用该客户端支持的全局 MCP 配置(除非用户希望是项目级别),保存你给出的确切服务器配置,调用健康端点以避免安装成功的误报,然后调用你的新手引导端点。
我们发现,当新手引导端点按顺序返回步骤,并且你要求用户的智能体持续调用“下一步”直到返回没有剩余步骤时,效果最好。
还有一个意图监控功能,你可以通过工具搜索看到人们要求他们的智能体用你的工具做什么。我们决定不做这个,因为感觉太不礼貌了,不过我们确实考虑过。
这些是深入钻研几周后学到的东西,希望对你们中的一些人有用,不过我也预计它们会随着界面演化而很快过时。