Hyperresearch 面向研究人员与开发者的智能研究代理,自动检索并生成带来源引用的报告,支持 MCP 与 API 调用,降低幻觉。 热门评论 PH 用户Product Hunt 的朋友们,大家好,我是 Jordan,我做了 Hyperresearch。一开始它只是个开源 repo(现在仍然是 MIT 协议)。每个数据 API 都有盲区,因为每家提供商看到的只是网络的不同切片,所以我把能接入的提供商尽量叠加起来,一个漏掉的,另一个能补上。我也很烦 deep research 不够持久,所以 Hyperresearch 会保留每次运行读到的所有来源,之后你可以搜索这些来源,在已有研究基础上继续做,而不用从头再来。里面包括:研究报告。Deep Search 会跑 3 到 5 小时,覆盖约 150 到 200 个来源,报告发布前,每条被引用的说法都会对照来源复核。来源库。一次运行读到的来源会留在你的工作区,可在控制台或 MCP 中按关键词或语义搜索。本周新推出的 Answers MCP。把 hyperresearch-answers 加到 Claude Code、Cursor 或任何 MCP 客户端,调用 ask 会返回一个简短答案,附带已对照来源页面核验过的逐字引用;如果找不到,就返回 not_found,而不是猜一个答案。而 search 会返回排好序的来源,并逐字复制相关段落。每个账户送 $5 免费额度,无需绑卡。我们在 DRACO deep research benchmark 上拿了第一。在 100 道 BrowseComp 题(Answers MCP)中,Answers 得分 89%,Parallel pro 得分 73%,Perplexity Sonar Pro 得分 43%,Exa answer 得分 12%,也就是说我们也是目前市面上第一的研究任务 API。绑卡后,第一次 Deep run 免费。我想请大家帮个忙:给 Answers 一个你的智能体现在会查错的查询,然后告诉我它是给出了答案还是返回了 not_found,以及这次判断对不对。- JordanPH 用户我们最容易查错的是公司信息,比如有多少工程师、是否被收购;我们试过的数据工具落后 6 到 18 个月。答案会显示它引用的页面有多旧吗,这样智能体就能分辨旧的人员规模还是今年的?PH 用户持久性这一点是我最看重的差异——如果证据链蒸发了,一次跑 3 到 5 小时、覆盖 150 到 200 个来源的运行就白费了,所以把每个来源都放进可搜索的来源库,并把每条被引用的说法对照来源核验,这个做法是对的。关于来源库有个问题:如果某个来源页面在一次运行后发生变化或消失,引用仍会解析到那次运行实际读到的版本,还是会指向当前线上页面?PH 用户“Not found”而不是编一个答案,这才是重点功能。我们写医疗健康内容,每个数据都需要真实来源,最怕的就是一本正经的假数字。它会从 PubMed 这样的医学期刊里取数吗?PH 用户在这里我最在意的承诺,是拿到一个直白的 not found,而不是自信的胡编;而把每条引用的说法都对照来源核验,才会让我愿意把真正的问题交给研究智能体。PH 用户把来源都保留下来,这一点最吸引我。追问时不该意味着得把同样的页面再找一遍。 热门产品Jordan Gibbs2026-11-02原文 打开互动版
一开始它只是个开源 repo(现在仍然是 MIT 协议)。每个数据 API 都有盲区,因为每家提供商看到的只是网络的不同切片,所以我把能接入的提供商尽量叠加起来,一个漏掉的,另一个能补上。
我也很烦 deep research 不够持久,所以 Hyperresearch 会保留每次运行读到的所有来源,之后你可以搜索这些来源,在已有研究基础上继续做,而不用从头再来。
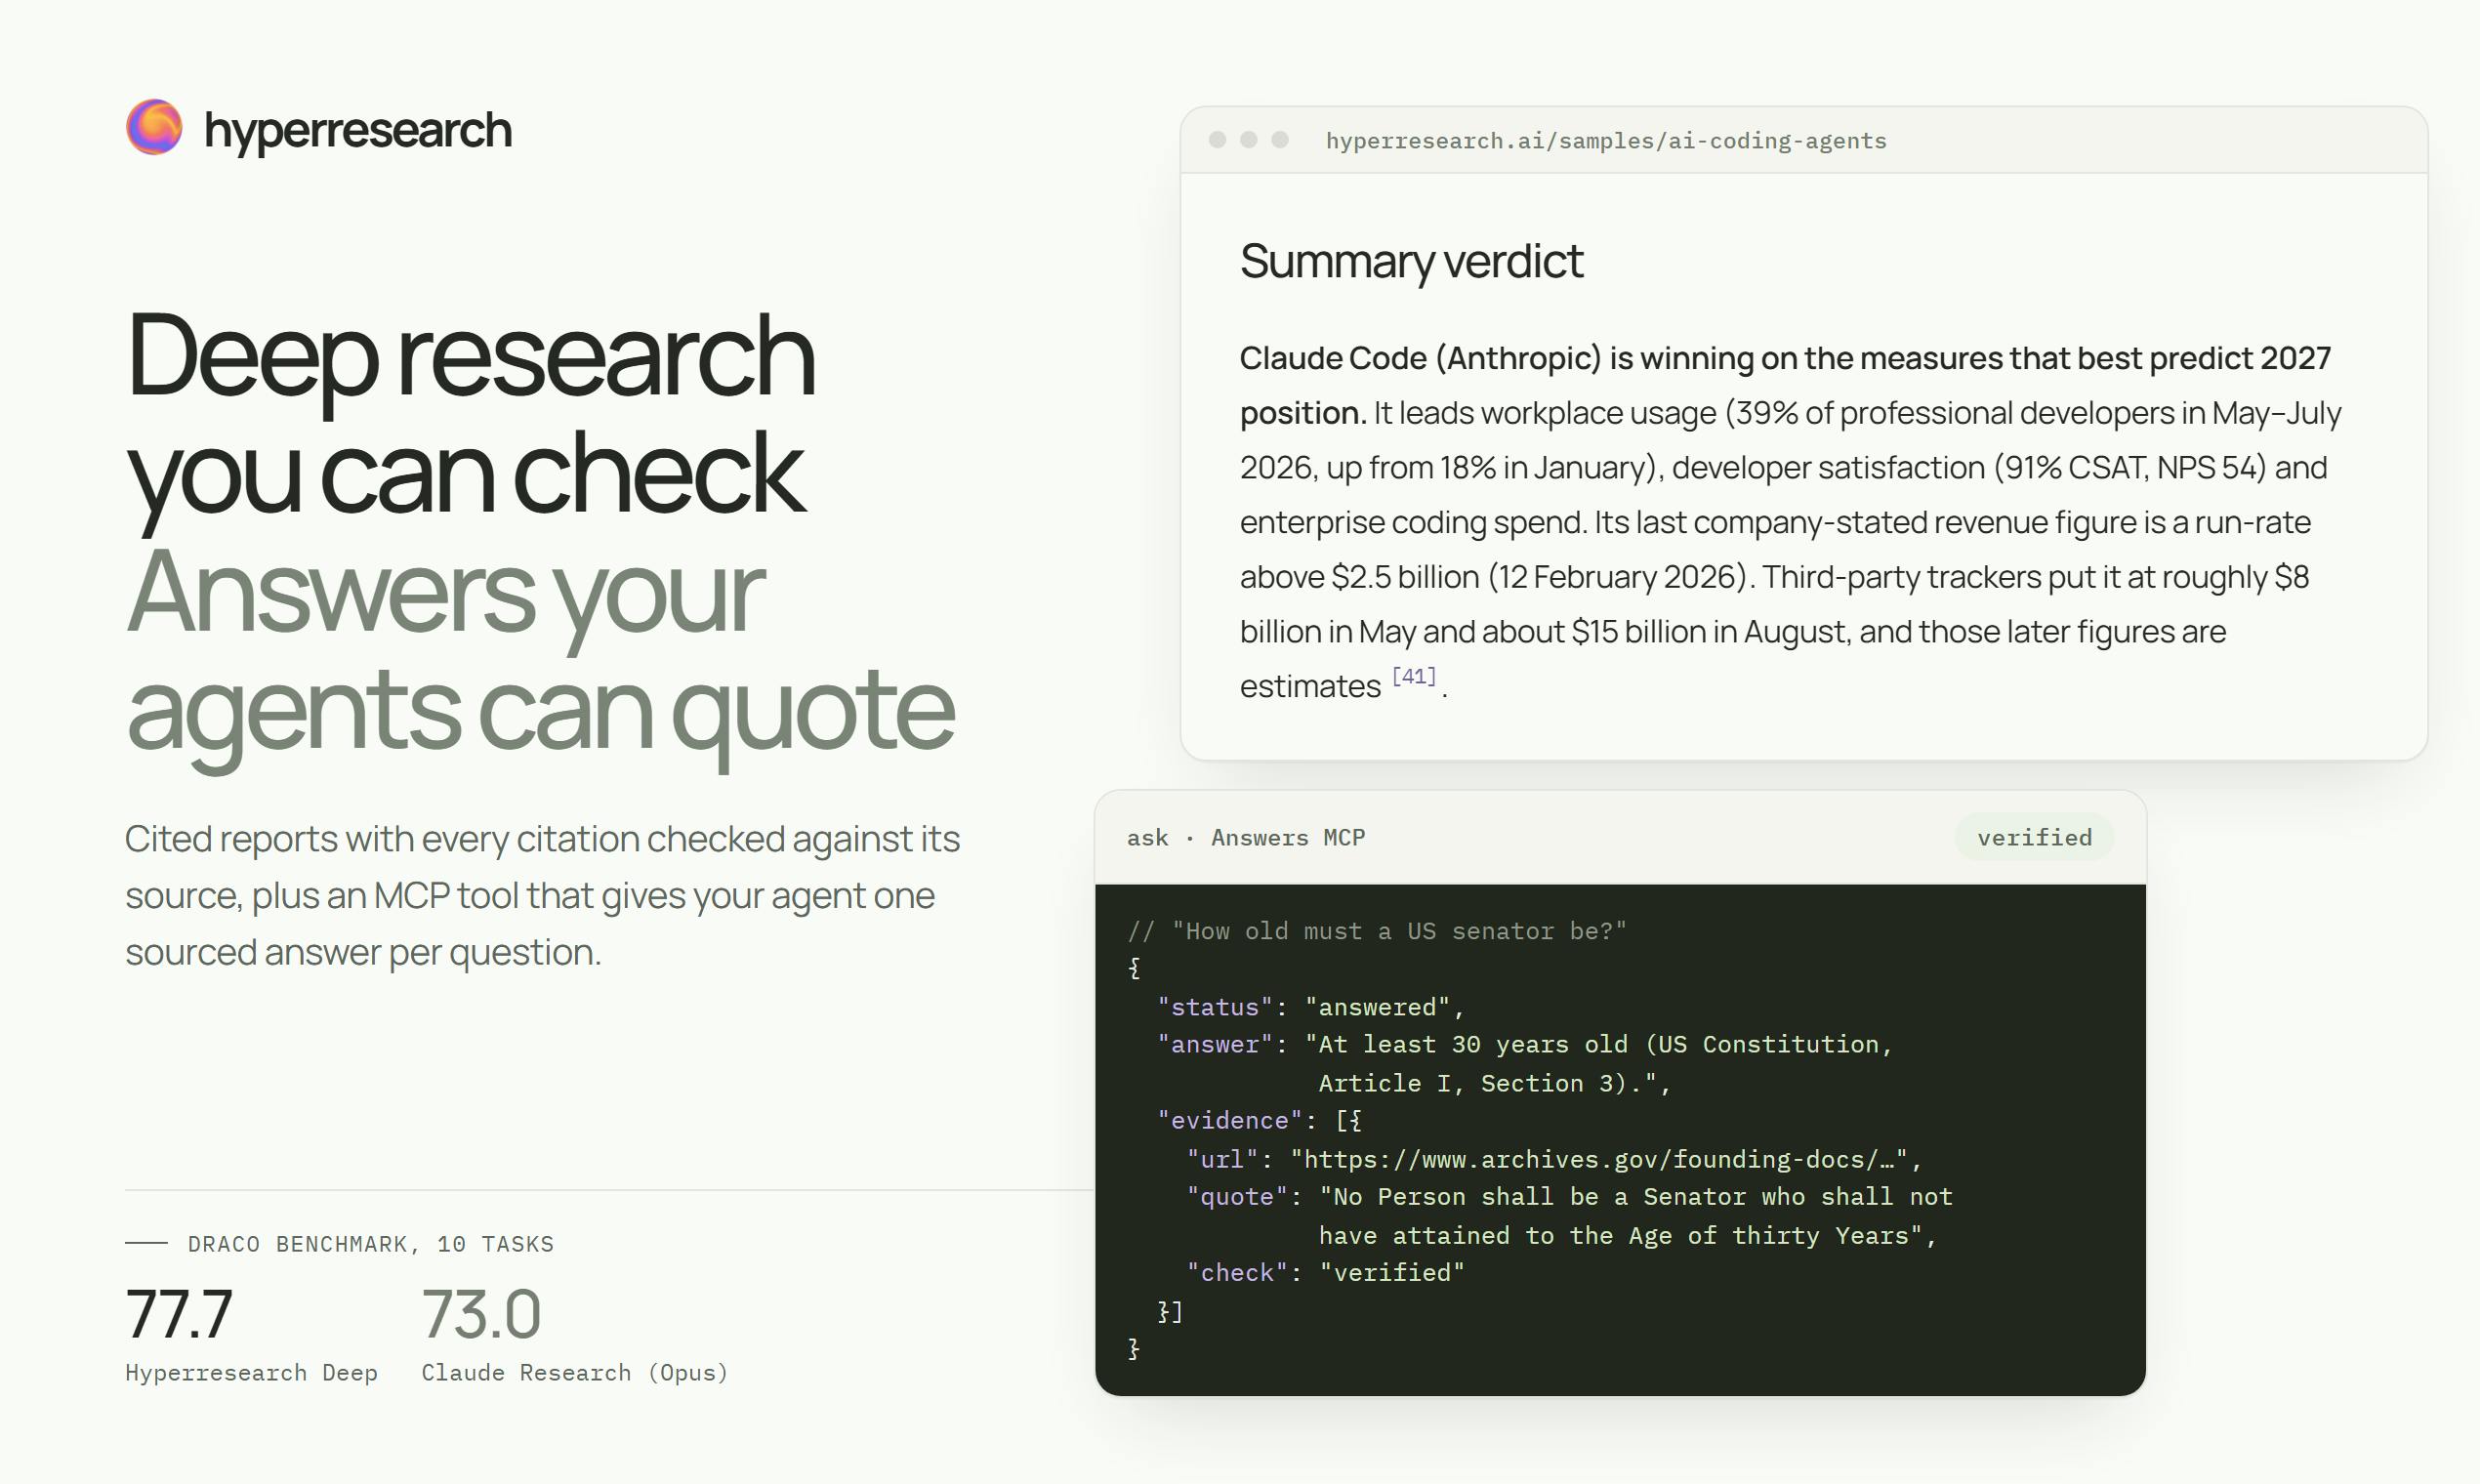
里面包括:研究报告。Deep Search 会跑 3 到 5 小时,覆盖约 150 到 200 个来源,报告发布前,每条被引用的说法都会对照来源复核。来源库。一次运行读到的来源会留在你的工作区,可在控制台或 MCP 中按关键词或语义搜索。本周新推出的 Answers MCP。把 hyperresearch-answers 加到 Claude Code、Cursor 或任何 MCP 客户端,调用 ask 会返回一个简短答案,附带已对照来源页面核验过的逐字引用;如果找不到,就返回 not_found,而不是猜一个答案。而 search 会返回排好序的来源,并逐字复制相关段落。每个账户送 $5 免费额度,无需绑卡。我们在 DRACO deep research benchmark 上拿了第一。
在 100 道 BrowseComp 题(Answers MCP)中,Answers 得分 89%,Parallel pro 得分 73%,Perplexity Sonar Pro 得分 43%,Exa answer 得分 12%,也就是说我们也是目前市面上第一的研究任务 API。
绑卡后,第一次 Deep run 免费。
我想请大家帮个忙:给 Answers 一个你的智能体现在会查错的查询,然后告诉我它是给出了答案还是返回了 not_found,以及这次判断对不对。
- Jordan