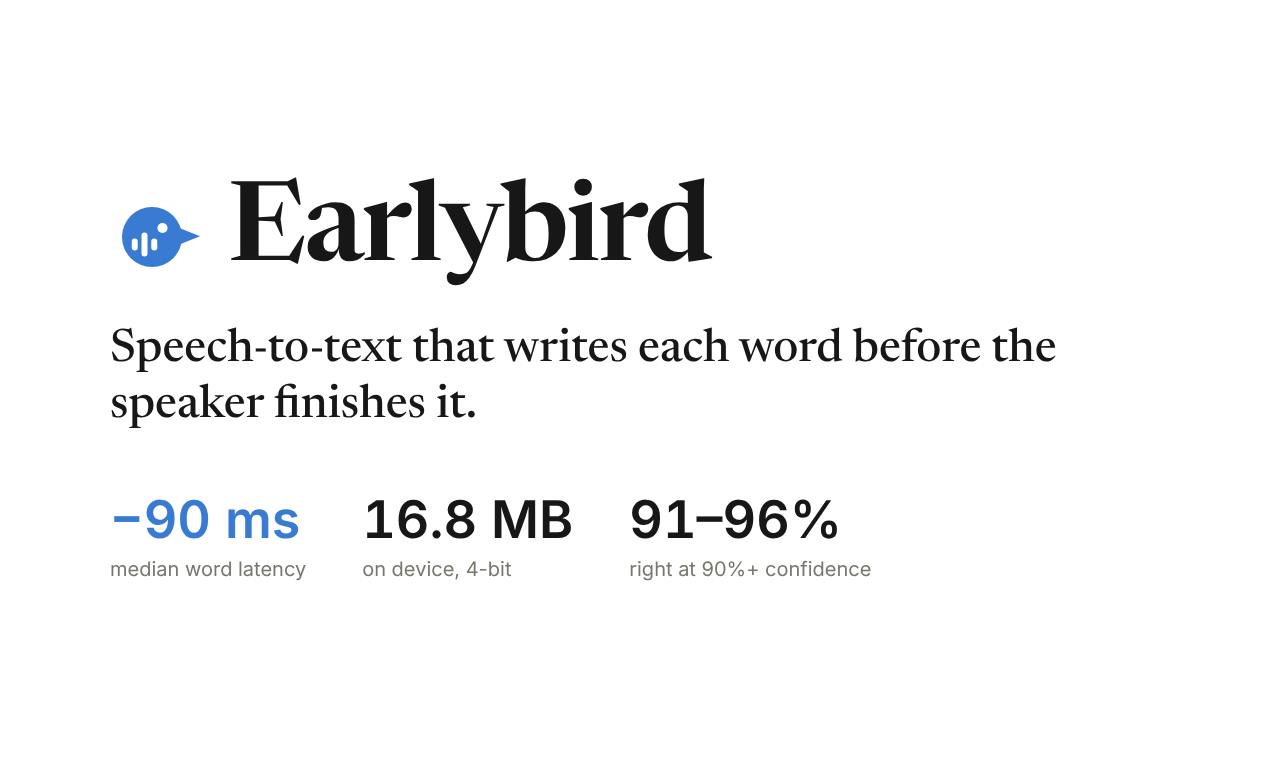
我一直在做语音智能体,也总是遇到同一个延迟问题:speech-to-text 要等每个词说完才显示出来,所以智能体在那之前没法开始工作。Earlybird 会在说话人还没说完时就把词输出出来。在有声书语音上,中位情况下单词会在被完整说出前 90 ms 就被正确预测,而其他流式模型则要在说完后 90 到 400 ms 才预测正确。模型只有 17 MB,跑在 CPU 上。
PH 用户
提前 90 ms 预测出单词是个聪明的取舍——在语音智能体里,这 90 ms 往往就是“感觉即时”和“感觉卡顿”之间的差别。我最喜欢的是每个词都有置信度:这让智能体有真实依据来决定,对高置信度的词立刻行动,对不确定的词先等待。17 MB、端侧运行、开放权重,小到真的能打包进一个 app 里发布。好奇它在嘈杂的真实世界音频里,相比干净录音表现如何。
我一直在做语音智能体,也总是遇到同一个延迟问题:speech-to-text 要等每个词说完才显示出来,所以智能体在那之前没法开始工作。Earlybird 会在说话人还没说完时就把词输出出来。在有声书语音上,中位情况下单词会在被完整说出前 90 ms 就被正确预测,而其他流式模型则要在说完后 90 到 400 ms 才预测正确。模型只有 17 MB,跑在 CPU 上。