更深入地审视 Agentic BBO:为黑盒优化基准测试 LLM Agents
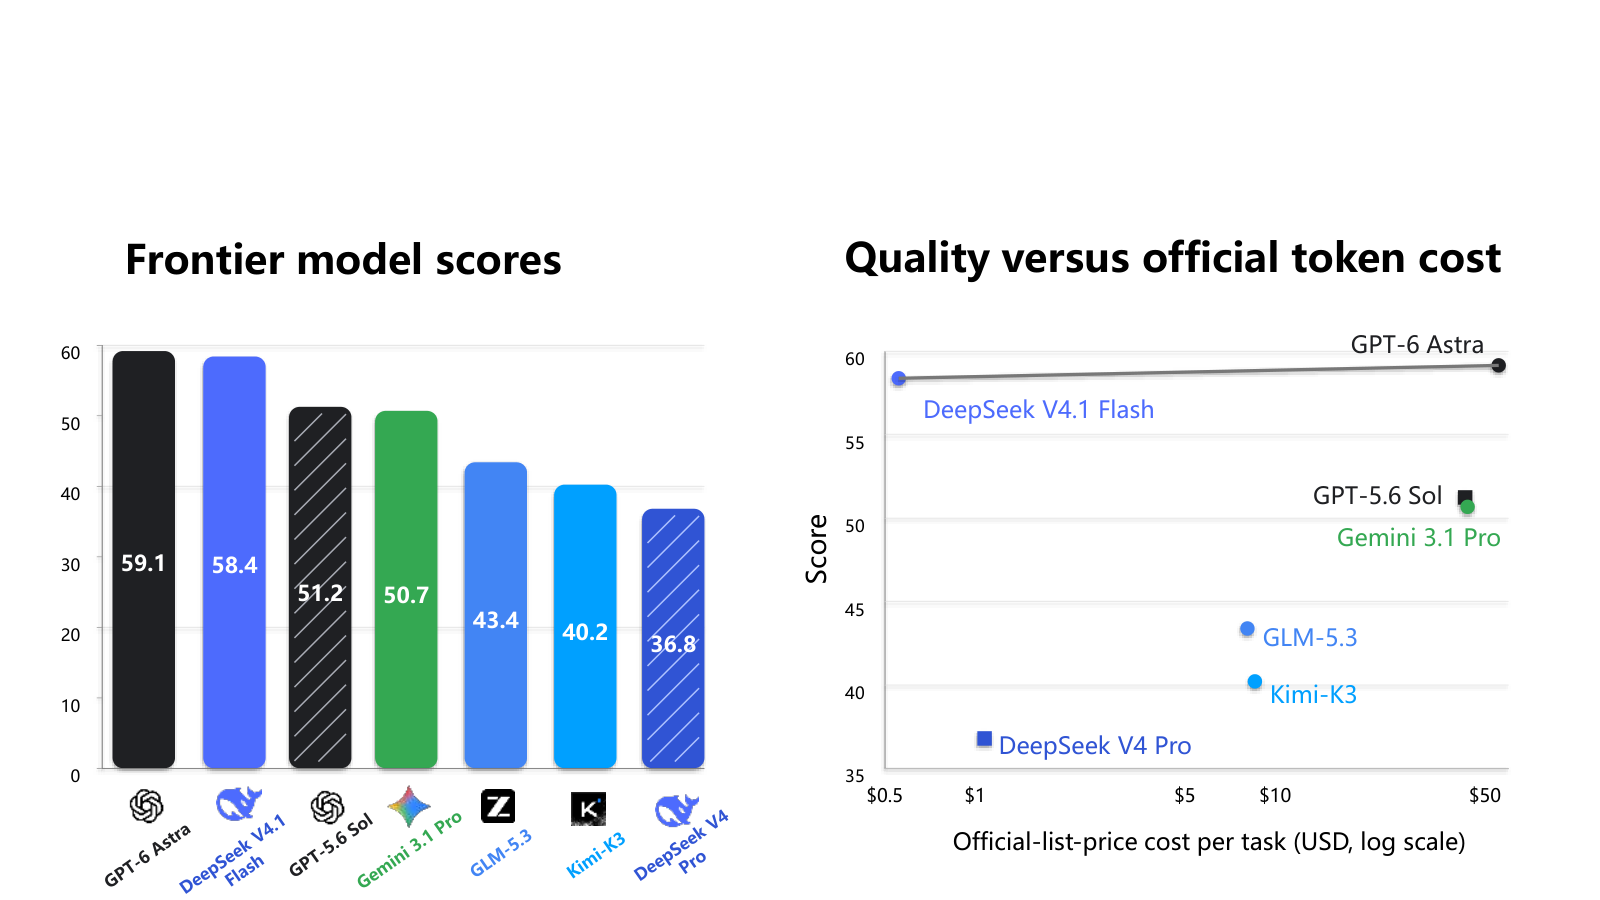
黑盒优化(BBO)广泛出现在目标函数评估昂贵且次数受限的科学与工程问题中。近期,LLM agents 通过结合任务语义、计算、优化工具与反馈驱动的决策,为 BBO 提供了新思路,并因与数学严谨工具的整合而展现出巨大潜力。然而,现有 agentic BBO 研究采用的任务领域与系统配置各不相同,导致结果难以比较,单项设计选择的效果也难以分离。 为此,我们提出 AgenticBBO-Bench,一个跨领域的 agentic BBO 基准,在统一的有限预算评估协议下覆盖合成函数、超参数优化、数据库调优、芯片设计与分子设计。 实验结果显示,agentic BBO 在全部五个领域中的族平均得分均高于直接基于 LLM 的方法,并在其中四个领域优于最佳数值优化器。我们还进一步研究了影响 agent 表现的三类因素: - 优化工具 - 任务信息与先验知识 - LLM 在搜索过程中的角色 结果表明,额外数值工具并不能稳定提升性能;任务语义普遍有用,而更具体的先验则不太可靠;数值优化器能够有效吸收 agent 所建立的搜索轨迹带来的收益。最后,我们提出 AgenticBBO-Bench 中的五项任务前沿挑战,并在 Codex agent harness 下评估了七个 LLM,其中 GPT-6 Astra 与 DeepSeek-V4.1-Flash 位于所评估模型性能与成本的帕累托前沿。代码见 https://github.com/lamda-bbo/agentic-bbo。
论文精读
TL;DR AgenticBBO-Bench 提供跨领域黑盒优化基准,统一评估 LLM Agent,发现其在五领域中多数超越数值优化器,并揭示工具、先验与 LLM 角色的实际影响。
问题
问题背景
黑盒优化 (BBO) 在科学计算与工程设计中广泛存在,其目标函数评估昂贵、预算有限。近年来,LLM agents 被引入 BBO,通过融合任务语义、数值工具与反馈决策,展现出超越传统数值优化器的潜力。
现有方法局限
现有 agentic BBO 研究各自采用不同的任务域、系统配置和评估预算,导致结果难以横向比较。例如,有的工作仅在合成函数上验证,有的侧重超参数优化或分子设计,缺乏统一的有限预算协议和归一化评分。这种碎片化带来两个直接后果:
- 无法隔离单个设计选择(如优化工具、先验知识、LLM 角色)的贡献,各论文结论相互矛盾,无法形成可积累的知识体系。
- 与数值基线(如
CMA-ES、TuRBO)的比较常使用不一致的预算和指标,可能高估 LLM 的增益,使 agentic 方法的真实价值被模糊。
为什么这个问题难/重要
构建跨域评测基准的难点在于:不同任务具有异构的目标空间、评估成本和未知最优值,需要谨慎设计归一化与聚合方法;agentic BBO 是多组件系统,性能受工具选择、提示设计、先验知识等多因素交互影响,必须通过系统性消融才能理解因果。如果缺乏此类基准,领域将充斥难以复现的“一次性”结果,阻碍 LLM 驱动优化器从研究走向生产。业界关注能否用 LLM 替代或增强经典优化器,因此一个可复现、可对比、可消融的评测基础设施是推进这一方向的关键。
行业类比
类似于 AutoML 领域通过 NAS-Bench 等标准化基准统一神经架构搜索评测,AgenticBBO-Bench 为 LLM 驱动的黑盒优化器提供了横向比较与设计分析的基础。
核心洞察
- AgenticBBO-Bench 首次在统一有限预算协议下跨五个领域基准测试 LLM agent 的 black-box optimization 能力,解决了以往研究因任务域和系统配置不同而结果不可比的问题。与已有 LLM for BBO 工作相比,该 benchmark 不仅覆盖 synthetic functions、hyperparameter optimization、database tuning、chip design、molecular design,还提供统一的评分归一化和轨迹评估方法,使不同 agent 设计可以直接横向对比,填补了 agentic BBO 系统化评测的空白。
- 研究揭示了 agentic BBO 中三个反直觉发现:优化工具并非越多越好,额外数值工具不总能提升性能;任务语义广泛有用但具体 prior 不可靠;数值优化器可以有效吸收 agent 建立的搜索轨迹,说明 LLM 的角色定位比单纯堆叠工具更重要。这些结论纠正了“更多工具更强”的朴素假设,为后续 agent 系统设计提供了可操作的取舍依据,也指出了 LLM 在优化循环中的最优介入位置是一个关键设计维度。
方法
AgenticBBO-Bench 方法
统一交互协议:每个任务实例为 agent 提供 workspace 和任务级优化提示,agent 在有限预算 B 内迭代式提交候选点,benchmark 容器隔离执行真实目标函数并返回观测值,避免 agent 直接访问目标内部。
任务套件:覆盖五类域:
- 合成函数(BBOB)
- 超参数优化(HPO)
- 数据库调优
- 芯片宏布局
- 分子设计
评分与聚合:对每个任务,将 agent 轨迹的最优值归一化到参考算法(如随机搜索、Sobol 序列、经典数值优化器)的前沿,得到 trajectory score;再在任务族内取平均得到 family-averaged score,实现跨域可比。
消融剖析:通过受控设置改变(1)可用的数值优化工具、(2)注入的任务语义/先验知识、(3)LLM 在搜索循环中的角色(决策者 vs 辅助者),分离各因素贡献。
Frontier Challenge:选取五个高难度任务构成前沿挑战集,使用 Codex agent harness 评估七个 LLM,输出性能-成本 Pareto 前沿。
与同类工作的差异:将以往分散的 agentic BBO 研究统一到同一评估协议和跨域任务套件下,首次系统隔离工具、先验与 LLM 角色三个关键设计因素。
实验
实验设计
AgenticBBO-Bench 采用统一有限预算协议,覆盖五个域:BBOB 合成函数、超参数优化 (HPO)、数据库调优、芯片宏布局与分子设计。实验比较了 agentic BBO、直接 LLM 方法与经典数值优化器(如 GP-BO、CMA-ES、TPE 等),并系统消融了三个关键因素:优化工具、任务信息与先验知识、LLM 在搜索循环中的角色。此外,五任务前沿挑战在 Codex agent harness 下评估了七个 LLM 的性能与成本。
关键发现
- 聚合性能:agentic BBO 在全部五个域的 family-averaged scores 上超过直接 LLM 方法,且在四个域中优于最佳数值优化器。
- 工具并非越多越好:额外数值工具并不一致提升性能,工具选择需与任务特性匹配。
- 先验可靠性:任务语义信息广泛有用,但过于具体的先验知识反而可能误导搜索。
- 角色分配:数值优化器能有效吸收代理生成的搜索轨迹收益,说明 LLM 代理负责探索、数值优化器负责精化是一种高效协同模式。
- 前沿模型:GPT-6 Astra 与 DeepSeek-V4.1-Flash 在性能-成本 Pareto 前沿,为实际部署提供性价比参考。
与基线对比的深度解读
相较于直接 LLM 方法,agentic BBO 通过引入工具调用、反馈循环与决策机制,在跨域任务中取得一致提升,验证了代理式框架的通用价值。但同时,性能增益并非来自简单堆叠工具,而是源于任务感知的语义建模与探索-利用平衡。相比传统数值优化器,agentic BBO 在多数域领先,表明 LLM 的先验知识与语义理解能有效引导搜索,尤其在预算有限时。然而,在部分场景下数值优化器仍是强基线——这也启发了工程实践:应将 LLM 代理视为自适应算法设计器,而非替代品,利用其探索轨迹增强现有优化器即可获得可迁移的收益。
行业影响
落地场景
AgenticBBO-Bench 覆盖的任务域直接对应工业中的黑盒优化问题:超参数优化 可用于 AutoML 平台与模型训练流水线,数据库调优 适用于云数据库自动参数推荐,芯片宏布局 服务于 EDA 设计空间探索,分子设计 可用于药物发现与材料筛选。LLM agent 能结合任务语义、数值优化工具与反馈循环,在有限评估预算下自动完成搜索,降低对领域专家的依赖。
商业价值
核心价值在降本与增效:减少人工调参和专家迭代的人力成本;通过更优的配置或设计提升模型精度、数据库吞吐、芯片 PPA 或分子活性,进而缩短产品上市时间。论文指出附加数值工具未必持续提升性能,特定先验知识可靠性不足,因此企业应聚焦于任务语义的利用与 LLM 在优化循环中的角色设计,避免盲目堆叠工具造成集成复杂度和成本上升。
跟现有产品/工作流的接口
该基准提供统一协议、评分归一化与 agent harness,可嵌入现有 MLOps、DBaaS 或 EDA 工作流作为优化层。例如:LLM agent 生成候选或调整搜索策略,随后调用 TuRBO、CMA-ES 等数值优化器进行精调;或由 agent 探索出有价值的轨迹后,交给数值优化器继续收敛。企业可将 AgenticBBO-Bench 的评估机制迁移到内部任务,对比不同 LLM 与工具组合的成本-性能 Pareto 前沿。
具体落地 use case
- 云数据库自动调参:用户通过自然语言描述业务负载特征(如读写比例、峰值 QPS),agent 调用参数采样与性能探针,在有限预算内生成推荐配置,替代 DBA 手动反复试错。
- AutoML 服务:用户上传训练任务描述与数据简介,agent 结合贝叶斯优化等工具搜索超参数,最终输出最优模型与调参轨迹,服务商可按评估次数或 LLM token 计费,实现调参过程产品化。
局限
- **基准任务领域覆盖有限**:当前仅包含五个领域(合成函数、超参数优化、数据库调优、芯片设计、分子设计),虽然具有代表性,但 BBO 应用场景极为广泛,如材料科学、机器人控制、推荐系统等尚未涉及。不同领域的特性(如高维、多目标、约束)可能影响智能体策略的有效性,因此当前结论能否泛化到更广泛的 BBO 任务仍有待验证。此外,每个领域内的具体任务数量可能较少(例如合成函数仅使用 BBOB 的部分函数),可能无法充分捕捉领域内多样性。
- **评估预算与基线公平性存疑**:论文采用统一有限预算评估协议,但预算设定(如函数评估次数)是否对所有基线公平?数值优化器如 GP-BO、CMA-ES 通常针对特定预算进行调参,固定预算可能不利于某些算法。同时,智能体系统可访问任务语义信息,而传统优化器仅依赖函数值,这种信息不对称可能放大智能体的优势。若进行严格控制(如给予数值优化器相同的先验知识),结论可能改变。此外,使用的数值优化器是否是各自领域的最佳实践?例如在超参数优化中,是否包含 Hyperband 等更先进的基线?若缺失强基线,可能高估智能体性能。
- **系统配置复杂性与可复现性挑战**:Agentic BBO 系统涉及多个组件(LLM、工具、提示、反馈循环),其性能高度依赖具体实现和超参数。论文研究了三个因素,但仍有大量未探索的设计选择(如工具调用频率、记忆管理、温度设置)。此外,代码库 GitHub stars 仅 1,表明社区采用度低,可能影响结果的可复现性和可扩展性。LLM 智能体的运行成本(API 调用费用)和延迟远高于传统优化器,尽管论文在 Pareto 前沿分析中考虑了成本,但并未深入讨论在实际工程部署中的性价比与可行性。