通过部署实现机器人编排器与策略的协同演化
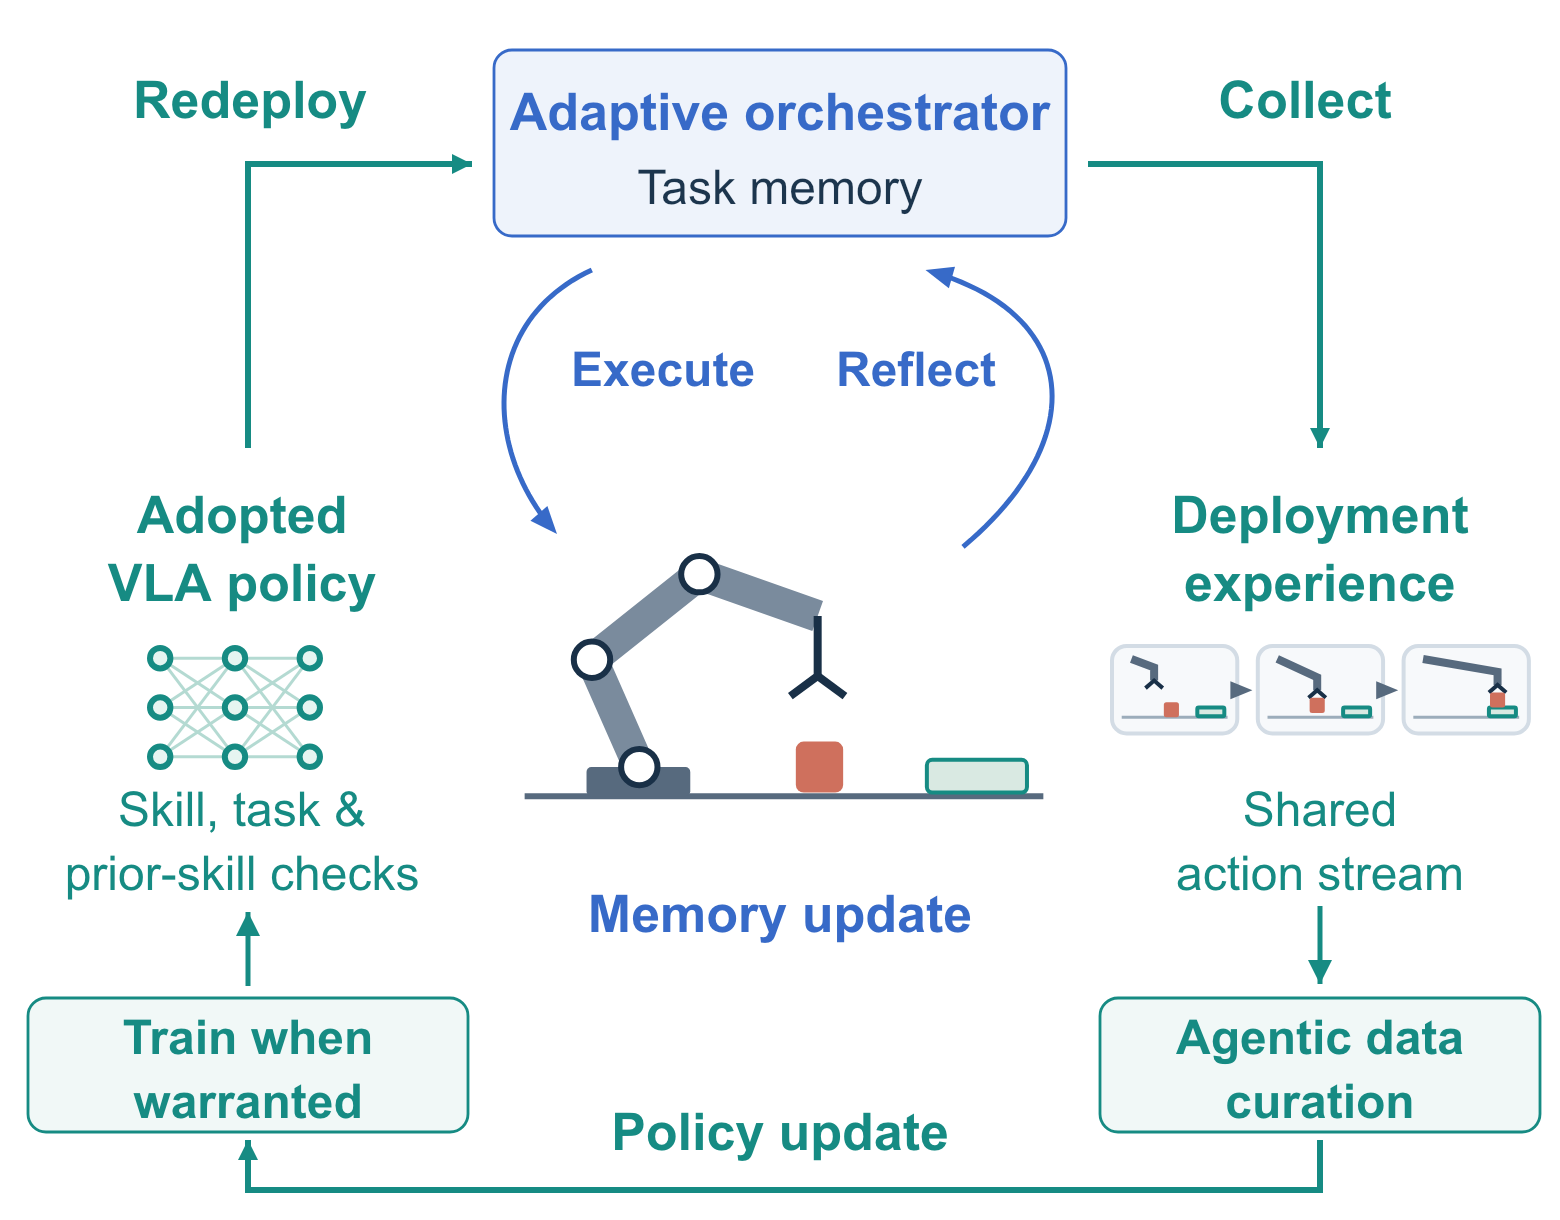
视觉-语言-动作(VLA)策略虽在大规模数据集上训练,能在其训练域内胜任任务,却仍难以泛化到真实部署中遇到的各种情境。智能体式机器人系统 通过 视觉语言模型(VLM)编排器来补足策略,学习何时调用策略、如何下达指令、以及何时改用脚本化技能。然而,由于整套框架建立在语言可控性有限的冻结策略 之上,编排器只能规避策略的失败,却无法真正克服它们,策略因而成为整个系统的瓶颈。单独微调策略虽可消除瓶颈,却会让它与原本适配其旧行为的编排器脱节。 我们提出 Robo-COP,让编排器与策略在部署过程中协同演化。Robo-COP 从自身执行记录中筛选技能演示;当这些数据能够解决反复出现的失败时,便对策略进行微调;并且只有当新策略在其受训技能上确有提升后才予以采纳。 - 在十个模拟 RoboLab 任务上,Robo-COP 将平均留出成功率 从 64.8% 提升到 73.8%,而相同框架下使用冻结策略、以及不做验证按固定计划微调的基线仅达 65.8%。 - 在三个真实世界任务上,Robo-COP 将留出成功率从 38.3% 提升到 50.0%。 Robo-COP 把部署变成一个自我改进的飞轮:机器人在做事中学习,每一次执行层面的提升都会为下一轮学习产出更好的数据。视频与代码见 https://robo-cop.pages.dev/ 。
论文精读
TL;DR 机器人部署时,编排器与策略协同进化:从自身执行中策展数据、按需微调策略,并仅在验证提升后采用,将部署变为自我改进飞轮,显著提升成功率。
问题
问题背景:机器人操作领域正从大规模预训练 VLA 策略 向智能体化系统演进,通过 VLM 编排器 协调策略调用与脚本技能,以应对真实部署中的多样性。
现有方法局限:当前 agentic robot 系统通常围绕一个冻结的 VLA 策略 构建,编排器只能规避策略失败(如改用脚本技能),却无法修正策略本身的不足;策略的语言可引导性有限,成为系统瓶颈。单独微调策略虽能提升其能力,但会导致编排器针对旧行为优化过的调用逻辑失效,系统整体性能反而可能下降。固定时间表微调且无验证的基线,held-out 成功率仅 65.8%,较冻结策略提升有限。
为什么这个问题难/重要:技术挑战在于策略与编排器相互依赖,任何一方更新都可能破坏另一方;且部署环境数据噪声大、标签稀疏,需要自动筛选有效经验并验证新策略。业界对终身学习、自改进机器人有强烈需求,因为真实世界无法离线穷举所有场景,机器人必须能从自身执行中学习。
行业类比:类似自动驾驶中规划器与感知模型需要在线协同进化,否则仅更新感知会破坏规划决策逻辑,导致系统级退化。
核心洞察
- 部署中的共同进化闭环:Robo-COP 把 VLM 编排器与 VLA 策略视为一个整体系统,在部署中通过自身执行数据策划、策略微调、验证后采纳形成 flywheel。与以往工作不同,先前要么冻结策略只优化编排器(策略成为瓶颈),要么独立微调策略导致编排器与旧行为失配,而 Robo-COP 让两者同步演化,每次策略更新都经过编排器适配,确保系统级性能提升。
- 策略采纳的安全验证机制:Robo-COP 不采用固定调度或盲目微调,而是仅在收集的数据能够解决反复出现的失败时触发训练,并在采纳新策略前验证其在目标技能上的提升。这一机制避免了持续学习中的性能回退,论文中固定调度微调仅达 65.8%,而带验证的 Robo-COP 达到 73.8%,为真实部署中的策略更新提供了可靠的门控。
方法
输入与执行闭环
Robo-COP 的输入是部署环境中的视觉观察、语言指令与当前策略集合。系统由 VLM 编排器 + VLA 策略 + 脚本技能 组成。执行阶段采用 Acting and reflecting 机制:编排器根据任务状态决定调用 VLA 策略或脚本技能,并在每次执行后反思失败原因,记录轨迹与结果。通过 Action unification,不同执行源的动作被映射到统一格式,便于后续数据整理。
关键模块
- 经验整理与策略改进:从自身执行轨迹中提取成功片段,转化为带语言标签的技能演示(From execution to labeled skills)。当检测到某类技能反复失败且累积数据足以改进策略时,触发微调(Deciding when to train)。
- 策略验证与集成:微调产生候选策略后,不直接替换原策略,而是在保存的技能验证集上评估候选策略(Candidate policy verification)。只有候选策略在目标技能上的表现优于当前策略时才被采纳;同时更新编排器记忆与技能库(Policy adoption and memory revision)。
输出
输出是一个持续演化的策略集合与编排器记忆:新策略替换旧策略,编排器根据更新后的策略能力调整调用逻辑,完成部署中的自我改进闭环。
与同类方法的差异点:现有 agentic robot 系统把 VLA 策略冻结,仅靠编排器绕开失败;Robo-COP 让策略与编排器协同演化,策略不再是系统瓶颈。
实验
实验设计
在 10 个模拟 RoboLab 任务和 3 个真实世界任务上评估 Robo-COP。对比条件包括:冻结策略的相同 harness、固定计划微调(无验证)。使用 held-out success 指标,模拟任务包含域外重置等变化,真实世界任务覆盖不同物体与场景。评估协议包含晚部署窗口与成功轨迹统计,以反映部署中持续学习效果。
关键发现
模拟结果:Robo-COP 将 held-out success 从 64.8% 提升至 73.8%,相对冻结策略提升 +9.0%;固定计划微调仅达 65.8%。真实世界三个任务从初始 38.3% 提升至 50.0%,相对提升 +11.7%。系统能正确决定何时训练与是否采纳新策略,表明共进化机制有效。策略微调针对周期性失败场景,数据来自自身执行,形成自我改进循环。
基线对比解读
固定计划微调仅 +1.0% 提升,说明盲目周期性更新会破坏编排器与策略的适配,且无验证机制导致性能波动。Robo-COP 的策略采纳前验证与记忆修订,确保新策略只在实际改善目标技能时才被采纳,避免灾难性遗忘。这印证了 co-evolution 相比单纯微调的关键优势:两者共同适应部署分布。
行业影响
落地场景
Robo-COP 适用于需要机器人长期部署、并不断适应环境变化的产品:仓储物流机器人、家庭服务机器人、工业质检/装配机器人、自动驾驶车辆中的端到端策略。任何采用 VLA policy + VLM orchestrator 架构的系统,都能在部署期通过协同进化提升泛化,尤其适合故障模式多变、数据难以预先覆盖的开放场景。
商业价值
核心价值在于降低持续维护与再训练成本。部署期自我改进 flywheel 减少了对大规模人工标注数据的依赖;同时,验证后采纳策略避免了固定重训导致的性能回退(实验中 Frozen 64.8% → Robo-COP 73.8%,Fixed Schedule 仅 65.8%)。直接体现为任务成功率提升带来的运营降本,以及机器人系统生命周期的延长。
与现有产品/工作流的接口
现有机器人系统已普遍包含 orchestrator 与 policy 分离的架构,Robo-COP 可作为中间件嵌入:从 orchestrator 执行日志中提取技能演示、自动触发 fine-tuning、验证候选 policy 后决定采纳或回滚。工程上需实现三个模块:
Experience curation:从执行记录到带标签的技能数据Policy fine-tuning:针对周期性失败模式的定向微调Policy adoption gate:基于验证集的策略切换与记忆修正
该流程可对接现有 MLOps 管道(如 Weights & Biases、Kubeflow),形成 deployment-to-training 的闭环。
局限
- - **实验规模与任务多样性有限**:论文仅在 10 个模拟 `RoboLab` 任务和 3 个真实世界任务上验证,环境相对受控;模拟任务难以完全覆盖真实部署中的复杂视觉变化、遮挡与动力学差异。对比基线仅包括冻结策略和固定调度微调,缺少与其他自改进方法(如部署期策略适应系列)的全面对比,结论的泛化性有待更大规模与更异构场景的检验。
- - **依赖高质量的自动标注与成功判定**:`Robo-COP` 从自身执行中筛选技能演示,需要可靠的成功检测与任务分段;真实世界中成功信号可能噪声较大,失败归因困难,限制了数据筛选的准确性。此外,微调数据仅来自当前策略的行为分布,可能偏向已知成功模式,对分布外新场景的改进有限,存在自我强化偏差的风险。
- - **计算与集成开销未充分评估**:协同演化涉及多轮微调、候选策略验证和编排器记忆修订,需要额外的训练与推理资源;论文未报告每个部署阶段的时间/计算成本,实际部署时可能成为瓶颈。同时,方法假设 `VLA` 策略可微调且与 `VLM` 编排器通过语言指令耦合,对于不可微调或黑盒策略难以直接应用,限制了方法在现有机器人系统中的普及性。