从 Pareto 到偏好:通过摊销式智能体策略发现实现个性化测试时扩展
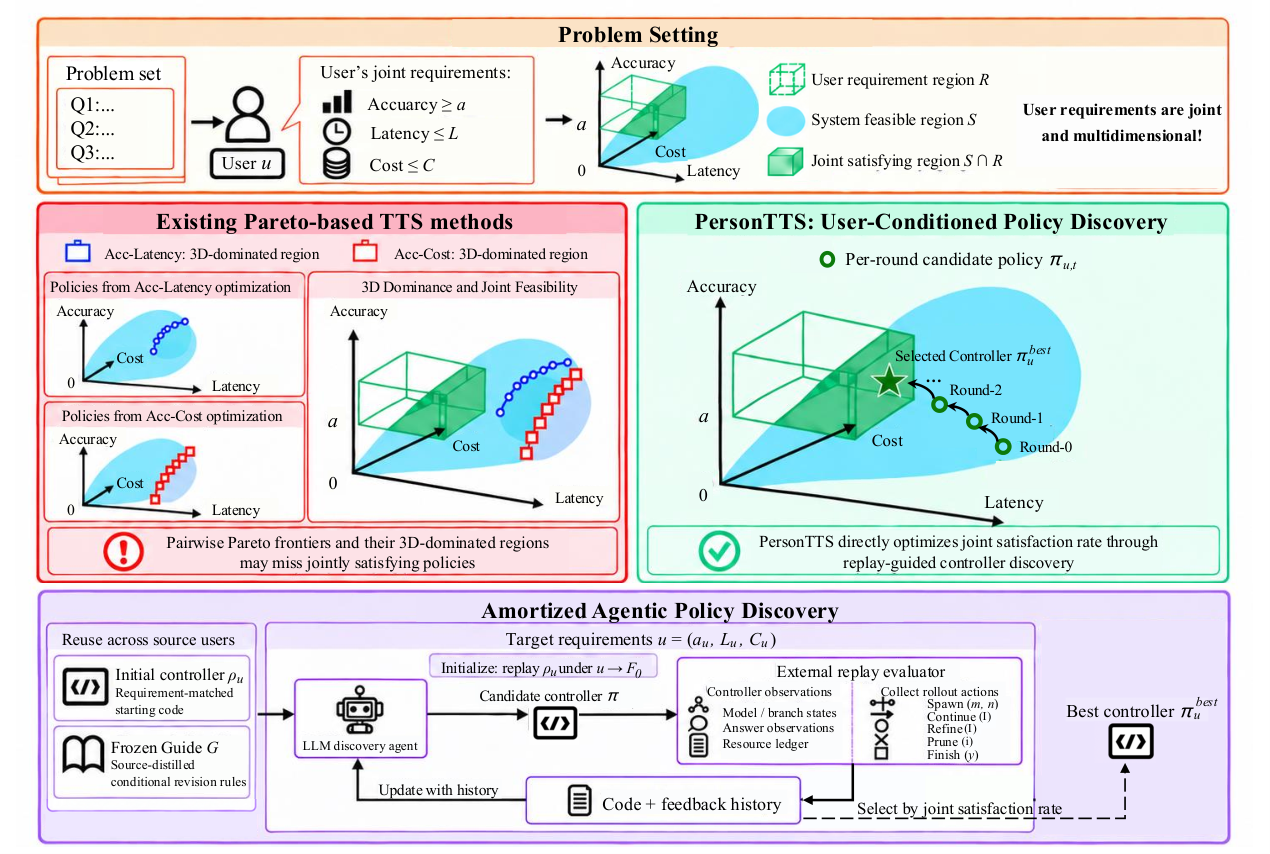
测试时扩展(Test-Time Scaling, TTS)通过分配额外的推理计算提升大语言模型的推理能力。现有提升 TTS 效率的方法大多一次只针对单一资源维度优化准确率,分别推进 accuracy-cost 或 accuracy-latency 的 Pareto 前沿。但用户需求是多维的:用户可能同时指定准确率、延迟与推理成本要求,而不同需求会偏好不同的控制器。 本文将 个性化测试时扩展 形式化为:发现能最大化用户特定需求联合满足率的可执行控制器。为降低针对新用户画像反复做策略发现的开销,作者提出 PersonTTS —— 一个摊销式智能体策略发现框架。它通过以下两点复用先前的搜索经验: - 需求匹配的控制器初始化 - 源蒸馏的过程性指导 同时对每个候选策略都保留目标画像评估。 在 AIME 与 HMMT 上的实验表明,PersonTTS 在未见过的用户画像与留出问题上,联合需求满足度显著优于强 TTS 基线。在相同的候选评估预算下,跨用户经验复用进一步提升了策略质量,同时大幅降低发现智能体的时间与成本。
论文精读
TL;DR PersonTTS 将测试时缩放从单一 Pareto 优化转向满足用户对精度、延迟、成本的联合需求,通过复用历史搜索经验摊销控制器发现成本,在 AIME/HMMT 上显著提升未见用户与题目的联合满足率。
问题
问题背景
当前 大型语言模型(LLM)推理领域高度关注 Test-Time Scaling(TTS)——通过分配额外推理计算来提升复杂任务上的表现。效率优化是核心议题,即在给定资源预算下最大化准确率。
现有方法局限
现有 TTS 效率优化大多单一维度推进:要么优化 准确率-成本 帕累托前沿,要么优化 准确率-延迟 前沿。这带来两个关键局限:
- 无法满足联合需求:用户往往同时指定准确率、延迟和推理成本约束,单一维度优化可能在其他维度上表现糟糕。
- 策略发现不可复用:不同用户偏好需要不同控制器策略,但为每个新用户配置文件从头进行策略搜索成本极高,缺少跨用户经验的复用机制,导致发现过程重复且昂贵。
为什么这个问题难/重要
用户需求通常是多维且相互冲突的(如高准确率常伴随高延迟与高成本),这使得策略发现成为一个复杂的多目标优化问题。同时,可执行控制器空间巨大,搜索评估成本高。业界正转向个性化推理服务,需要按用户 SLA 动态调整推理策略,而不是采用固定策略。快速、低成本地为新需求找到高质量策略,且保证在未见问题上的泛化,是当前规模化部署 LLM 推理的迫切挑战。
行业类比
类似云服务中的自动扩缩容或推荐系统中的个性化配置:推理服务需要根据用户指定的服务质量(SLA)动态选择最优执行路径,而不是对所有用户采用同一种推理策略。
核心洞察
- Personalized Test-Time Scaling 将目标从优化单一 Pareto 前沿转向最大化用户特定需求的联合满足率。传统 TTS 效率优化通常单独优化 accuracy-cost 或 accuracy-latency,但不同用户可能同时指定 latency、cost 和 accuracy,且不同需求组合会偏好不同的控制器,单一 Pareto 最优解无法覆盖偏好差异。该工作显式建模个性化需求,并在联合满足率目标下搜索控制器,相较固定权重或标量化方法更能反映真实部署中的多维约束。
- 跨用户经验摊销(amortized experience reuse)通过 requirement-similarity 初始化和 source-distilled procedural guidance 大幅降低重复策略发现的成本。与对每个新用户重新运行 agentic search 不同,PersonTTS 利用先前搜索轨迹构建经验库,按需求相似度初始化候选控制器,并用源任务提炼的过程性指导引导发现,同时保留目标 profile 上的评估以过滤负迁移。这种摊销思路将策略发现从 per-user optimization 转为可复用的元学习过程,显著减少发现 agent 的时间和推理开销。
方法
输入与问题定义
PersonTTS 接收三类输入:用户配置文件(指定准确率、延迟、推理成本等多维需求)、基准问题集(如 AIME / HMMT)以及一个基础 LLM。将个性化测试时缩放建模为发现可执行控制器的搜索问题:每个控制器是一个策略(如是否继续推理、调用工具或采用某种聚合方式的程序),其目标不是单维准确率,而是最大化对用户特定多维需求(accuracy, latency, cost)的联合满足率。
关键模块
- 用户条件化的 Agentic 策略发现:以用户 profile 为上下文,agent 迭代生成候选控制器,并在目标 profile 上实际执行评估,记录各维度满足情况。
- 跨用户经验重用:
- 需求相似性策略初始化(requirement-matched controller initialization):为新 profile 检索历史上相似需求下发现的高质量控制器,作为搜索起点,减少冷启动浪费。
- 过程性技能蒸馏与引导发现(source-distilled procedural guidance):从历史搜索轨迹中蒸馏出可迁移的过程性启发式(如“当延迟约束严格时优先考虑 early exit”),以自然语言指导 agent 的探索方向,而非直接复制最终策略。
- 目标评估分离:对每个候选控制器,始终在目标用户 profile 上重新评估,不依赖源 profile 的满足率推断,从而避免需求变化导致的排序反转。
输出
输出一个针对该用户 profile 优化的控制器,可直接用于测试时推理,无需再次训练 LLM 权重。
与同类方法仅优化 accuracy–cost 或 accuracy–latency 单一 Pareto 前沿不同,PersonTTS 直接面向多维联合满意度,并通过摊销式经验重用显著降低新用户 profile 的策略发现开销。
实验
实验设计
实验在 AIME 和 HMMT 两个数学推理基准上评估 PersonTTS。用户需求配置文件刻画了 accuracy、latency 和 inference-cost 三个维度的联合约束,实验目标是在 unseen user profiles 和 held-out problems 上最大化 joint satisfaction rate。基线包括现有 strong test-time scaling (TTS) 方法,这些方法通常单独优化 accuracy-cost 或 accuracy-latency Pareto 前沿。
关键发现
- PersonTTS 在未见用户配置和保留问题上,joint requirement satisfaction 显著优于基线 TTS 方法。
- 在相同 candidate-evaluation budget 下,跨用户经验复用(cross-user experience reuse)进一步提升策略质量,同时显著降低 discovery-agent 的时间和成本。
- 消融与扩展分析验证了 discovery-to-held-out 泛化能力,并发现 experience bank 规模扩大能带来收益。
与基线对比的解读
传统 TTS 控制器训练以单一资源维度为优化目标,导致面对多维用户需求时,需要为每个新用户重新搜索控制器,开销大且泛化弱。PersonTTS 将个性化测试时缩放定义为发现可执行控制器,最大化整体需求满足率。其 amortized agentic policy-discovery 框架通过 requirement-matched 初始化与 source-distilled 程序性引导,复用先验搜索经验,同时保留目标配置评估,从而在同等评估预算下实现更优的策略发现效率。这一设计将 Pareto 优化范式转向 preference 驱动的联合需求优化,更适合实际部署中动态变化的用户约束。
行业影响
落地场景
PersonTTS 可嵌入 LLM 推理服务 与 企业级 AI 平台,为不同租户或用户群体提供按需的 测试时计算策略。典型场景包括:智能客服(根据问题复杂度动态调整推理深度)、代码助手(个人免费版 vs 专业版采用不同搜索预算)、内容生成(社交文案快速生成 vs 深度长文精调)。这类场景中,用户对延迟、成本、准确率的多维偏好差异显著,单一的静态 TTS 策略难以同时满足。
商业价值
- 降本:通过跨用户经验重用,新用户策略发现时间与成本大幅下降;同时避免对低要求用户过度计算,节省 GPU 成本。
- 增收:提供差异化 SLA 服务,按需定价。例如 API 服务商可为高准确率低延迟的请求收取溢价,扩大客户群。
- 体验提升:用户获得符合自身偏好的响应速度和质量,减少等待或重试,提升留存率。
与现有工作流集成
PersonTTS 作为 策略发现层,可与 vLLM / TensorRT-LLM 等推理引擎解耦:离线利用历史请求和用户反馈训练 经验银行,在线时通过轻量控制器实时选择推理配置(如采样路径、搜索步数)。此外,可通过 模型路由 或 请求级调度 集成,在网关层面动态匹配用户画像与控制器,无需修改模型权重。
具体 use case:
电商搜索/推荐文案生成:平台为不同商家(大品牌 vs 中小商家)提供不同级别的 AI 文案服务。大品牌要求高创意质量可接受更高延迟,使用 PersonTTS 可自动为其分配更深搜索策略;中小商家更关注成本与速度,则快速生成。商家无需手动配置,平台整体资源利用率提升。
企业级 LLM 平台:向大型企业客户提供定制化推理 SLA。合同承诺 95% 请求延迟 < 2s 且准确率 > 90%,PersonTTS 根据该约束自动发现合适的控制器,并利用已有相似客户经验快速冷启动。相比手动调整采样参数,大幅缩短上线周期。
局限
- **实验基准单一**:主要评估仅在 **AIME** 和 **HMMT** 两个数学推理数据集上进行,虽然附录报告了跨基准泛化结果,但整体上对代码生成、科学问答等更广义推理任务的覆盖不足。真实用户配置往往涉及多样化的任务分布,单一领域的性能提升可能无法直接迁移到其他场景,限制了 **PersonTTS** 作为通用个性化测试时缩放方案的可信度。
- **用户配置文件采样可能与真实偏好存在偏差**:论文通过离线回放池和预设分布采样用户需求(见附录 B.3),但实际用户对准确率、延迟、成本的多维权衡往往更复杂且随时间变化,可能包含非线性效用或非凸约束。简化采样可能导致训练出的控制器在真实部署时满足率下降,而论文未系统评估这种分布偏移的影响。
- **摊销发现的启动成本与扩展性存疑**:尽管跨用户经验重用降低了后续发现开销,但初始阶段的 agentic 搜索仍需大量候选控制器评估与 LLM 调用,且经验银行(experience bank)的规模增长可能带来边际收益递减(论文 4.4.2 节有所分析)。在大规模用户基数下,策略初始化和指导蒸馏的存储与检索效率尚未经过压力测试。