面向大语言模型的参数内记忆增强
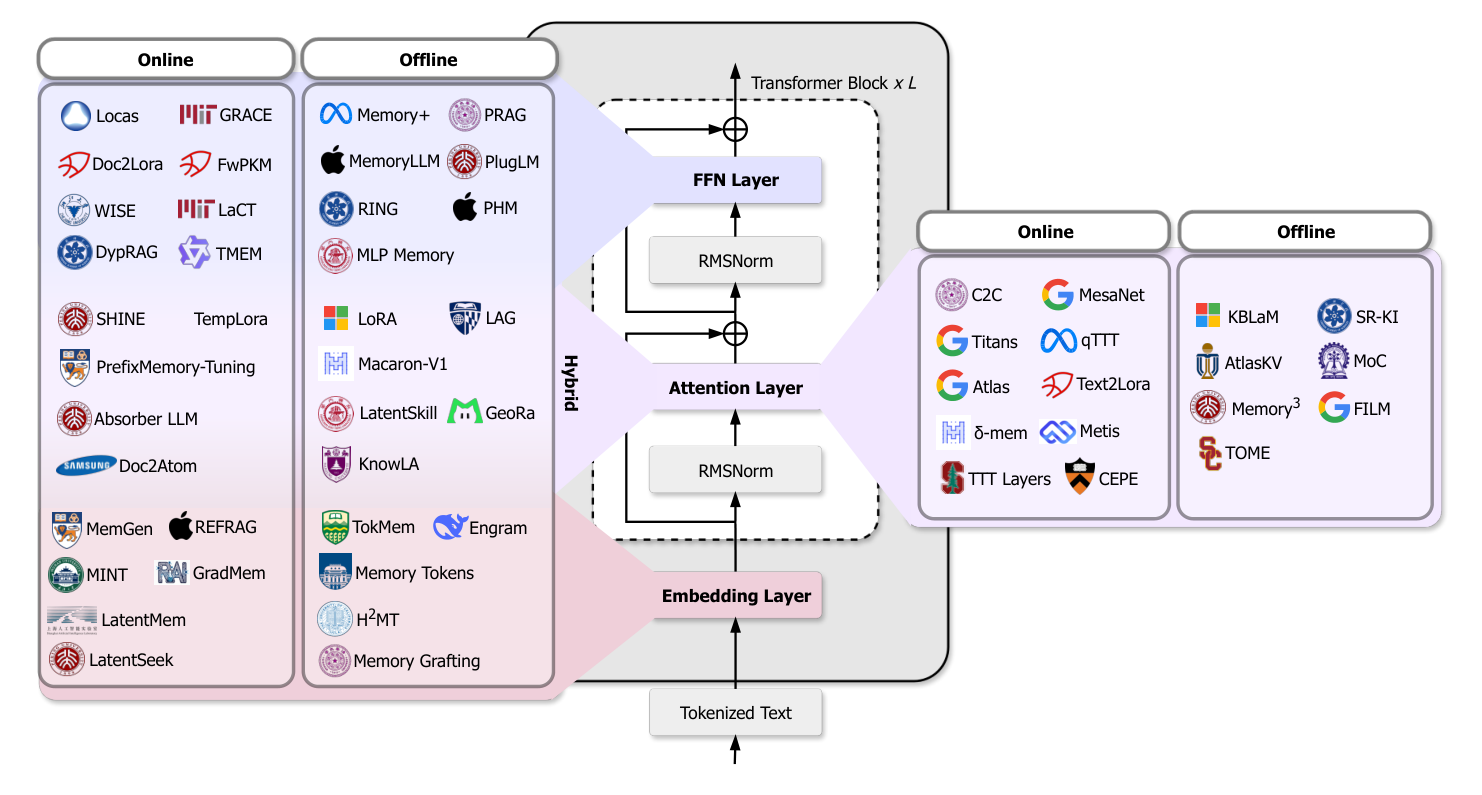
近期 Large Language Models(LLMs)与基于 LLM 的 agent 越来越需要纳入预训练之后获得的知识,例如领域事实、用户偏好、文档与交互经验。In-context learning(ICL)及基于 ICL 的 agent harness 虽保持灵活,但会占用上下文容量,并带来随上下文长度增长的重复离散化编码开销。 In-parameter memory 提供了互补的承载基底:可复用的记忆信息被表示为模型参数、adapters 或其他类参数对象,在推理时被组合进前向传播。 本综述聚焦于在部署阶段以此类参数化记忆增强 LLM 的方法:只要记忆参数对象在推理时被插入前向传播即属讨论范围,无论它是部署前还是部署中获得的。我们用两个正交维度组织该领域: - Parameter Placement:涵盖 Embedding、Attention、FFN 层,以及使用两层及以上时的 Hybrid; - Parameter Acquisition Time:区分记忆对象在部署期间获得(online)与在部署之前获得(offline)的方法。 我们厘清边界、展开对比,并讨论在干扰、安全性、与 ICL 的协同设计以及递归自我改进方面的开放方向。
论文精读
TL;DR 系统梳理 LLM 参数化记忆增强方法,用参数放置与获取时机两个正交维度建立分类框架,并对比权衡、指出与 ICL 协同及安全等开放方向。
问题
问题背景
LLM 在部署后持续面临新知识注入的需求,如领域事实、用户偏好与交互经验。当前主流方案依赖上下文学习(ICL),但存在固有瓶颈。
现有方法局限
- 上下文窗口压力:ICL 将所有新知识塞入 prompt,消耗宝贵的上下文容量,且随知识量线性增长,挤压推理与工具调用的空间。
- 重复编码成本:每次推理都要对相同的外部知识重新做离散化编码,无法复用,导致延迟与计算开销上升;对于长文档或多轮 agent 交互,成本尤为突出。
- 缺乏持久参数化表征:传统微调或 adapter 方法通常离线、静态,难以在部署中动态更新;而参数化记忆方法虽已出现,但散落于 Embedding、Attention、FFN 等不同位置,缺少统一抽象,干扰(interference)与安全边界不清。
为什么这个问题难/重要
参数化记忆需要将知识编码为可组合的参数对象,并在推理时无缝插入前向传播。难点在于:如何在不破坏原有模型能力的前提下,支持在线增量更新、避免知识相互干扰,并保证安全与可解释性。业界高度关注此类机制,因为 agent 系统需要低延迟、可复用的长期记忆,而非每次重新读取外部存储。
行业类比
这类似于给 LLM 增加一块可热插拔的参数化缓存:相比 RAG 每次都去磁盘读取,参数化记忆相当于把常用知识预加载到更靠近计算核心的位置,显著降低重复访问开销。
核心洞察
- 该论文提出 **参数内记忆** 作为与上下文学习(ICL)互补的推理时记忆增强范式,并以参数插入前向传播为统一抽象。 与将知识写入上下文不同,参数记忆将知识编码进模型参数或参数化对象(如 LoRA / adapter),在推理时组合,避免了重复的离散编码开销和上下文窗口消耗。其独特之处在于通过 **Parameter Placement** 和 **Parameter Acquisition Time** 两个正交维度,将原本分散在 embedding 修改、attention 适配、FFN 编辑等工作统一到一个可比较的分类框架中,并明确界定了与持续学习、ICL 的边界。
- 论文强调 **在线参数获取**(部署期间动态形成记忆参数)是当前重要但未充分梳理的方向,与离线预获取形成关键对比。 许多现有工作只关注部署前固定的参数化知识(如微调、模型编辑),而在线获取允许模型在交互中持续积累经验、用户偏好或文档,无需重新训练。论文通过将时间维度独立于放置层,揭示了在线方法在注意力 / FFN 等不同位置上的设计选择与权衡,并指出干扰、安全和递归自我改进等开放问题。这种视角为构建长期自主 agent 提供了可操作的工程分类。
方法
方法框架:二维正交分类与参数化记忆抽象
本综述将参数化记忆增强抽象为一个推理时前向过程:输入为 LLM 主干网络与一个可插拔的记忆承载参数对象(如适配器、嵌入向量或修改后的权重),输出为融合了外部知识后的 logits。核心操作定义为:在特定层位将记忆参数与原始参数按某种组合规则(加法、拼接或门控)注入前向计算。
关键模块包含两个正交维度:
- 参数放置位置:嵌入层(修改 token 表示)、注意力层(调整键值或注意力权重)、FFN 层(插入新神经元或专家)、混合层(多层联合)。
- 参数获取时间:离线(部署前训练记忆对象)与在线(部署中动态更新或生成记忆)。
该方法论不提出新模型,而是用统一的运算符视角规范已有工作:设主干参数为 θ,记忆参数为 Δθ,推理时计算 f(x; θ ⊕ Δθ),其中 ⊕ 代表层特定的参数组合。基于此框架,论文将 30+ 种方法填入二维矩阵,并比较其容量效率、推理成本、知识干扰性与安全性。
与单纯罗列方法的综述不同,本工作强调参数化记忆与 ICL 的互补关系:参数化记忆节省上下文窗口、避免重复编码,但更新不灵活;ICL 灵活但线性消耗 token。
差异点:本综述首次以“推理时参数对象”为核心抽象,将离线适配器与在线自更新记忆统一在同一坐标系下,区别于仅关注持续学习或仅关注特定架构的既有综述。
实验
实验设计(综述方法论)
本工作为 综述文章,未进行传统实验。作者通过形式化 Transformer 内部可记忆位点(Embedding / Attention / FFN),建立 参数放置 × 获取时间 二维分类法,系统梳理多篇相关方法。比较重点在于参数效率、推理延迟、可组合性等 定性属性,而非数值指标。
关键发现
- 参数放置 决定记忆与模型架构的耦合方式:Embedding 层 适合存储离散符号/实体,FFN 层 适合存储可编辑的联想知识,Attention 层 适合上下文相关的推理模式。
- 获取时间 区分离线(预训练后冻结)与在线(部署时更新)记忆:在线方法更灵活但易引发 干扰 与 遗忘,离线方法更稳定但难以覆盖新知识。
- 参数记忆与 ICL 互补:前者提供可复用低延迟记忆,后者保持高灵活性,但两者如何 协同设计 仍是开放问题。
与基线对比解读
由于缺乏统一基准,作者采用 属性对比表(Trade-offs)定性比较各方法。与纯 ICL 相比,参数记忆避免了上下文长度限制与重复编码成本,但可能产生 参数干扰 和 安全风险。与 持续学习 方法相比,本文强调“推理时即插即用”的部署便利性,而非训练时更新。未来需研究 递归自我改进 中参数记忆的稳定性。
行业影响
落地场景
- 企业服务 agent:将用户偏好、交互历史等长期记忆写入参数模块(如 LoRA 或 adapters),推理时即插即用,避免每次调用重放完整上下文。
- 内容平台 / 智能客服:离线训练领域文档、产品知识为参数记忆,在线快速适配新用户或新规则。
商业价值
- 降本:减少重复 token 编码成本,降低长对话 API 调用费用;缩短推理延迟。
- 体验提升:提供稳定的个性化记忆,避免上下文截断导致的遗忘,提高用户留存。
- 增收:支持更长的 agent 交互轮次,提升任务完成率和付费转化。
与现有 stack 集成
- 作为插件化 adapter 层 集成到现有 LLM 推理框架,通过配置选择插入位置(Embedding / Attention / FFN)。
- 需要配套记忆管理服务:记忆对象的创建、更新、合并与版本控制。
- 与 RAG / ICL 协同:短期上下文用 ICL,长期稳定知识用参数记忆,形成混合存储。
具体用例:电商客服 agent 在会话中实时学习用户偏好并写入参数记忆,跨会话复用;金融风控助手将最新监管规则离线训练成参数模块,上线后即时生效。
局限
- 作为一篇 survey,本文没有提供任何实验验证或基准测试,仅基于文献梳理给出分类和定性比较;文中提出的开放方向如干扰、安全、与 ICL 协同、递归自我改进等,大多停留在问题陈述层面,缺少可操作的实现细节或量化评估。读者需要自己查阅原始论文才能验证作者对各方法的归类是否准确、优劣论断是否有充分支撑,这使得综述的实用性打折扣。
- 论文以 **Parameter Placement** 和 **Parameter Acquisition Time** 两个正交维度组织方法景观,但未纳入记忆容量、更新策略、存储/计算开销、与其他记忆范式(如 external memory、KV cache 增强)的系统性对比维度;对 online vs offline 的二分法也比较粗颗粒,部分方法(例如持续学习中基于 regularization 的参数更新)可能同时具有两种属性,分类的互斥性与完备性存在疑点。
- 与近年同主题的 memory-augmented LLM 综述相比,本文缺少针对下游任务(如 QA、agent 轨迹、个性化)的性能汇总表,也没有对代表性方法在相同设置下进行重实现或结果复现,导致读者难以横向判断各类方法的实际效果差异;此外,配套的 GitHub 仓库仅有 3 个 star,社区影响力有限,后续引用和迭代更新可能不足。