传感器-语言-动作模型
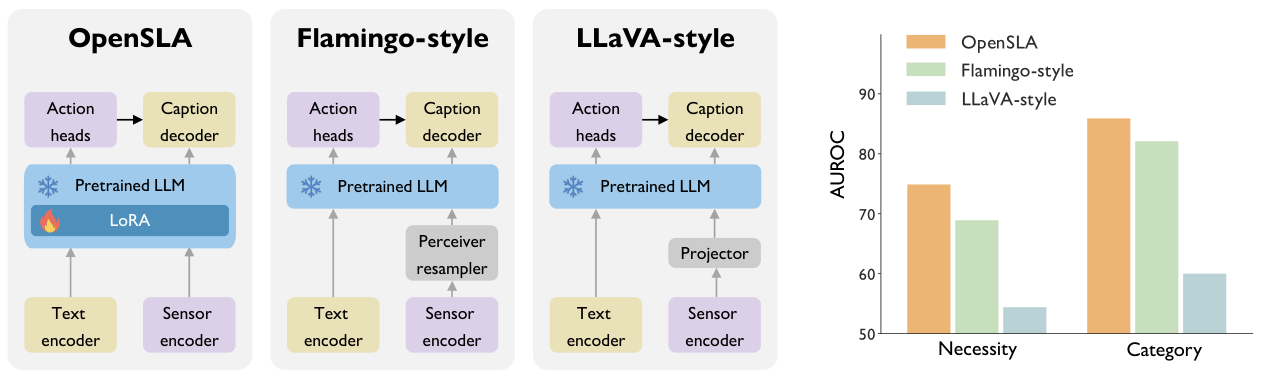
传感器不仅有助于理解世界,也能用于决策下一步行动。然而现有传感器模型大多停留在感知层面:它们识别状态或预测结果,而将动作建模分离出去,依赖任务特定且往往封闭的标签空间。为此,我们提出 Sensor-Language-Action (SLA) 建模框架,在统一模型中连接多模态传感器观测、自然语言与动作。SLA 以语言作为感知与行动之间的语义接口,使异构动作可被表示、预测和解释,同时仍扎根于底层传感器证据。 我们构建了大规模 SLA 基准,涵盖超过 116,000 名个体、79 种传感器模态与 60 个动作组,并配套多维度 captioning 流程,对齐用户上下文、传感器动态与动作证据。基于该框架,我们提出 OpenSLA,一个用于层次化动作预测、状态理解与动作解释的统一 SLA 模型。 在临床预测、手术室与代谢健康等真实任务上的大量实验验证了其优于当前最佳方法的性能。OpenSLA 还展现出有趣的能力,包括语言引导的证据定位,以及对未见动作与人群的零样本泛化。
论文精读
TL;DR 提出 Sensor-Language-Action 框架,用语言作为语义接口统一多模态传感与异构动作,构建 OpenSLA 模型,在医疗等真实场景中实现更优的动作预测、解释与零样本泛化。
问题
问题背景
智能系统正从单一感知走向感知-决策一体化。传感器模型在医疗监护、机器人操作、可穿戴健康等领域广泛部署,但多数工作停留在状态识别或结果预测,行动(action)建模被孤立为独立任务,缺乏统一框架。
现有方法局限
现有传感器模型存在三个核心限制:
- 封闭标签空间:动作输出限定在预定义类别集合,无法扩展到开放世界的新动作或新人群。
- 感知与行动割裂:感知模型和行动模型分别训练,无法共享表征,也无法利用语言知识进行语义对齐。
- 缺乏可解释性:传统模型输出动作标签,但不提供支撑该动作的传感器证据或自然语言解释,难以满足医疗等高可靠性场景的审计需求。
为什么这个问题难且重要
传感器数据天然多模态、高噪声、时间性强,不同模态(如 PPG、IMU、视频)之间语义鸿沟巨大。语言作为天然的语义接口,可以抽象异构动作空间,但如何将连续传感器序列与离散语言符号对齐,并在统一模型中同时完成动作预测、状态理解和证据 grounding,是技术难点。业界对可泛化、少标注、可解释的传感器-行动系统需求强烈,尤其希望模型具备零样本泛化到未见动作和人群的能力,以降低部署成本。
行业类比
类似视觉-语言模型(如 CLIP)将图像与文本对齐实现开放词汇识别,Sensor-Language-Action 试图将传感器数据与动作指令对齐,为通用具身智能和健康决策提供可扩展的感知-行动底座。
核心洞察
- - **语言作为传感器与动作之间的通用语义接口**:SLA 将自然语言嵌入动作空间,使模型能同时完成感知、动作预测与解释,而传统传感器模型仅止步于状态识别或结果预测,动作则用任务特定的封闭标签集单独建模。语言接口允许异构动作被统一表示和 grounding,利用语言先验实现零样本泛化到未见动作与人群,突破了感知与决策分离的既有范式。
- - **大规模 SLA 基准与多面 captioning 管道**:该基准覆盖 116,000+ 个体、79 种传感器模态和 60 个动作组,通过观察性、关系性、全局性和动作性四类 caption 对齐用户上下文、传感器动态与动作证据。相比仅用分类标签或单一文本描述的传感器数据集,此构造为统一模型提供了丰富对齐信号,使模型学会语言引导的证据 grounding 和层次化动作预测,并在临床、手术室、代谢健康等真实场景中验证了有效性。
方法
方法概述
OpenSLA 采用 Sensor-Language-Action (SLA) 建模框架,核心思想是用自然语言作为传感器观测与动作之间的语义接口,消除传统任务特定标签空间的封闭性。
输入:
- 多模态传感器数据:涵盖 79 种传感器模态(如临床监测、手术室设备、代谢健康指标等)
- 用户上下文信息(如个体属性、环境条件)
- 动作证据(通过多面 captioning pipeline 生成)
关键模块:
- 多面 captioning pipeline:从原始传感器数据自动生成四类描述——observational(观测)、relational(关系)、global(全局)、action(动作),将异构传感器动态和用户上下文转化为统一语言表征。
- 语言接口(language interface):异构动作被表示为自然语言短语或句子,模型在统一的文本空间中进行动作预测、状态理解和动作解释。
- 统一模型架构:基于 Transformer 的多模态编码器-解码器,编码传感器序列和文本描述,通过自回归或分类头输出动作标签及解释文本。采用层次化动作预测:先预测高层动作组(60 个动作组),再预测具体动作。
- 多任务训练:联合优化动作预测、状态理解(如未来状态预测)和动作解释(生成自然语言说明)的损失,通过语言建模目标促进跨任务迁移。
输出:
- 层次化动作预测结果(动作组 + 具体动作)
- 状态理解描述(当前/未来状态)
- 动作解释文本,并能根据语言查询对传感器证据进行 grounding。
该方法与同类传感器模型的差异在于:它不将动作视为独立的封闭标签集,而是通过语言接口统一感知与行动,从而支持零样本泛化到未见动作和队列,并具备可解释的证据定位能力。
实验
实验设计
OpenSLA 构建了大规模 SLA 基准,覆盖 116,000+ 个体、79 种传感器模态、60 个动作组,并设计多面 captioning 管道生成对齐用户上下文、传感器动态和动作证据的文本。模型在临床预测、手术室和代谢健康三个真实场景上评估,任务包括分层动作预测、状态理解和动作解释,并与现有 SOTA 基线比较,同时测试零样本泛化到未见动作和人群。
关键发现
OpenSLA 在所有三个真实世界任务上均超越 SOTA,验证了语言作为感知与动作之间语义接口的有效性。模型能够进行语言引导的证据 grounding,即用自然语言指出支持动作预测的传感器证据;并且在零样本设置下,对未见动作类别和未见人群仍保持合理性能,展示了跨任务和跨人群的泛化潜力。
基线对比解读
与传统传感器模型将动作建模为封闭标签空间的任务特定分类不同,OpenSLA 通过语言消除动作空间的异构性,使动作可以被表示、预测和解释。这种统一框架避免了为每个新任务重新设计动作头,允许模型利用语言先验进行零样本迁移。在临床、手术室等复杂环境中,SOTA 方法通常受限于标注动作的有限性和模态碎片化,而 OpenSLA 的多模态语言接口提供了更灵活、可扩展的解决方案,为后续传感器-动作统一建模提供了新范式。
行业影响
落地场景
OpenSLA 可将传感器感知与动作执行统一,适合需要从多模态数据直接产出决策的领域。具体场景:
- 医疗健康:在手术室或 ICU,融合生命体征、影像、病历文本,模型实时预测下一步操作(给药、调整设备)并给出自然语言解释,辅助临床决策,降低人为疏忽风险。
- 工业预测性维护:结合振动、温度、电流等传感器数据与维护手册,SLA 模型直接生成维修指令和操作步骤,实现从异常检测到维修执行的闭环,减少停机时间。
商业价值
- 降本:一个统一模型替代多个任务专用模型,减少训练、部署和维护成本;语言接口降低标注和专家知识依赖,扩展新动作仅需自然语言描述。
- 增收:零样本泛化能力可快速进入新客户群或新设备类型,缩短产品交付周期;可解释的动作依据提升客户信任,增强合规性,有利于医疗、金融等监管严格行业的销售。
- 体验提升:语言解释让终端用户或操作员理解模型建议,提升人机协作效率。
与现有产品 / 工作流的接口
- 模型可作为微服务,通过 REST/gRPC 接收传感器流(如 MQTT、OPC-UA)和自然语言 query,返回动作预测与解释,对接现有决策支持系统或 RPA。
- 利用
OpenSLA预训练权重 + LoRA 等参数高效微调,适配私有传感器模态和动作空间。 - 与 MLOps 工具(如 MLflow、Kubeflow)集成,支持模型版本管理和持续学习;数据管道可利用 Kafka 等流处理框架。
局限
- **数据依赖与泛化局限**:SLA 模型依赖大规模多模态标注数据,尤其是精细的动作标签和语言描述。虽然论文展示了零样本泛化到未见动作和人群,但真实世界传感器数据的分布差异(不同设备、采样率、噪声水平)可能显著影响性能。此外,构建的 benchmark 覆盖 116,000 个个体和 79 种模态,但跨领域迁移(如从临床到消费级可穿戴)尚未充分验证,数据收集成本也会限制在资源有限场景中的应用。
- **解释可靠性不足**:OpenSLA 能够生成动作解释,但语言生成模块可能产生与传感器证据不一致的幻觉或过度概括,尤其在医疗、手术室等高风险场景中,错误的解释可能导致严重后果。论文未提供解释准确性的定量评估,也未与人类专家解释进行系统对比,缺乏对生成文本忠实度的严格检验。
- **效率与实时性未知**:统一模型同时处理多模态传感器序列和自然语言生成,推理计算成本较高,可能不适于资源受限设备或实时性要求苛刻的场景(如手术室实时监控)。论文未讨论模型参数量、推理延迟、内存占用等部署细节,限制了工程落地的可行性评估。