附带信息污染患者病历并干扰大型语言模型的临床推理
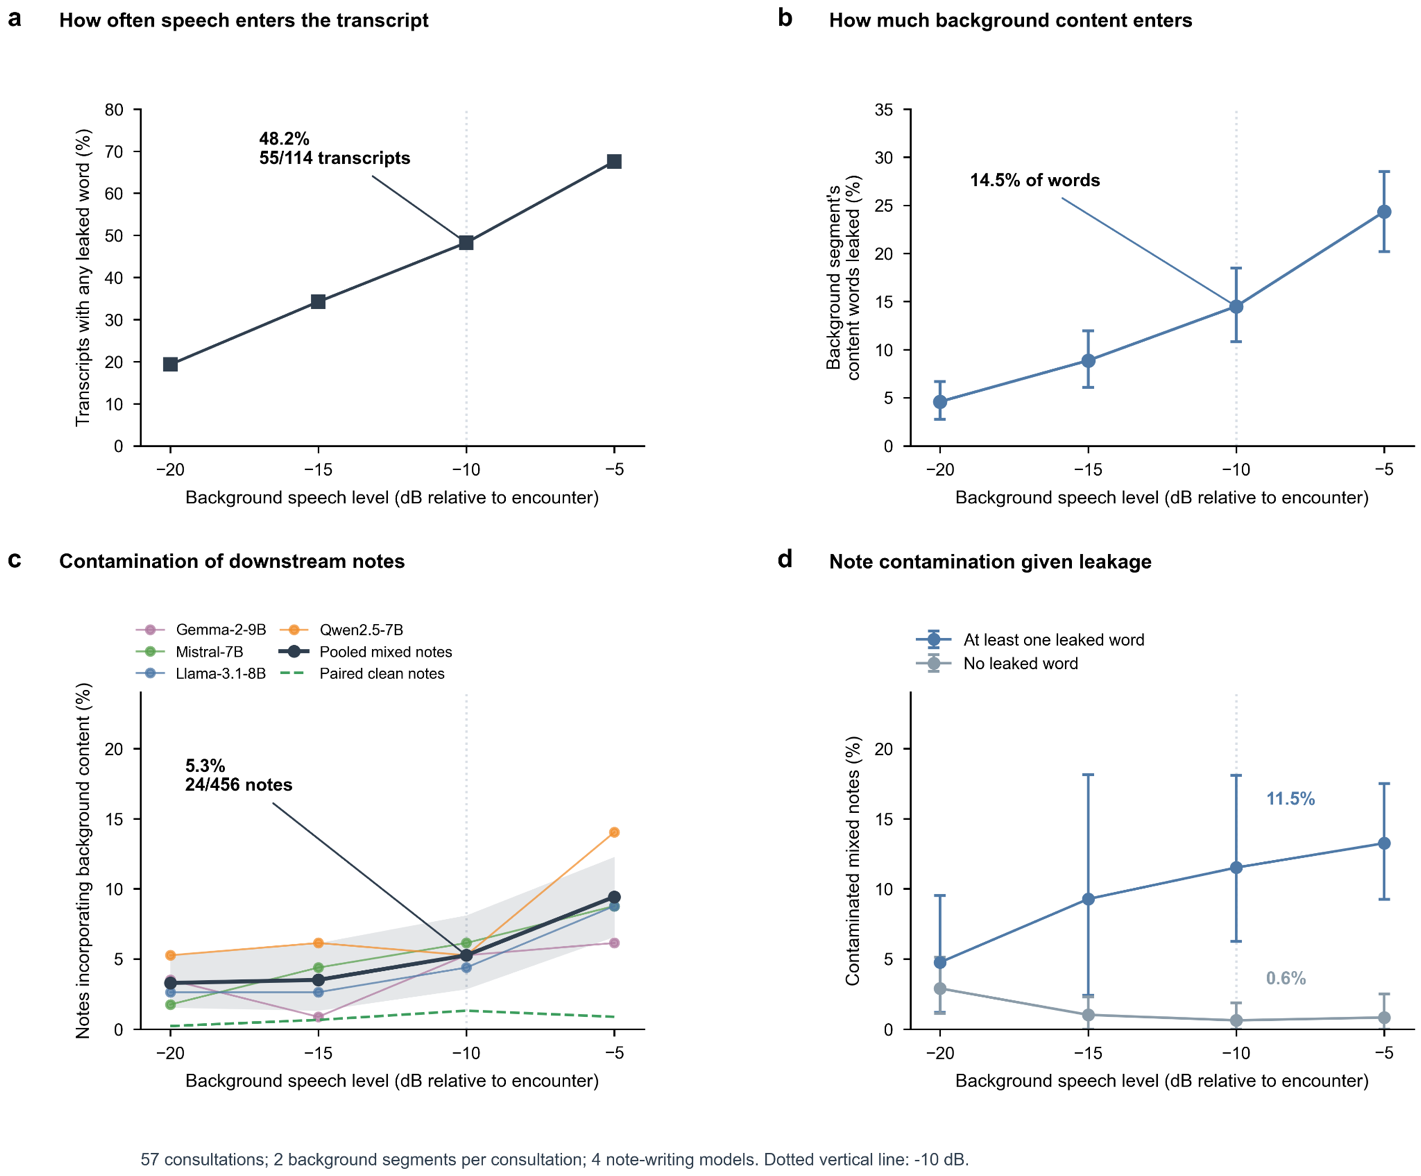
大型语言模型(LLMs)正越来越多地被用于支持环境记录(ambient documentation)与临床推理。本研究考察这两类应用共有的一个失效模式:模型对患者就诊过程之外附带信息 的敏感性。 在 576 组医患对话中,前沿模型将闲聊内容写入 35% 的病历,而平均质量评分在五点量表上变化最多仅 0.20 分;在 3.7% 的前沿模型病历中,模型误将旁白归因或将其用于临床。在 57 次模拟录音会诊中,来自另一场患者就诊、强度为 -10 dB 的背景语音泄漏进 48.2% 的转录文本,四个开放权重模型生成的下游病历中有 5.3% 检出污染。 我们提出 LLM 临床推理与分心的双重编码假说,并给出初步证据:与受附带信息干扰相关的模型组件同时也支持临床推理。这些发现支持在临床使用前评估模型对附带信息的抵抗力,并配套既能防止污染又能保留临床推理的防护措施。
论文精读
TL;DR LLM 处理医患对话时,35% 的笔记混入寒暄等偶发信息,背景语音使 5.3% 下游笔记受污染,且干扰与临床推理共享编码机制,提示临床部署前需评估抗干扰性。
问题
问题背景
LLM 在医疗环境文档(ambient documentation)与临床推理中的应用日益增多,模型需从真实患者-临床医生对话中提取关键信息生成病历。
现有方法局限
当前 LLM 对对话中的附带信息(incidental information)缺乏鲁棒性:
- 在 576 段对话中,前沿模型将闲聊(small-talk)插入病历的比例达 35%。
- 3.7% 的病历中,模型错误归因闲聊内容或将其用于临床判断。
- 现有评测常用整体质量分数(如 5 点量表),平均变化不超过 0.20,掩盖了具体错误。
- 背景语音(-10 dB)泄漏到转录的比率为 48.2%,并导致下游笔记污染率 5.3%。 缺乏针对附带信息干扰的细粒度基准与防护机制。
为什么这个问题难/重要
区分关键临床信息与附带噪声需要复杂的上下文理解与常识推理;医学场景容错率极低,误将闲聊当病史可能直接影响诊断与治疗。此类错误在整体指标下不易察觉,给评估与迭代带来挑战。随着医疗 LLM 走向真实嘈杂环境,业界关注模型对非核心输入的过滤能力,该问题直接影响患者安全与临床效率。
行业类比
类似于自动驾驶系统在雨雾天气中受传感器噪声干扰而误判障碍物,医疗 LLM 必须在不牺牲临床推理能力的前提下,有效抵抗无关信息的污染。
核心洞察
- LLM 的临床推理能力与对干扰信息的易感性可能共享底层表征,这意味着不能通过简单去除干扰来提升稳健性。该研究提出 dual encoding hypothesis,并通过机制实验发现与干扰相关的模型组件同时也支持临床推理。这与常见假设——干扰是外部噪声、可通过预处理或提示工程隔离——形成对比。若强行过滤 incidental information,可能同时削弱模型对真实病情的编码,导致诊断能力下降。这提示安全防护需要更精细的权衡,而非简单的删除策略。
- 现有的自动化临床笔记质量评分无法捕捉由 incidental information 引发的认知性错误,评估体系需要增加针对污染和归因错误的专项指标。实验中 frontier models 虽在约 35% 的笔记中插入了 small-talk,但平均质量分数变化不超过 0.20 分(五分制),表明主流评分对内容污染不敏感。然而 3.7% 的笔记出现把无关对话误归给患者或用于临床决策。这种“分数高但错误存在”的现象说明,仅靠总体质量分无法保证安全,需要开发专门检测 misattribution、错误临床使用等错误的评估方法。
方法
输入数据构建
研究构建两类输入:
- 576 患者-临床医生对话,其中穿插了与诊疗无关的闲聊(small-talk),用于模拟真实问诊中的偶然信息。
- 57 个模拟录音咨询,叠加来自另一位患者就诊的背景语音,信噪比为 -10 dB,模拟环境噪声泄漏。
关键模块
- 笔记生成与污染检测:使用前沿 LLM 根据对话生成临床笔记,检测笔记中是否插入闲聊内容、是否将闲聊错误归因于患者或用于临床决策。同时由临床医生按五分制评估笔记质量。
- 背景语音转录与下游污染:将录音通过自动语音识别转成转录本,再用四个开放权重 LLM 生成下游笔记,并检测笔记中是否混入背景患者的信息。
- 双编码机制分析:提出 dual encoding hypothesis(双编码假说),认为 LLM 内部同时编码临床推理与干扰信息。通过探查模型组件(如注意力头或层)与干扰敏感度及临床推理能力的关系,寻找机制证据。
输出指标
- 闲聊插入率、错误归因率、笔记质量分数变化;背景语音转录泄漏率、下游笔记污染率;模型内部表示与行为的关联强度。
与同类工作的差异
不同于以往只关注单一文档生成质量或语音鲁棒性的工作,本研究同时考察偶然信息对文档污染和临床推理的干扰,并提出区分推理编码与分心编码的机制框架。
实验
实验设计
研究通过两组实验评估 LLM 对偶发信息 的敏感性。第一组使用 576 段患者-临床医生对话,测试前沿模型在生成笔记时是否插入闲聊内容、质量评分变化,以及旁白被误归因或用于临床的比例。第二组使用 57 段模拟录音会诊,在 -10 dB 背景语音干扰下测量转录泄漏率和下游笔记污染率,覆盖四个开放权重模型。同时提出 dual-encoding hypothesis,通过组件分析初步验证推理与干扰共享编码。
关键发现
前沿模型在 35% 的笔记中插入了闲聊内容,但五点评分制上的平均质量分变化不超过 0.20 分,说明传统质量指标几乎无法捕捉污染。更严重的是,3.7% 的前沿笔记将旁白错误归因或用作临床信息。在背景语音实验中,48.2% 的转录出现了泄漏,下游笔记污染率为 5.3%。组件层面证据显示,对偶发信息敏感的组件同时支撑临床推理,暗示干扰与推理在表征上耦合。
与基线对比解读
研究没有直接给出传统基线,但对比前沿模型与开放权重模型的表现可发现:前沿模型主动插入闲聊的比率较高(35%),而开放权重模型在背景泄漏下的下游污染率为 5.3%,提示两类模型在不同干扰模式下均有脆弱性。更关键的是,质量评分变化微小(≤0.20)与污染率(3.7%、5.3%)并存,表明现有评估基准对偶发信息不敏感。实际部署前需要增加抵抗性测试,且不能简单剪枝干扰相关组件,否则可能同时损害推理能力。
行业影响
落地场景
该研究对医疗 AI 文档助手、远程医疗转录和临床决策支持系统有直接启示。在日常诊疗中,LLM 生成 SOAP 笔记时常将闲聊或背景对话误写入病历,甚至影响诊断推理。此类问题同样存在于企业会议纪要生成、客服对话摘要等场景,任何依赖长语音转写或对话理解的产品都需评估对偶发信息的抗干扰能力。例如,智能客服系统在提取用户意图时若被背景杂音或无关寒暄污染,可能导致错误工单分类或响应错位。
商业价值
- 降低医疗风险与合规成本:避免因笔记污染导致的误诊或记录错误,减少法律纠纷和审计风险。
- 提升自动化文档可用性:减少人工复核工作量,使医生或客服能直接信任生成结果,节省时间成本。
- 增强产品可靠性口碑:在竞争激烈的医疗 LLM 赛道,抗干扰能力可成为差异化卖点,尤其面向对准确性要求极高的医疗机构。
与现有工作流接口
集成路径上,可在语音转写流水线后增加一个“偶发信息过滤层”,利用该论文提出的双编码假设(dual-encoding hypothesis)设计专用分类器或 prompt 来标记并剔除闲聊、背景语音片段,再输入下游 LLM。同时,在部署前加入抗污染压力测试,模拟 -10 dB 背景语音、多说话人混叠等场景,量化笔记污染率和临床错误率。对现有医疗 IT 系统(如 Epic、Cerner)可通过 API 或中间件嵌入,不影响原有 EHR 流程。此外,开放权重模型可参考论文中的评估方法(如 incidental contamination rate、misattribution rate)建立持续监控看板,确保模型更新后仍保持低污染率。
局限
- **实验数据与真实临床环境存在差距**:研究使用的 576 组患者-临床医生对话来自模拟数据集,而 57 段 mock 录音为受控条件录制,背景语音干扰也是人工叠加。虽然作者指出这是为了控制系统变量,但真实的急诊或门诊环境包含更复杂的噪声类型(如多说话人同时交谈、设备噪音、远场拾音衰减),且临床笔记生成往往由 ASR 系统输出而非直接文本输入。因此结论在真实 EHR 工作流中的可推广性需要进一步现场验证。
- **模型覆盖范围有限且评估指标单一**:前沿模型仅报告了未具体指名的几个(可能为 GPT-4、Claude 3 等),开源模型仅四种,且未包含不同参数规模或经过医疗微调的模型。质量评分使用五级 Likert 量表,但未给出评分者间一致性系数(如 Cohen's κ),也未区分错误类型(如误归因 vs. 临床使用)的严重性差异。对临床推理的“破坏”测量依赖下游任务分数变化,但未与人类医生的表现基线对比,难以判断绝对危害程度。
- **dual-encoding 假设的机制证据尚显薄弱**:作者仅通过激活投影和消融实验提供初步证据,且样本量较小(57 段录音中可分析的案例有限)。LLM 的内部表征是否为双编码(分离临床信息与附带信息)尚无直接可解释性工具验证,且不同架构(decoder-only vs. encoder-decoder)或不同训练目标(RLHF 后)可能表现不同。与已有 LLM 鲁棒性研究(如对抗噪声、prompt injection)缺乏系统对比,未明确该工作相对于先前模型的增量贡献。