弥合上下文差距:面向表格 In-Context Learning 的激活对齐
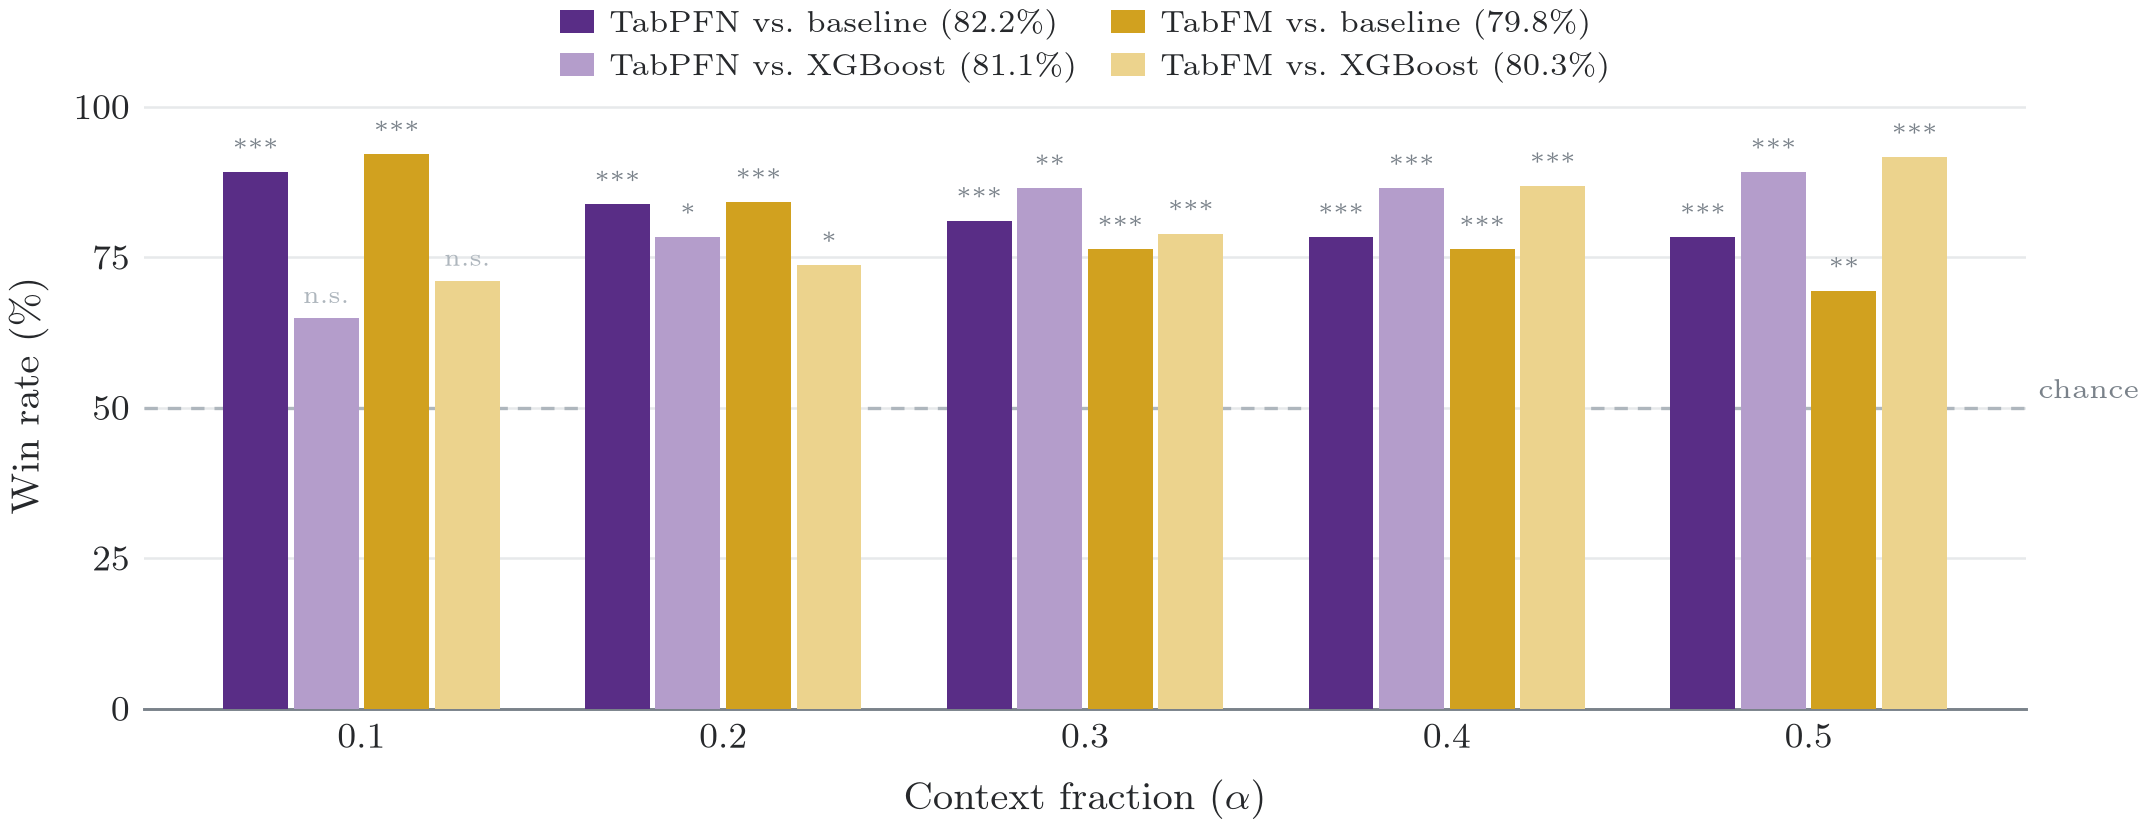
表格基础模型(tabular foundation models)通过 In-Context Learning (ICL) 进行预测,把带标签的训练样本作为上下文输入。与传统训练/推理分离的模型不同,它们每次前向传播都要处理全部训练样本,单次预测开销高昂;而限制上下文样本数量虽能降本,却会显著损害性能。 Activation Alignment(激活对齐)不丢弃上下文,而是用完整上下文教模型在只看部分样本时该如何表现:在合成无标签数据上训练一个轻量线性变换,把「学生」模型(部分上下文)的中间激活映射到「教师」模型(全部数据)的激活。该对齐器无需 GPU,在普通硬件上几秒至几分钟即可收敛。 我们在 TabArena 基准的 38 个分类数据集上,使用当前领先的两个表格基础模型 TabPFN-3 与 TabFM 进行评估。在所有上下文预算下,对齐后的学生模型相对未对齐基线均取得广泛且统计显著的提升;在低数据量场景中,对齐可挽回教师模型近一半的预测优势。 该方法以极低开销,实现了紧凑上下文级别的推理速度,同时弥合了与全上下文教师之间的相当一部分性能差距。
论文精读
TL;DR 通过训练轻量线性变换将部分上下文学生的中间激活对齐到全上下文教师,在保持低推理成本的同时显著恢复表格基础模型的上下文学习性能。
问题
问题背景
表格基础模型(如 TabPFN-3、TabFM)通过上下文学习(ICL)在结构化数据预测上达到领先水平,但每次推理都要处理全部标注示例作为上下文,导致计算成本随数据集规模线性增长。
现有方法局限
为降低推理开销,常见做法是限制上下文中的训练示例数量(即使用部分上下文的学生模型),但这会显著降低预测性能。已有的表格模型压缩方案(如蒸馏、剪枝)通常需要大量额外数据或重训练,难以保留 ICL 的动态适应能力;而直接减少上下文样本则丢失了完整上下文中蕴含的判别信息,导致性能断崖式下跌。
为什么这个问题难/重要
挑战在于:既要维持紧凑上下文的推理速度,又要尽可能复用完整上下文的知识。这需要一种低成本、无 GPU 的方法来缩小“部分上下文”与“完整上下文”之间的表征差距。业界对表格基础模型的部署效率日益关注,因为真实场景中数据集可能包含数万甚至更多样本,逐样本推理成本不可接受。
行业类比
类似于大语言模型处理超长上下文时通过 KV 缓存压缩或蒸馏来降低推理成本,本文方法相当于为表格 ICL 提供了一种轻量级的激活层对齐方案,在保持快速推理的同时回收大部分教师模型的知识。
核心洞察
- Activation alignment 将表格基础模型在受限上下文下的推断成本问题转化为中间激活空间的对齐学习:通过一个轻量线性变换,让使用部分上下文的 student 模型的隐藏表示逼近使用全量上下文的 teacher 模型。这一视角的独特性在于,不同于直接压缩上下文、选择代表性样本或对模型做知识蒸馏,它不改变模型权重,也不优化上下文子集,而是利用合成无标签数据学习一种激活层面的映射,在保持原始模型架构和推理流程不变的前提下,仅用秒级训练就能显著缩小与全量上下文 teacher 的性能差距,尤其适用于低数据预算的实时推理场景。
- 该方法的另一个独特之处在于训练对齐器所需的监督信号完全来自合成无标签数据,不依赖任何真实数据集或下游任务的标签。与需要标签的特征蒸馏或需要真实数据的 prompt 压缩相比,它通过生成与目标任务统计特性匹配的合成输入,驱动 student 与 teacher 的前向传播以收集激活对,进而学习线性映射。这避免了跨数据集迁移时的标注成本,且训练过程无需 GPU,在普通硬件上即可完成,为表格基础模型的 ICL 加速提供了一个低成本、模型无关、可即插即用的工程解决方案。
方法
方法:Activation Alignment
输入:一个预训练的表格式基础模型(如 TabPFN-3 或 TabFM),以及两种上下文配置——全量上下文(teacher)和部分上下文(student)。同一份训练集被拆分为完整版本和子集,分别送入模型得到中间层激活。
关键模块:
- 合成无标签数据生成:为对齐器训练提供输入分布,避免依赖真实标签或额外标注数据。
- 对齐器(Aligner):轻量线性变换,采用残差形式(即输出 = 原始激活 + 线性映射),将 student 的中间层激活映射到 teacher 对应层激活。不在模型原始权重上做修改。
- 层选择:只对部分关键层进行对齐,减少计算与过拟合风险。
- 训练目标:最小化变换后的 student 激活与 teacher 激活之间的差异(如均方误差),在合成数据上完成。
- 多估计器支持:针对集成或多次前向的模型,处理不同估计器产生的激活维度。
- 共享预处理:确保 student 与 teacher 的输入特征标准化方式一致,避免分布偏移。
输出:训练好的对齐器作为推理时的插件。使用部分上下文时,先正常前向得到 student 激活,再将对齐器作用于指定层,最终预测更接近全量上下文的 teacher 行为。
训练对齐器无需 GPU,在普通硬件上秒到分钟级收敛,推理时只增加一个线性变换的开销。
与同类方法差异:不同于传统知识蒸馏在输出 logits 上对齐或直接压缩模型参数,activation alignment 针对 in-context learning 场景,在中间激活层对齐受限上下文与完整上下文,且保持模型权重不变,以极低开销换取性能恢复。
实验
实验设计
实验在 TabArena 基准的 38 个分类数据集上,评估两个主流表格基础模型 TabPFN-3 和 TabFM。学生模型使用部分上下文(不同预算),教师模型使用全部上下文。通过合成无标签数据训练轻量线性变换(对齐器),将学生中间激活映射到教师激活。实验重复多次以计算统计显著性,并以未对齐学生和全上下文教师分别作为下界和上界。
关键发现
- 在所有上下文预算下,对齐学生相比未对齐基线均有显著提升,且提升稳定。
- 在低数据区域,对齐恢复了教师预测优势的近一半(~50%),表明激活对齐能有效传递全上下文知识。
- 训练对齐器成本极低:无需 GPU,在商品硬件上秒到分钟收敛。
与基线对比深度解读
与直接丢弃上下文的压缩方法不同,激活对齐利用完整上下文在训练阶段“教导”学生,推理时仍保持紧凑上下文的速度,实现训练-推理解耦优化。与特征蒸馏类似,但通过合成数据避免了对真实标签的依赖;对齐只是线性变换,不改变模型架构,也不引入额外推理开销。相较于激活操控,本方法通过拟合变换而非直接干预,更稳定可控。工程上适合对延迟敏感的场景,只需一次性训练对齐器,即可对所有查询复用。
行业影响
落地场景
表格基础模型(如 TabPFN-3、TabFM)在结构化数据预测中优势明显,但 ICL 需要将全部训练样本作为上下文,推理成本随上下文长度线性增长。activation alignment 通过让模型在部分上下文下模仿全上下文激活,显著降低推理开销,适合实时或大规模预测场景。
- 电商动态定价与个性化推荐:使用用户行为、商品属性等表格特征,在保持预测精度的同时将上下文从数百条缩减到几十条,实现毫秒级响应。
- 金融风控与信贷审批:欺诈检测、信用评分等任务需要快速处理大量表格记录,对齐后的模型可在低延迟下维持稳健性能。
商业价值
- 降本:减少推理时上下文处理量,每万次预测的算力成本可降低数倍;aligner 训练仅需 CPU 且数秒收敛,部署和维护成本极低。
- 增收:在低数据 regime 下恢复近一半教师性能,使模型在样本稀缺场景(如新品类推荐、新市场风控)仍能提供可靠预测,支撑业务扩展。
- 体验提升:延迟降低改善实时交互体验,如在线客服自动化、实时信用评估,减少用户等待。
与现有产品/工作流的接口
该方法可作为轻量 adapter 接入现有表格基础模型 pipeline:在模型中间层插入线性变换,训练阶段只需合成无标签数据,无需标注数据。部署时,保留原模型权重,仅加载 aligner 参数,可无缝集成到现有推理框架。
项目主页:TabAlign GitHub: yoel-zeldes/tabalign
具体 Use Case
- 电商促销响应预测:平台需预测用户对特定折扣的响应,传统方法需将上千条历史促销记录作为上下文,推理延迟高。使用 activation alignment 将上下文压缩至 50 条,预测速度提升 5 倍,AUC 仅下降 2%,支持实时推送决策。
- 医疗再入院风险分层:医院利用患者历史表格数据预测 30 天再入院风险,在低资源环境下使用部分上下文对齐,模型可在 CPU 服务器上快速运行,辅助临床决策。
局限
- **仅适用于分类任务** 且合成数据分布可能与真实数据存在偏差。论文在 38 个分类数据集上验证,未涉及回归或其他预测任务,因此方法在回归场景下的有效性未知。合成数据生成依赖简单的先验分布(如高斯混合),难以覆盖真实表格数据中的复杂依赖、缺失值或类别不平衡,可能导致训练出的对齐矩阵在分布外数据上泛化能力不足。此外,对齐质量高度依赖教师模型在全上下文下的激活质量,若教师模型本身存在偏差,对齐会继承这些偏差。
- **训练对齐器需要一次性全上下文前向传播** 且线性变换容量有限。虽然训练成本低(无需 GPU,秒级到分钟级),但生成教师激活仍需要处理完整上下文数据,在超大规模数据集或强资源受限环境中可能成为额外负担。线性变换假设学生与教师激活之间存在简单的线性映射,无法捕捉更复杂的非线性差异,可能限制对齐效果的上限。实验仅覆盖两个表格基础模型(**TabPFN-3** 和 **TabFM**),对其他模型架构或未来更强的表格基础模型的泛化性尚未验证。