Jev 认为「我不知道」,却没有说出口:介绍用于概率校准的 Sys1Cal-v1 数据集
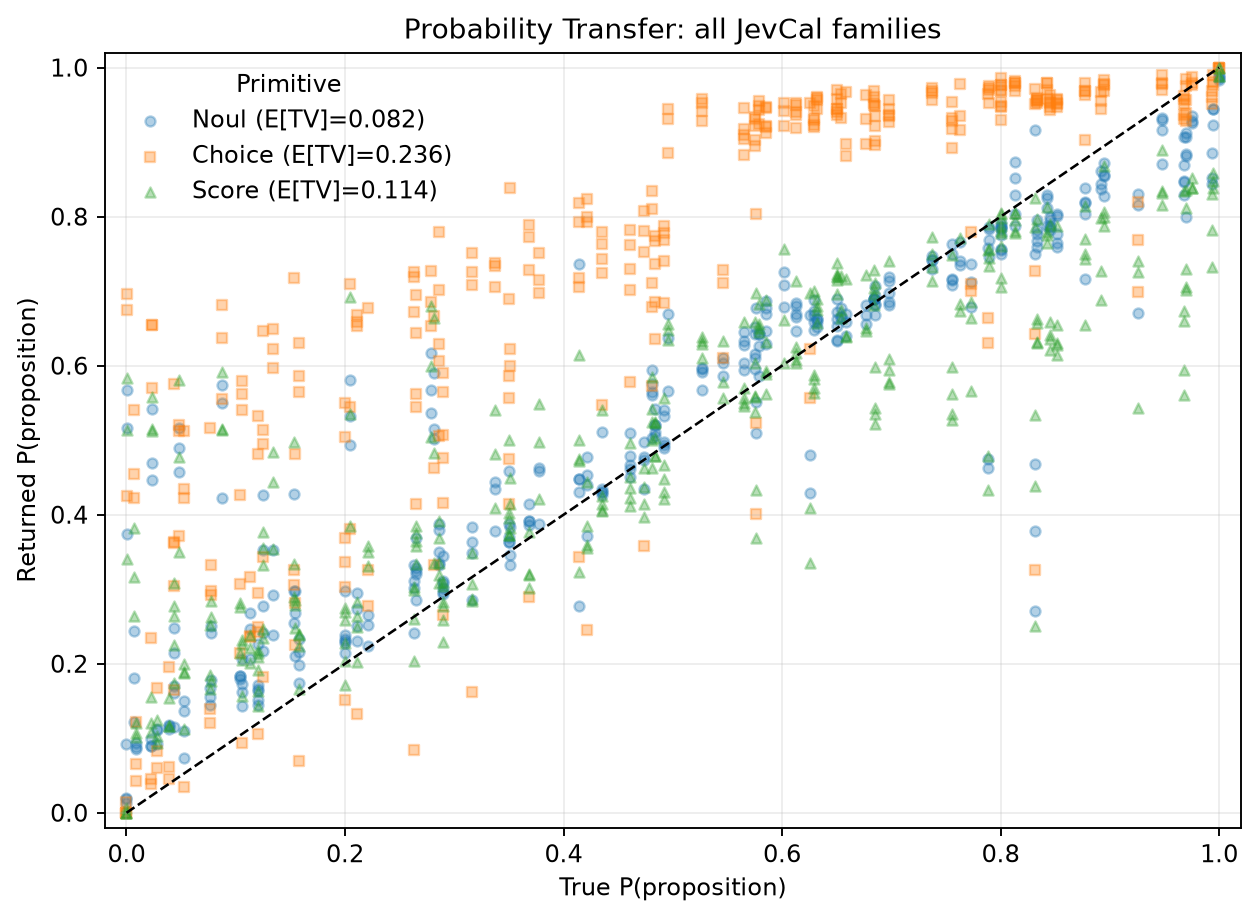
Jev 的出现标志着 System One Models 时代的到来:这类基础模型返回的是带概率分布的结构化决策,而非文本。除低成本与高速度外,Jev 的核心承诺是这些概率经过校准,但该说法缺乏公开测试支持;现有外部基准只评估置信度校准,而非每个返回选项的概率是否具有正确的数值含义。 为此我们提出 Sys1Cal-v1 数据集:其中的 True/False 问题对应命题 A,其精确概率 P(A) 在构造时即已知。每条数据经 Jev 的三个原语 Noul、Choice、Score 查询,并以与真实分布的全变差距离(total variation distance)评估,据此可估计 System One Models 的软准确率。 我们评估了 Jev 与开源 Choice 风格基线 SemIf,以展示该数据集的基准价值;本文则进一步聚焦 Jev,研究其 Score 与 Choice 答案的校准情况。我们发现一种特殊行为,可用「Jev 抑制了 True 与 False 之外的第三个真值」来解释:在 Choice 答案中,P(A) 与 P(¬A) 被呈现为 P(A)+P(¬A)=1,而缺失了不为零的 P(U) 项。 恢复 P(U) 使 Choice 答案的中位软准确率从 0.771 升至 0.978,表明即使在二值决策中,Jev 也想给出第三个选项:「我不知道」。
论文精读
TL;DR Sys1Cal-v1 用已知真实概率的判断题数据集评估概率校准,发现 Jev 的 Choice 隐藏了“不知道”第三值,恢复后中位软准确率从 0.771 升至 0.978。
问题
问题背景
System One 模型(如 Jev)以结构化概率分布替代文本输出,其核心承诺是返回的每个选项概率具有校准意义,即 P(A) 在数值上等于真实概率。这类模型因低成本和高速推理,正被用于需要快速决策的场景。
现有方法局限
目前没有任何公开测试能验证 Jev 概率校准的宣称。外部基准(如 confidence calibration 相关测试)只衡量置信度校准——即模型预测概率与经验频率的一致性,而不检验每个返回选项的概率是否具有正确的数值含义。简单说,模型可以说 P(A)=0.8,但如果 P(¬A)=0.2 被隐式强制为互补概率,则无法发现模型内部是否压抑了“未知”质量。现有评测无法捕捉这种系统性偏差,因为缺少已知真实概率的构造数据集。
为什么这个问题难/重要
技术难点在于:要精确评测概率校准,需要每个问题 A 的真实 P(A) 是已知且可控 的。这通常需要从随机过程中构造命题,代价高且规模有限。同时,下游决策规则(如贝叶斯决策、代价敏感分类、自主系统的拒答机制)直接依赖概率数值,而非仅 argmax 类别。如果概率被扭曲(例如强制二值化),模型可能在不确定时给出过度自信的决策,导致高代价误判。业界对可靠不确定性量化需求持续上升,特别是在安全关键场景。
行业类比
类似自动驾驶感知模块 输出“前方有行人概率 0.9”,若实际存在“传感器噪声遮挡”导致未知质量被压缩,规划层会做出危险变道。
核心洞察
- 核心定义:Sys1Cal-v1 改变了概率校准测评方式,从仅评估置信度排序转向评估每个选项概率的数值含义。数据集通过构造已知真实概率 P(A) 的 True/False 问题,使总变差距离成为可行的严格度量。这与现有基准(仅检查预测概率与正确率的频率一致性)有本质差异,能暴露 Jev 的 Choice 输出在归一化后出现的系统性偏差(中位 soft accuracy 仅 0.771),为 System One 模型提供更可靠的诊断工具。
- 关键发现:Jev 的 Choice 原语在二值决策中隐式抑制了第三个真值 P(U)(“我不知道”),将 P(A)+P(¬A) 强制为 1,导致概率分布失真。通过从 Score 原语等信号中恢复 P(U),Choice 答案的中位 soft accuracy 从 0.771 提升至 0.978,说明 System One 模型在结构输出中应显式建模不确定/弃权类,而非把质量归因于模型能力。该差异对下游成本敏感决策和自动拒答系统有直接工程启示。
方法
输入与构建
Sys1Cal-v1 的输入是一组关于命题 A 的 True/False 问题,其中 P(A) 的真实概率由构造过程精确可知(例如通过组合独立随机事件或从已知分布抽样生成)。每个样本被送入 Jev 的三种原语查询接口:Noul(自然语言概率输出)、Choice(二选一概率分布)和 Score(标量置信度得分)。
关键模块:查询原语与投影
- Noul 原语要求模型直接生成包含概率数值的文本,解析为分布。
- Choice 原语返回 P(A) 与 P(¬A) 两值,模型被强制二者之和为 1。
- Score 原语输出一个连续分数,需通过校准映射转为概率。
三种原语的输出被统一投影到同一概率空间,以便与真实分布比较。
输出与评估
使用 总变差距离(Total Variation Distance) 衡量模型输出分布与真实 P(A) 的差异,并由此计算 软精度(soft accuracy),即模型在概率数值意义下的平均正确程度,而非仅判断是否选择最高置信类别。
核心发现与修正
分析 Score 期望与 Choice 输出后,发现 Jev 内部存在一个被抑制的第三真值 U(对应“不知道”)。在二元选择中模型强行使 P(A)+P(¬A)=1,但真实分布中 P(U)≠0。恢复该项后,Choice 答案的中位软精度从 0.771 提升至 0.978。
Sys1Cal-v1 与同类校准基准的关键差异在于:它直接评估每个返回选项概率的数值准确性,而非仅评估置信度排序或 ECE 类指标,从而暴露了模型在二值决策中隐含的弃权需求。
实验
实验设计
- 使用 Sys1Cal-v1 数据集,构造已知
P(A)的 True/False 命题,分别通过 Jev 的三个原语Noul/Choice/Score查询。 - 评估指标为预测分布与真实分布的总变差距离,并由此估计 soft accuracy。
- 同时评测开源
Choice风格基线 SemIf,但论文重点在于揭示 Jev 的校准行为。
关键发现
- Jev 的
Score期望值暗示其内部存在非零的第三真值P(U),但在Choice输出中被抑制,表面维持P(A)+P(¬A)=1。 - 显式恢复
P(U)后,Choice 答案的中位 soft accuracy 从0.771提升至0.978。 - 这解释了 Jev 在二元决策中倾向“我不知道”,但输出层未提供该选项。
与基线对比解读
- 与只看 confidence calibration 的外部基准不同,Sys1Cal-v1 直接检验每个返回选项概率的数值意义,更贴近风险敏感决策。
- 工程启示:部署 System One Models 时不应默认概率已校准;需在可控数据集上验证分布距离,并考虑为模型增加显式不确定输出通道或允许第三选项。
行业影响
落地场景
System One 模型(如 Jev)以低延迟、结构化概率输出为核心,适合嵌入需要实时决策的产品链路。典型场景包括:
- 金融风控:信贷审批中根据违约概率决定自动放款、人工复核或直接拒绝;校准后的概率可直接映射到风险阈值。
- 医疗辅助诊断:影像识别系统返回病灶概率,若概率落在不确定区间则触发医生复核,避免误诊。
- 自动驾驶感知:障碍物分类概率用于规划模块的置信度权重,校准缺失会导致危险的过度自信。
- 内容平台审核:违规概率介于
0.4~0.6时转人工,减少漏判与误判。
商业价值
- 降本:通过恢复被抑制的“不知道”概率
P(U),模型在不确定时主动暴露无知,减少高风险错误带来的售后、法务或赔偿成本。 - 增收:在电商推荐、广告排序中,校准后的点击/转化概率可直接用于出价优化与库存分配,提升 ROI。
- 体验提升:避免模型盲目给出置信度极高的错误答案,下游可设计更合理的降级策略(如提示用户“信息不足”),增强信任感。
与现有工作流集成
Sys1Cal-v1 可作为离线评估集,定期对生产中的 System One 模型做概率校准监控。集成方式类似:
- 通过 API 调用 Jev 的
Noul/Choice/Score三种 primitive,获得原始分布。 - 在服务层加入 校准后处理:对
Choice输出重新引入P(U),例如将多余概率质量分配给“不确定”类别。 - 将校准后的概率送入下游决策引擎,设置不同阈值触发自动/人工流程。
关键启示:Jev 内部已经编码了不确定性,只是没有在
Choice原语中显式输出。工程上只需做轻量变换,就能将Choice的 median soft accuracy 从0.771提升至0.978,几乎零成本获得显著收益。
局限
- **数据集覆盖范围有限**:Sys1Cal-v1 仅包含 True/False 问题,且命题概率通过构造已知,这意味着它主要测试模型在简单、可形式化命题上的校准能力,无法覆盖开放域问答、长文本推理或多选项决策等复杂场景。此外,数据集的规模未在摘要中明确,可能较小,限制了统计显著性。与现有校准基准(如用于置信度校准的 ECE 类测试)相比,该数据集更关注概率的数值语义,但缺乏对置信度校准与概率校准之间关系的深入讨论,可能无法全面反映模型在实际下游任务中的表现。
- **方法依赖特定模型假设**:作者发现 Jev 在 Choice 答案中抑制了第三个真值 P(U),并通过恢复 P(U) 来提升软准确率。这一恢复过程依赖于对 Jev 内部决策机制的特定假设(即存在未表达的不确定性项),但论文未说明该方法是否可推广至其他 System One 模型或开源基线(如 SemIf)。如果该现象是 Jev 特有的模型偏差,则数据集的通用价值会打折扣;如果恢复 P(U) 需要额外的后处理步骤,则实际部署中如何自动检测和恢复 P(U) 尚不清晰,增加了工程集成的复杂度。
- **与同类工作的对比不足**:现有外部基准主要评估置信度校准(如 reliability diagrams 或 expected calibration error),而本文强调“每个选项概率的数值意义”,但未在实验部分与这些基准进行系统性对比,也没有说明在相同数据上两种校准度量的差异。此外,论文仅评估了 Jev 和 SemIf 两种模型,缺乏对更广泛 System One 模型家族(如其他闭源或开源模型)的测试,结论的普适性有待验证。未来工作可扩展更多模型类型,并建立概率校准与置信度校准之间的关联分析。