面向世界模型的自适应潜在容量
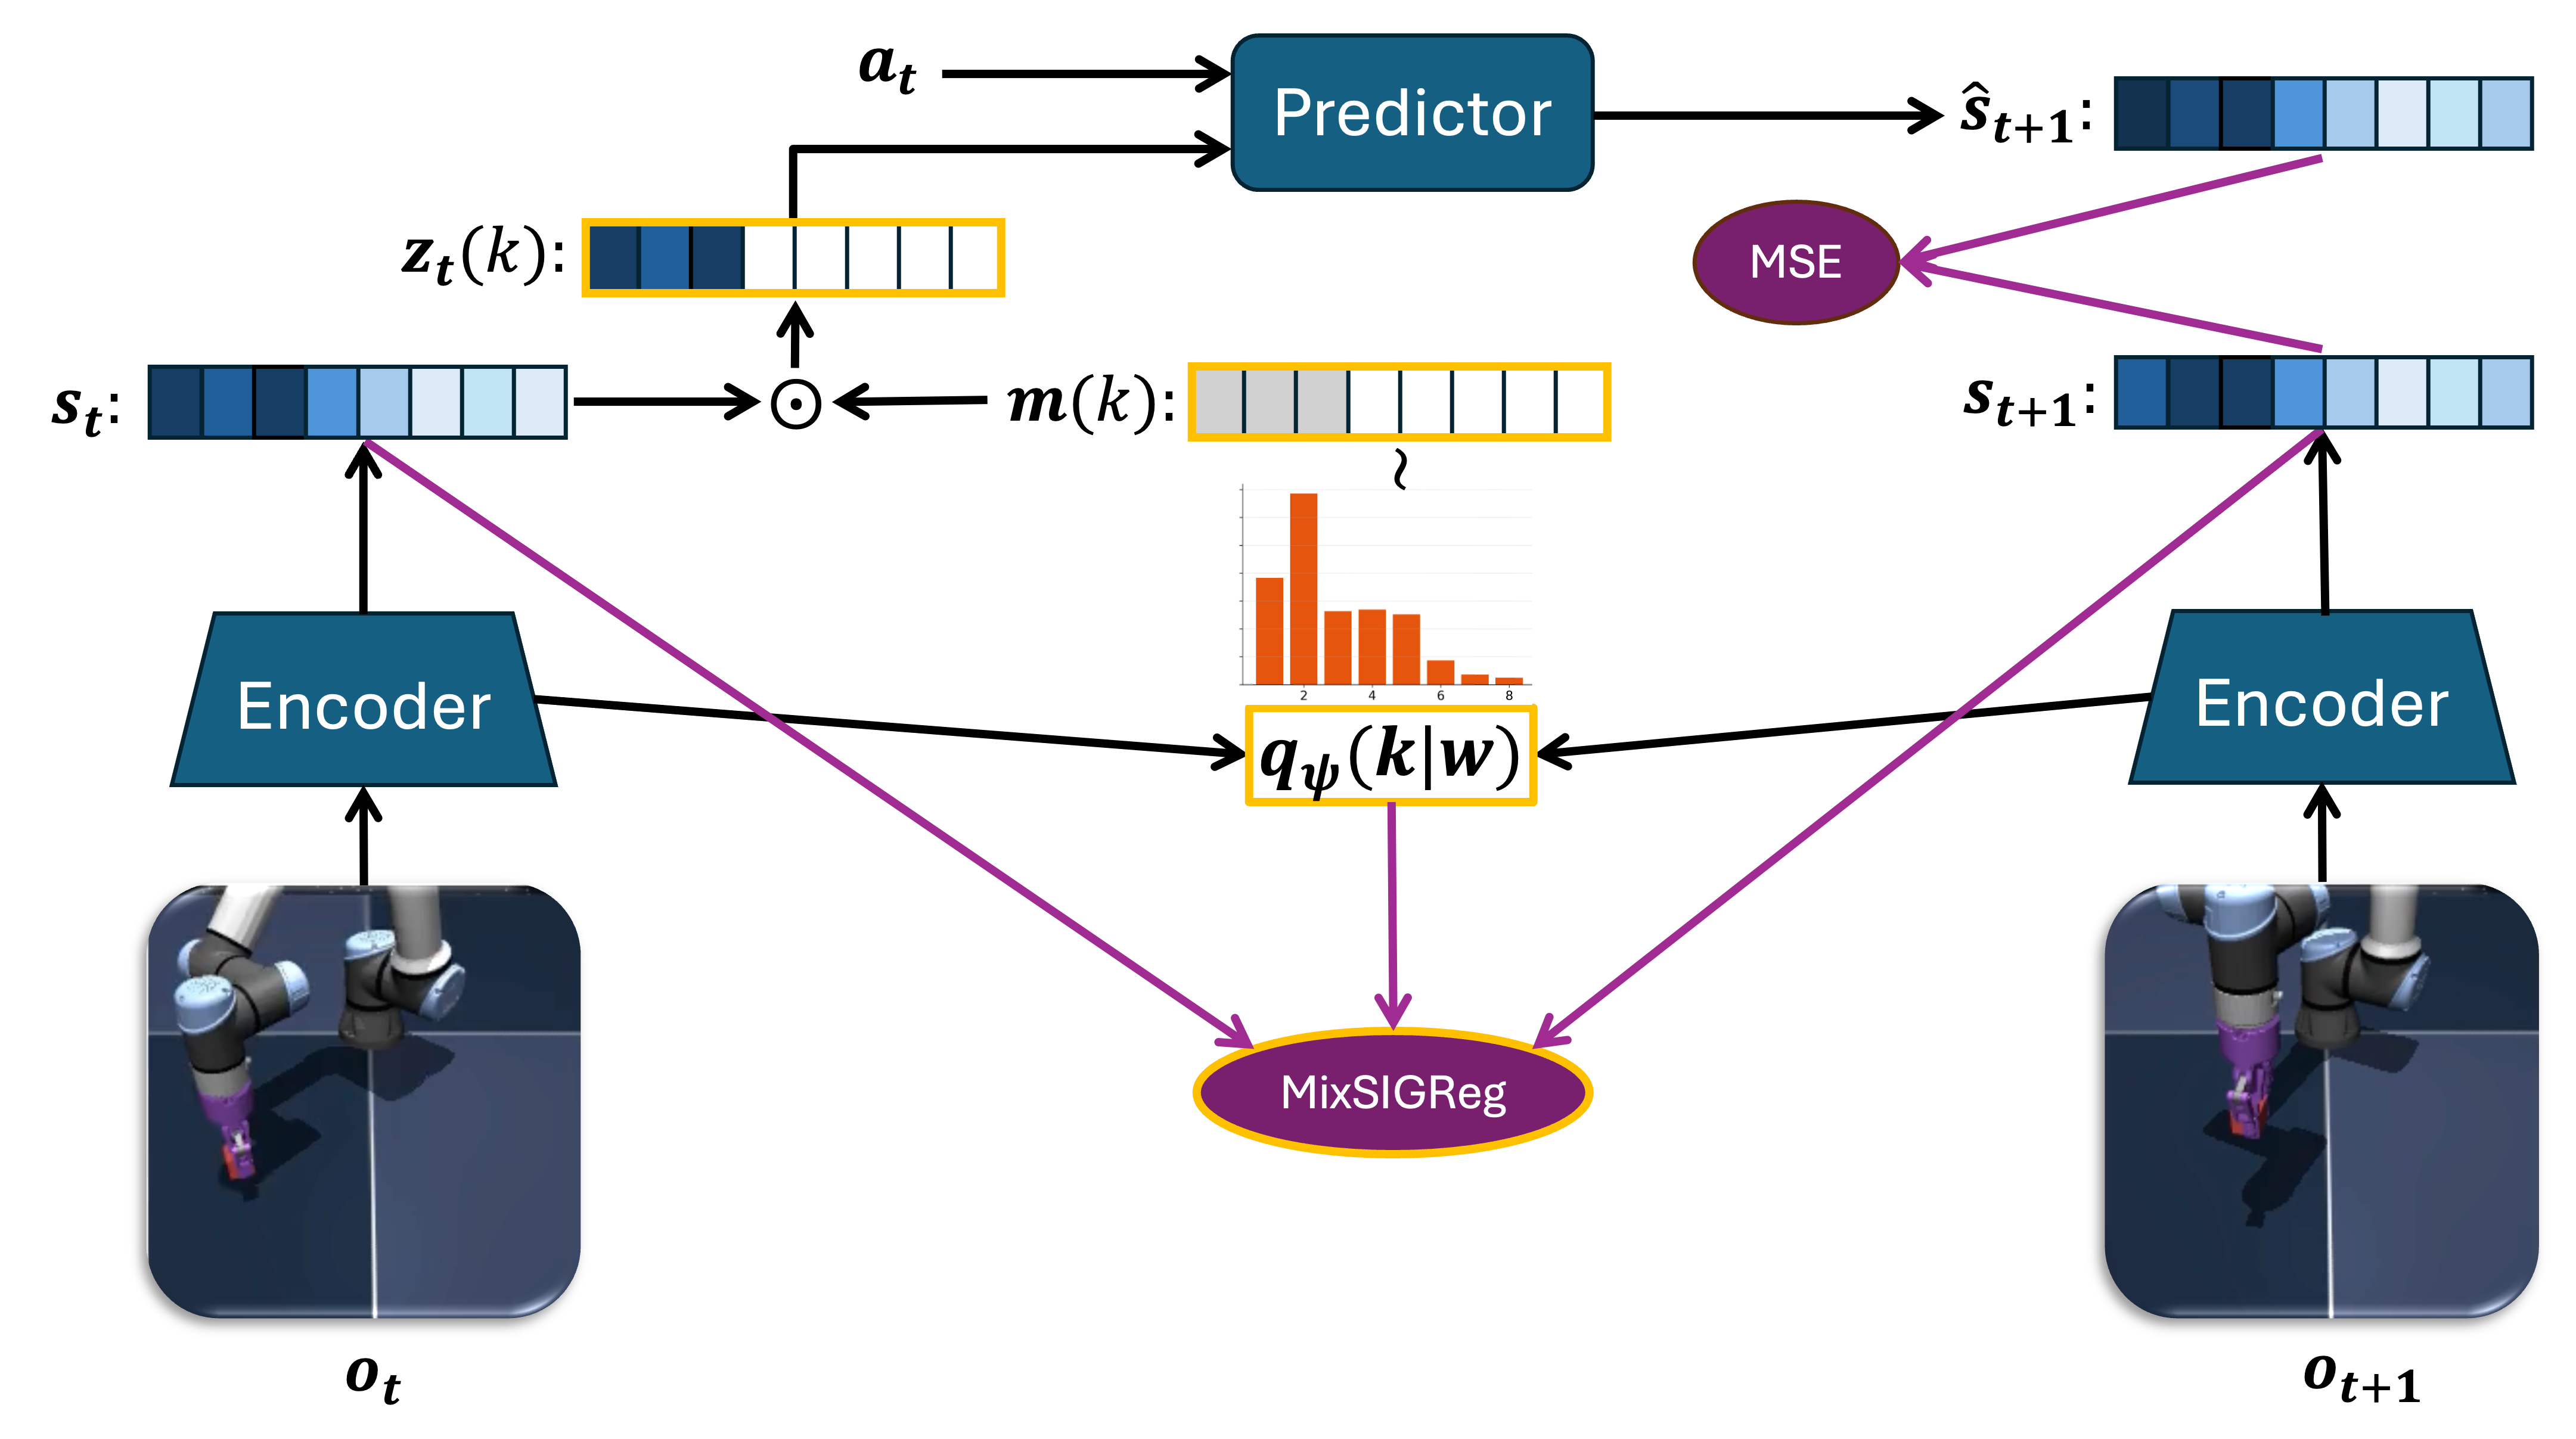
我们提出 Adaptive LeWorldModel (ALeWM),一种基于 joint-embedding predictive architecture (JEPA) 的 world model。它学会把预测性信息集中到宽 latent 表示的紧凑前缀里:ALeWM 学习一个以序列为条件的前缀长度分布,并训练 predictor 从采样的输入前缀估计完整的下一嵌入(next embedding)。 由于标准的防坍缩目标只鼓励 latent 各坐标产生差异,而不会按预测重要性对它们加以组织,我们进一步提出 MixSIGReg。它把 masked embeddings 正则化到一个先验加权的混合分布上:活跃前缀为高斯分布,其余坐标为零。由此,ALeWM 的目标促使靠前的坐标保留对预测与递归规划有用的信息。理论分析表明,MixSIGReg 所用的混合分布会给较早的坐标块分配更高方差、给较晚的坐标块分配更低方差;并且在给定假设下,把最有用于预测的信息放入靠前块可使预测误差最小化。 实验方面,我们在状态变量已知的可控动力系统以及 goal-conditioned visual control 中考察 ALeWM 的行为。结果显示,ALeWM 的平均成功率始终高于经过调优的固定宽度 LeWM,同时平均规划容量更低。
论文精读
TL;DR ALeWM 让世界模型动态学习把预测关键信息压缩到 latent 前缀,结合 MixSIGReg 正则化,在视觉控制中比固定宽度 LeWM 成功率更高且规划容量更省。
问题
问题背景
世界模型(world models)是 model-based RL 的核心组件,通过学习环境动态的 latent 预测模型,支持想象规划。当前研究关注如何学习更紧凑、可预测的 latent 表示,以降低规划计算开销。
现有方法局限
基于 JEPA 的世界模型通常使用固定宽度的 latent 向量,并配合 anti-collapse 正则(如 variance/covariance 约束)防止表示坍缩。但这些正则只保证各坐标之间保持变化,并不按预测重要性排序坐标。实际后果:
- latent 维度过小时,关键状态信息被压缩丢失,预测误差增大;
- latent 维度过大时,规划 rollout 的搜索成本随维度增长,长 horizon 下不可接受;
- 固定宽度无法根据环境复杂度或任务阶段动态调整容量,造成冗余计算。
为什么这个问题难/重要
难点在于必须同时满足:足够宽以避免信息瓶颈,足够紧凑以降低规划成本,以及自适应排序让早期维度承载预测关键信息。这需要设计专门的训练目标,使模型学会按预测重要性组织表示,而不是事后裁剪。业界高度关注,因为机器人与自动驾驶等需要长时程决策和实时推理的场景中,规划成本是部署瓶颈。
行业类比
这类似于 Transformer 推理中的 adaptive computation time 或 dynamic token sparsity:根据输入难度动态分配计算资源,而不是固定预算。
核心洞察
- 自适应潜在容量让世界模型根据状态上下文动态决定有效维度,不同于固定宽度 LeWM 的统一分配。ALeWM 学习序列条件下的前缀长度分布,使模型在简单状态用短前缀降低计算和规划成本,在复杂状态用长前缀保持预测精度;实验显示其平均成功率更高且平均规划容量更低,说明动态容量分配在实际控制任务中比固定宽度更高效。
- MixSIGReg 通过‘高斯活跃前缀 + 零填充’的先验混合分布对掩码嵌入正则化,显式诱导出按预测重要性排序的潜在坐标,与仅防止表示坍塌的标准 anti-collapse 目标形成本质区别。该正则赋予早期坐标块更高方差,从理论上保证预测误差最小化要求最有用的信息位于早期块,这为 JEPA 类模型提供了一种结构化的容量控制方式,也为截断尾部坐标实现低开销推理提供了依据。
方法
方法流程
输入:观测序列与动作,经编码器得到宽维度潜在表征(wide latent embedding)。
关键模块:
- 前缀长度分布:ALeWM 学习一个条件于序列的分布,采样得到可变的前缀长度。预测器仅从采样的前缀(前 k 个坐标)出发,估计完整的下一个嵌入;未被采样的尾部坐标置零。
- MixSIGReg 正则:将掩码后的嵌入与一个先验加权混合分布对齐——前缀为高斯、尾部为零。该混合分布逐块分配方差:靠前坐标块方差更高,靠后坐标块方差更低,从而诱导早期坐标承载更多预测信息。
- 固定前缀 rollout:规划时按采样前缀逐步滚动预测,允许以更少容量完成多步想象。
输出:一个有序的潜在表示,其中早期维度包含对预测与递归规划最有用的信息;模型可根据任务动态选择紧凑前缀,用于高效世界模型推理与控制。
与同类方法的差异:相比固定宽度的 LeWM 使用统一容量,ALeWM 让容量自适应于序列难度,并通过 MixSIGReg 显式组织坐标的预测重要性排序,而非仅防止表示坍缩。
实验
实验设计
- 在 受控阻尼振荡器 (controlled damped oscillators) 与 目标条件视觉控制 (goal-conditioned visual control) 两个设定上评估 ALeWM。
- 基线为调优的固定宽度 LeWM,比较平均成功率和平均规划容量。
- 理论分析部分验证 MixSIGReg 使早期坐标块方差更高,以及预测误差最小化要求早期块优先承载预测信息。
关键发现
- ALeWM 在两个实验设定下均取得更高平均成功率,同时平均规划容量更低。
- 这一结果表明自适应容量机制能成功将预测信息浓缩到紧凑前缀,实现表示排序。
- 更低的规划容量意味着在 rollout 和规划时使用更紧凑的潜在表示,减少计算开销。
与基线对比解读
- 固定宽度 LeWM 需要人工调整潜在宽度,过宽浪费容量,过窄损害性能;而 ALeWM 通过序列条件前缀分布动态决定所需容量。
- ALeWM 在更低规划容量下取得更高成功率,说明其不是简单牺牲容量换效率,而是更有效地利用潜在表示,将关键预测信息放在早期坐标,使后续规划可以忽略尾部噪声。
- 这一设计为世界模型在资源受限场景(如边缘设备上的模型预测控制)提供了新思路。
行业影响
落地场景
- 机器人操作:在视觉运动控制中,ALeWM 学习环境动力学,用于模型预测控制(MPC)。自适应前缀长度使简单任务用更少潜在维度,降低实时推理延迟。
- 自动驾驶:世界模型模拟交通参与者,ALeWM 根据场景复杂度动态分配容量,在高速路况节省算力,在城市路口保持预测精度。
- 电商推荐:将用户行为建模为世界模型,用于离线策略评估与优化,自适应容量降低大规模模拟的 GPU 成本。
商业价值
- 降本:推理时平均规划容量降低,减少云端或边缘设备算力与能耗。
- 体验提升:保持成功率同时降低延迟,提升交互应用响应速度。
- 灵活性:无需手动调优潜在宽度,减少超参数搜索与工程成本。
与现有工作流的接口
ALeWM 可集成进 JEPA 类世界模型(如 LeWM),替换固定宽度潜在表示。核心改动:
- 添加容量网络,输出前缀长度分布并采样
k。 - 预测器只使用前
k个潜在坐标预测下一嵌入。 - 训练加入 MixSIGReg 正则化,使早期坐标方差大、晚期趋零。
现成代码见项目主页 AAIR-ALeWM。模块与 PyTorch / JAX 训练栈兼容,可平滑接入已有世界模型流程。
局限
- **实验规模与泛化性有限**:论文仅在受控阻尼振荡器和目标条件视觉控制(如 Reacher)等低维或简单视觉环境中验证 ALeWM,未在大规模高维基准(如 Atari、DeepMind Control Suite 全任务)或真实机器人任务中测试。因此,该方法在复杂环境下的可扩展性、对高维观测的鲁棒性,以及与其他主流世界模型(如 DreamerV3、IRIS)的性能差异尚不明确。这限制了其作为通用世界模型改进的直接说服力。
- **引入额外模块与超参数**:ALeWM 需要训练一个额外的容量网络来预测前缀长度分布,并引入 MixSIGReg 正则化项,其中涉及先验混合分布、块划分、温度系数等超参数。这些增加的设计自由度虽然带来性能提升,但也提高了调参复杂度和训练开销,可能阻碍在资源受限场景下的快速应用。论文未充分讨论这些超参数的敏感性及选择依据。
- **理论假设与实际优化的差距**:论文在理论分析中依赖特定假设(如线性预测、特定先验分布),证明预测误差最小化倾向于将信息置于早期块,但实际模型使用非线性编码器和复杂优化目标,理论保证可能不完全适用。此外,训练过程中通过 straight-through 采样前缀长度,离散采样可能引入梯度偏差,影响训练的稳定性和收敛性,文中对此分析不足。