VoxMem: 在大型音频语言模型中对多模态记忆进行基准评测
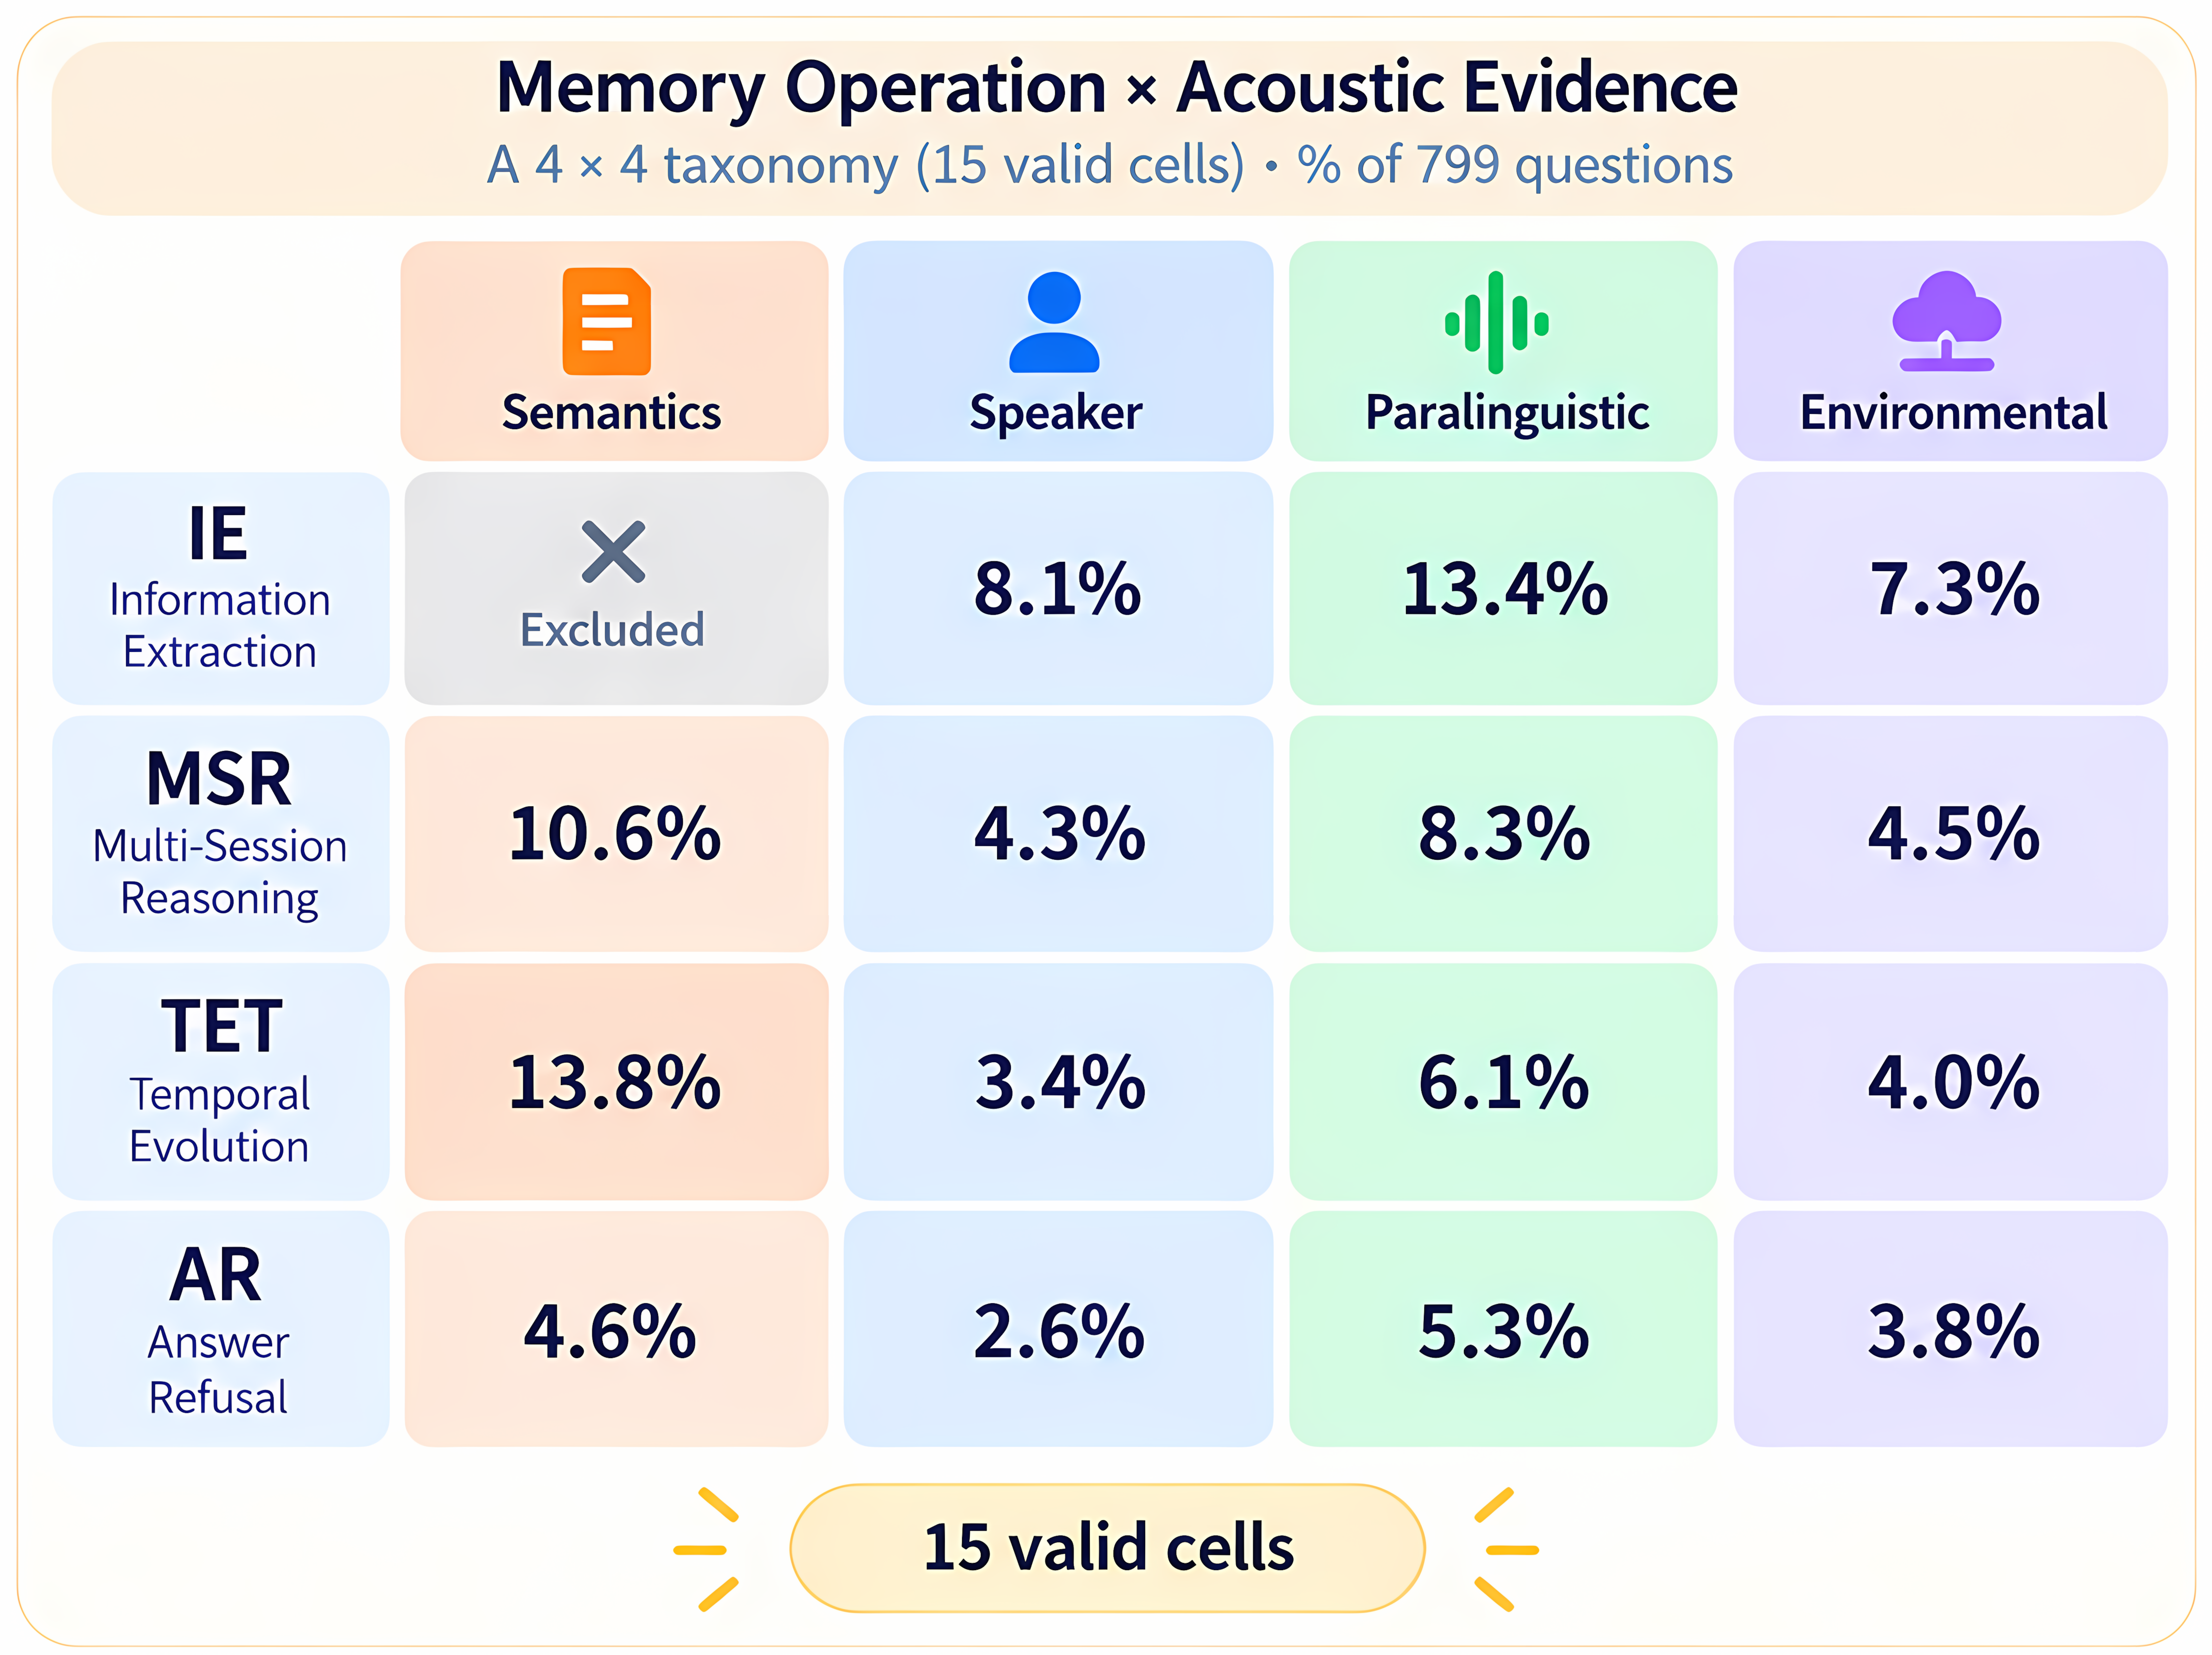
口语对话系统必须从既往交互中恢复信息(即记忆),但语音中的相关信息不止于「说了什么」,还延伸到「谁说的」「怎么说的」「听到了什么」——这些信息仅存在于音频信号中,无法从转写文本恢复。 除「记住什么」之外,记忆还要求多样化的操作:检索单个事实、跨轮整合证据、追踪不断演化的状态。真实交互还跨会话展开,信息在不同 episode 间累积,而非存在于单一连续录音中。现有 benchmark 在这三个维度上均有欠缺: 1. 主要聚焦词汇内容; 2. 采用有限且临时拼凑的记忆操作; 3. 把记忆视为单会话问题。 作者主张,有原则的记忆评估需联合刻画应当保留的声学证据 与施加其上的操作,并据此提出双轴分类法。 基于该分类法,作者提出 VoxMem:包含 3,196 个评估实例、覆盖 34,743 个语音会话(177 小时),将四种声学证据类型(speech semantics、speaker identity、paralinguistic cues、environmental sound)与四种记忆操作(information extraction、multi-session reasoning、temporal tracking、answer refusal)交叉组合,立足于多会话历史,并按 8K 至 64K token 的上下文预算分层。在 15 个 LALMs 上的评测显示,32K 设置下无任何模型超过 40%;模型对「说了什么」的保留远好于「谁说的」「怎么说的」或「听到了什么」,该差距在复杂操作上扩大、随历史长度增长,并在不同证据类型下表现为性质各异的失败模式。VoxMem 旨在为全面衡量并推动口语对话记忆研究提供基础。
论文精读
TL;DR VoxMem 提出首个多模态语音记忆基准,从声学证据类型与记忆操作两维评估 LALM;实测 15 个模型在 32K 下无一超 40%,且语义记忆远强于说话人、副语言和环境声。
问题
问题背景
语音对话系统(如 AI 助手、客服机器人)正朝着跨会话记忆演进,但评测基准仍以语音识别后文本为主。
现有方法局限
- 记忆证据单一:现有基准通常仅提供 ASR 转录,丢弃了说话人身份、副语言特征(如语气、情感)与环境声,而这些信息仅存在于音频信号中,无法从文本恢复。
- 记忆操作有限:评测任务多为单事实检索,缺少跨会话证据整合、随时间状态跟踪与答案拒绝等真实交互需要的操作。
- 会话结构简化:记忆被当作单会话问题,忽略了跨多个独立会话的信息累积,且上下文长度固定,无法反映长时记忆的动态负载。
为什么难/重要
音频中的声学证据与文本语义正交,模型需同时处理多模态信息并绑定到正确会话,这对 LALM 的音频理解、长程上下文建模与记忆更新机制是双重挑战。构建此类基准需系统枚举证据类型与操作组合,并生成多会话自然语音数据,成本高但必要:如果评测无法覆盖完整记忆需求,模型优化将偏向文本记忆,导致实际部署中在“谁说的、怎么说、什么可听见”等关键信息上频繁失败。
行业类比
类似于多模态对话推荐系统:不仅要记住用户说了什么,还要记住说话时的情绪状态和背景环境声,才能给出精准且符合语境的响应。
核心洞察
- VoxMem 的核心洞察是:语音对话记忆评估必须将声学证据类型与记忆操作联合建模,因为非语义声学信息(说话人身份、副语言、环境音)无法从转录文本恢复,且不同操作对证据的依赖方式不同。与现有基准主要关注词法内容、采用有限临时操作相比,VoxMem 首次引入二维分类法,量化了 LALM 在“说了什么”与“谁说的/怎么说/背景音”之间的显著差距,该差距随上下文长度扩大,揭示仅依赖文本评估会系统性高估模型的实际记忆能力。
- 另一个关键洞察是:LALM 在长语音历史中的失败并非均匀遗忘,而是随证据类型和操作复杂度呈现定性不同的错误模式(如识别失败、定位错误、会话绑定错误)。VoxMem 通过细粒度错误归因发现,模型对说话人身份、副语言和环境声的保留能力远弱于词法内容,且在跨会话推理、多步整合等复杂操作中差距进一步放大,这为定向优化(如改进说话人分离、音频事件表示)提供了可操作的诊断信号,而以往基准缺乏这种细粒度错误画像。
方法
输入为多会话口语对话历史(spoken sessions),每条 session 为多轮音频,包含言语内容、说话人身份、副语言特征和环境声音。历史由多个 session 串联,模拟真实跨会话信息积累。
关键模块
- 二维分类法:横轴为声学证据类型(
speech semantics,speaker identity,paralinguistic cues,environmental sound),纵轴为记忆操作(information extraction,multi-session reasoning,temporal tracking,answer refusal)。每个评估实例归属唯一组合。 - 基准构建:使用 LLM 生成问题和证据规范,确保答案只能从音频信号推断;再生成多轮口语对话,注入音频原生约束(如声音事件必须真实出现在音频中)。经过候选验证和质量控制。
- 历史组装:将多个会话按顺序拼接,填充干扰会话,控制上下文长度从 8K 到 64K tokens,证据分散在不同 session。
- 评估协议:向 LALM 输入音频历史,模型需回答或拒绝;使用 LLM judge 按 rubrics 打分。
输出为模型在四种证据类型 × 四种操作的得分矩阵,以及随上下文长度变化曲线,暴露语义内容与声学细节的能力差距。
与同类方法差异:VoxMem 首次在多会话、可变上下文长度下联合评测声学证据的多模态记忆,显式区分“说了什么”与“谁说的/怎么说/听到什么”。
实验
实验设计叙述
VoxMem 构建了 3196 个评测实例,覆盖 34,743 个会话(177 小时),采用双轴分类法:四个声学证据类型(语音语义、说话人身份、副语言线索、环境声音)× 四个记忆操作(信息提取、多会话推理、时间追踪、答案拒绝)。评测 15 个 LALM,上下文预算从 8K 到 64K tokens 分层。
关键发现
- 没有一个模型在 32K 上下文超过 40% 准确率。
- 模型对 说了什么(语义)的保留远好于 谁说的(说话人身份)、怎么说(副语言)和 听到什么(环境声音)。
- 差距随操作复杂度增加而扩大,随历史长度增长而加剧,并呈现证据类型特定的失败模式。
工程启示:当前 LALM 的音频记忆偏重语音识别转写,对非语言声学信息的记忆能力严重不足。实际部署语音助手时,若需跨会话记住用户声纹、情绪或环境上下文,应引入专门的声学记忆模块或外部存储,而非依赖端到端音频模型。
与同类工作对比
现有基准多聚焦文本内容、采用有限且临时的记忆操作、将记忆视为单会话问题。VoxMem 首次通过声学证据 × 记忆操作的联合分类法,系统刻画多会话语音记忆。它揭示了即使最先进的 LALM,在音频原生信息上的记忆表现仍远低于文本转写所能达到的水平,表明音频模态的记忆是独立于 ASR 的挑战。该基准可作为后续模型改进的标尺,特别是在多会话、长上下文、非语义声学信息方面。
行业影响
落地场景
语音客服与智能外呼:跨多轮会话记忆客户声纹、情绪、背景环境声,用于模型选型与回归;会议助理:跨 session 追踪说话人身份和副语言线索,生成个性化摘要;车载语音助手:记忆驾驶员声纹与车内环境声,提升安全与个性化;远程医疗随访:长期追踪患者语音特征与多次问诊内容。
商业价值
- 降本:通过自动评估减少人工质检与重复人工处理,避免上线后记忆错误导致客诉。
- 增收:电商/金融语音助手跨会话记忆提升推荐准确率与复购率。
- 体验:识别“谁说的、怎么说、背景音”减少用户重复信息,提升自然度与包容性。
与现有产品/工作流接口
VoxMem 可直接嵌入 ASR+LLM 语音产品的 CI/CD 评估流水线,作为评测集驱动模型迭代。其 taxonomy(证据类型 × 操作 × 上下文长度)提供分层指标,适合与现有 eval 框架(如 lm-evaluation-harness)或内部标注平台集成。项目提供 GitHub 实现与提示词,可复用数据生成管线,快速搭建记忆能力基准。
局限
- - **合成音频带来的分布偏差**:VoxMem 使用 TTS 合成语音,尽管做了质量控制,但合成音频与真实会话语境中的自发语音(如重叠、犹豫、方言、噪声、混响)仍有差距。模型在合成音频上的能力可能无法直接迁移到真实口语记忆任务,导致基准分数与实际系统表现存在系统性的高估或低估。
- - **上下文长度上限与数据规模有限**:基准覆盖的上下文最多 64K token,但真实多会话记忆往往跨越更长时日,历史信息量远超此限;此外,3,196 个评估实例和 34,743 个会话在细粒度分析(如每个 evidence × operation 子类)时可能样本不足,影响结论的统计稳健性。
- - **生成管道与自动评分引入偏差**:问题和答案由 LLM 自动生成,可能偏向模板化或简化真实用户提问的多样性;打分器基于文本输出,对声学独有信息(如说话人身份、副语言复述)的评估能力有限,可能掩盖模型在这类证据上的部分错误模式。