LastOPD: 抑制 Latent On-Policy Distillation 中的崩塌
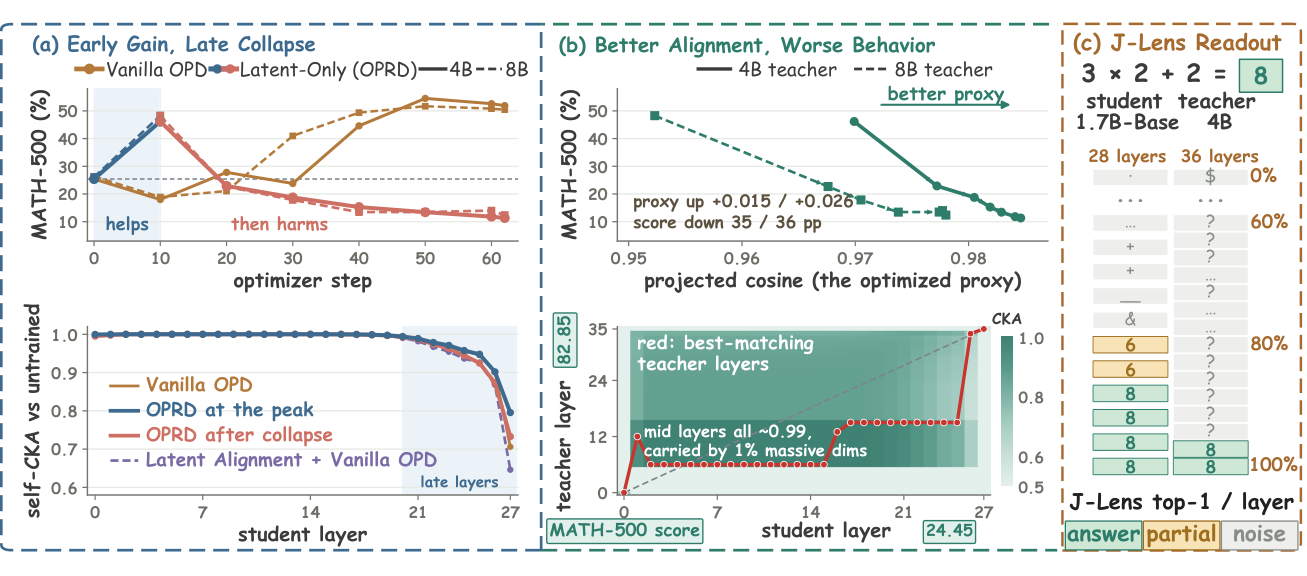
On-policy distillation (OPD) 只在学生模型自己生成的回复上做纠正,但其监督信号是教师的 next-token 分布:它告诉学生教师说了什么,却漏掉了教师怎么想。Latent supervision 有望补上这部分缺失,通过把学生的隐状态与教师对齐;近期方法如 OPRD 已将该信号引入 on-policy distillation。 然而在把 Qwen3-4B 与 Qwen3-8B 蒸馏进 Qwen3-1.7B-Base 时,我们发现这一配方有两种失败模式: 1. 早期收益,后期崩塌:仅靠隐空间监督即可在 10 步内把 MATH-500 准确率从 25 提升到 46,但后续训练使性能跌至 11 且不再恢复。 2. 对齐更好,行为更差:崩塌过程中对齐指标持续上升,而最对齐的模型反而表现最差。 进一步分析表明,问题出在隐空间信号的作用方式:按深度配对的层在两个模型中承担的角色不同,持续对齐可能把学生拉向它无法理解的教师状态。为此我们提出 LastOPD:只在最后一层状态施加隐空间信号——这是两个 LM head 共同读取的通用接口——且仅限 10 步 crossfade 进入 token 级 OPD 期间,从而保留隐空间信号中有用的部分,并在崩塌发生前把学生交给 token 级监督。 大量实验显示,LastOPD 在 4B 与 8B 教师下分别比纯 token 级 OPD 在 MATH-500 上提升 5.55 与 4.02 分,在多数 held-out 数据集上领先,并以约一半的步数达到纯 token 级 OPD 的最终分数。代码已开源。
论文精读
TL;DR LastOPD 在在线策略蒸馏初期仅对齐最后一层隐状态并平滑切换到 token 级监督,有效防止了隐式蒸馏晚期崩溃,使 MATH-500 提升 5.55 分且收敛减半。
问题
问题背景
On-policy distillation (OPD) 是高效压缩大模型的重要路线:学生模型在自生成响应上与教师分布对齐,能减少离线蒸馏的分布偏移,同时保持训练效率。业界关注如何在有限算力下提升小模型的推理上限。
现有方法局限
纯 token-level OPD 只传递教师的下一 token 分布,监督信号停留在“说什么”,无法传递“怎么想”。近年 latent supervision(如 OPRD)尝试对齐学生与教师的中间隐藏状态,以弥补推理过程信号。但原生方案存在两个典型失效模式:
- 早期增益,后期崩溃 :在 Qwen3-4B → Qwen3-1.7B-Base 蒸馏中,latent 信号仅 10 步可将
MATH-500从 25 拉到 46,但继续训练会退化到 11,且无恢复。 - 对齐越好,行为越差 :对齐指标持续提升时,最对齐的模型性能反而最差。
深层原因是层配对不匹配:按深度强行对齐不同模型的层状态,会迫使学生模仿教师中它无法理解的表示,导致过拟合与能力破坏。
为什么这个问题难/重要
Latent 对齐被证明能提供 token 信号缺失的推理信息,但何时、在哪一层注入该信号缺乏理论保证。不同深度模型的功能分层差异显著,盲目对齐会引入有害约束。对 AI 工程而言,这意味着蒸馏时不能简单增加 latent loss,需要设计信号注入的位置与时序,否则可能比纯 token 蒸馏更差。该问题在 4B/8B 教师蒸馏到 1.7B 学生的常见规模上即可复现,直接影响工业界低成本部署推理模型。
行业类比
类似于在 RLHF 中同时优化 reward 与 KL 散度:如果 KL 惩罚不加控制地作用于全部层,会限制策略探索并引发模式崩塌;只有精准控制约束位置与强度(如只约束最后层表示并退火),才能保住语言能力同时提升推理。
核心洞察
- 潜在蒸馏中“更好的对齐、更差的行为”崩溃源于按深度配对层进行全层状态对齐,因为教师和学生的同深度层可能承担不同功能。 与现有 OPRD 等方法假设深度对应层可对齐不同,LastOPD 观察到继续对齐会强迫学生向它无法理解的教师状态靠拢,因此只对齐最后一层状态——这是两个语言模型头共同读取的接口,避免了中间层功能错位;这挑战了逐层对齐的默认做法,为潜在监督提供了更安全的注入位置。
- 潜在信号的注入时机与权重比信号本身更重要:只在训练前 10 步采用潜在监督并交叉淡化到 token-level OPD,可以保留早期增益并避免后期性能崩溃。 这一“10 步 crossfade”的设计与常规全程使用潜在损失或恒定加权的做法不同,它利用了潜在信号在训练初期能快速提升 MATH-500 的现象(25→46),但及时交还给 token-level 监督,防止后续性能下降(46→11)。这揭示出在蒸馏中不同监督信号存在最佳作用时间窗口,而非简单叠加。
方法
输入与输出
输入:教师模型、学生模型、训练提示集,以及在线策略蒸馏所需的采样配置。输出:经蒸馏训练的学生模型。
关键模块
On-policy 蒸馏管线:学生按当前策略采样生成响应,教师对每个 token 给出下一 token 概率分布,形成 token 级监督信号(通常用 KL 散度损失)。
最后层潜在对齐:与 OPRD 对多个中间层做逐层对齐不同,LastOPD 只对齐学生和教师最后一层隐藏状态。最后一层是两个模型语言模型头共同读取的接口,对齐该状态能传递“怎么想”的语义,同时避免深度不匹配层之间强行对齐造成的干扰。损失采用对最后一层状态的均方误差(MSE)或相似度损失。
10 步交叉淡化调度:训练前 10 步内,将潜在对齐损失与 token 级 OPD 损失按线性或余弦衰减的系数混合,初始给潜在项一定权重,10 步后衰减至 0,完全切换为 token 级监督。这保留了潜在信号早期快速提升 MATH-500 的优势,并在观察到崩溃前及时退出。
流程
学生 on-policy 采样 → 同时计算 token 级 KL 损失(教师分布 vs 学生分布)与最后层状态对齐损失 → 前 10 步按交叉淡化系数加权求和 → 第 10 步后仅用 token 级 KL 损失继续训练。
与同类方法(如 OPRD)的差异点:LastOPD 将潜在监督限定在最后一层状态,并在训练早期通过 short crossfade 退出,避免逐层长期对齐引发的性能崩溃。
实验
实验设计
- 在 Qwen3-4B 与 Qwen3-8B 教师蒸馏到 Qwen3-1.7B-Base 学生的设置下对比三种方案:纯 token 级 OPD、纯潜在监督 OPD、以及 LastOPD(仅末层状态对齐 + 10 步 crossfade 到 token 级)。
- 主评测 MATH-500,辅以多个 held-out 数据集观察泛化。
关键发现
- 纯潜在监督出现早期增益后崩溃:MATH-500 从 25 升至 46(10 步内),随后跌至 11,且对齐指标持续上升而行为恶化——说明层深度逐对对齐会将学生拉向无法理解的教师状态。
- LastOPD 保存有用潜在信号:末层是二者 LM head 的共同接口,10 步 crossfade 让学生及时转由 token 级监督接管,避免崩溃。
- 相比 token-only OPD,LastOPD 在 MATH-500 上分别提升 +5.55(4B 教师)和 +4.02(8B 教师),并在多数 held-out 数据集上领先,且只用约一半步数达到 token-only 的最终分数。
基线对比解读
- token-only OPD 只提供 next-token 分布,缺少“思考方式”;纯潜在监督则因层角色 mismatch 导致后期退化。LastOPD 的时空双重限制(仅末层 + 仅早期 crossfade)精准保留增益、规避崩溃,验证了潜在信号必须与 token 级信号在合适时机切换,而非全程持续叠加。
行业影响
落地场景
LastOPD 适用于任何需要将大参数 LLM 能力蒸馏到小参数模型的业务部署场景,尤其在多步推理要求高的场景中,避免 latent 对齐后期性能坍塌。典型 use case:
- 电商平台智能客服:使用 Qwen3-8B 作为 teacher 蒸馏 1.7B 模型,处理退货政策、优惠叠加计算等规则推理;LastOPD 可将 MATH-500 类推理准确率提升约 4-5 点,同时减少服务延迟与 GPU 成本。
- 在线教育自动解题 / 步骤讲解:蒸馏后的 1.7B 模型可实时生成解题步骤,替代 8B 模型,推理吞吐可提高 4-5 倍,且 LastOPD 训练步数减半,加速模型迭代。
商业价值
核心价值在降本与增效两条线:
- 降本:模型尺寸从 8B/4B 降至 1.7B,部署硬件门槛下降,推理成本显著降低;训练步骤减半进一步节省 GPU 时。
- 增效:避免 latent-only 后期崩溃导致线上事故,减少人工重训与数据清洗成本;准确率对标甚至超过 token-only OPD,降低用户错误率,提升服务可用性。
与现有产品 / 工作流的接口
LastOPD 只修改 latent loss 的位置和调度策略:仅对齐 last-layer state,在前 10 步 crossfade 到 token-level OPD。这可以作为现有 on-policy distillation 训练框架的插件式正则项,无需改动模型架构或推理代码。如果团队已使用 OPRD 或其他 latent distillation,只需替换对齐层与学习率 schedule,迁移成本低。训练可直接在现有 transformers / DeepSpeed 等 stack 上实现,输出模型与标准 HF checkpoint 兼容,便于上线。
局限
- - 实验范围受限:仅在 **Qwen3** 家族(4B/8B 教师到 1.7B 学生)上验证,未涉及其他架构或更大容量学生,泛化性存疑。核心评测 **MATH-500** 侧重数学推理,虽有部分 held-out 数据集,但对代码、指令跟随等通用能力的覆盖不足,可能高估方法在真实多任务场景下的收益。
- - 关键超参数 `crossfade` 的 10-step 设定缺乏系统性敏感性分析:作者仅展示该固定值有效,未充分论证步数选择对稳定性和最终性能的影响,也未提供自适应策略或理论依据。实际部署中,不同师生容量比、数据分布可能需要调整过渡长度,否则容易过早丢失 latent signal 的增益或过晚切换导致 collapse。
- - 方法选择仅对齐 **last-layer state**,虽能规避层间错配,但可能丢弃中间层蕴含的推理步骤信息。对于需要深层语义对齐的长程推理任务,最后层表征未必能充分传递教师“如何思考”;且论文未与更灵活的逐层选择或可学习映射等方法做充分对比,限制了方法的上限。