面向持续文档写作的 Knowledge Pull Requests
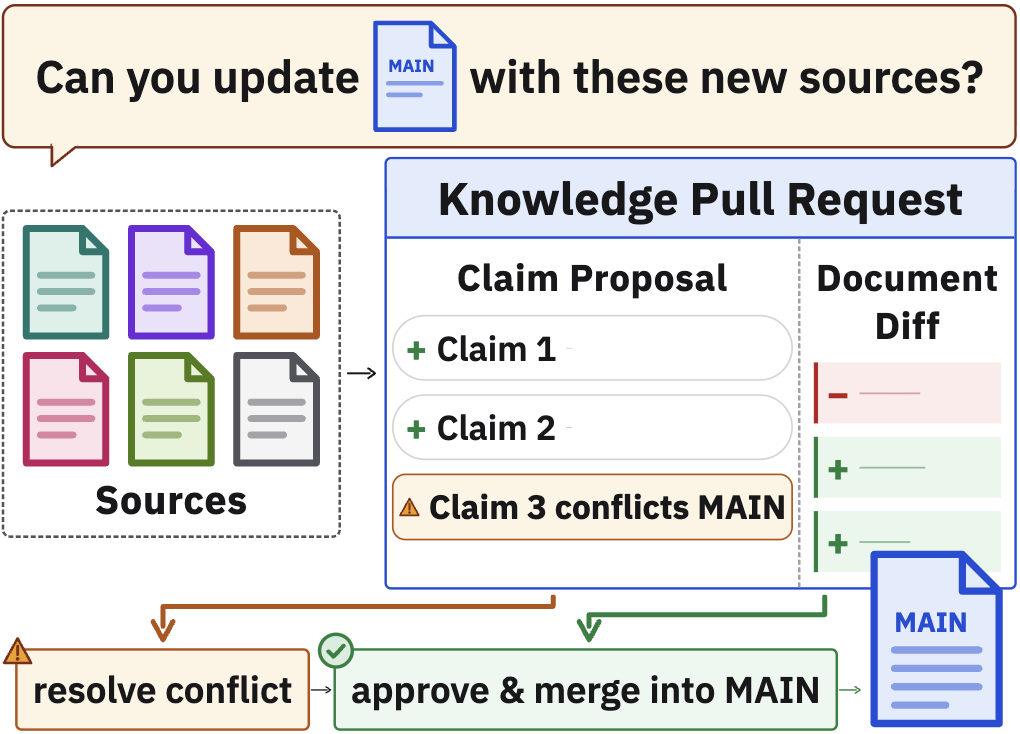
文档需要随着来自其他来源、其他语言或其他时间点的新知识不断修订,但现有方法要么在编辑时完全不考虑知识本身发生了什么变化,要么直接从头重新生成,使得每一次改动都难以解释。 我们提出 Knowledge Pull Requests(KPRs),一个面向持续文档写作的框架,让每一次改动都可解释。KPR 通过抽取 claims、将其过滤并路由到相应章节、并标记与现有内容的冲突,把新知识整合进文档;整个过程会产出一份 ChangeLog,将「知识变了什么」(claim proposal)与「文本变了什么」(document diff)分离开来。 我们在跨语言 Wikipedia 修订与 RAGTIME 上的查询驱动报告更新任务中评估 KPRs。结果显示,KPRs 相比从源材料改写或从头重新生成,能整合更多信息、更好地保留既有内容,并且每生成一个 token 所增加的信息量最多。此外,KPR 修订后的文章在支撑问答方面也优于带搜索的前沿模型,后者无法呈现仅记录在其他语言中的知识。
论文精读
TL;DR KPRs 将文档持续修订拆为**声明提案 + 文本差异**,通过提取、路由、冲突标记生成可解释 ChangeLog,在跨语言知识更新中比直接重写整合更多信息、保留更多原内容,且每 token 信息增量最高。
问题
问题背景
知识密集文档如 Wikipedia、技术文档需持续修订,核心关注知识内容变更的可解释性与已有内容保持。
现有方法局限
- 直接编辑:模型对原文档做局部修改,但不显式提取新增
claims,也不记录知识层面变更,导致难以审计“改了什么知识”。 - 从头重写:消耗大量 token,且常丢弃原文中未受影响的事实,产生冗余与不一致。
- 两者均未将“知识变化”与“文本变化”分离,冲突检测依赖隐式推理,缺乏结构化
ChangeLog。
为什么难/重要
文档修订不只是文本生成,需要从多语言、多来源、多时间点提取可验证 claims,并路由到相关章节、检测与现有内容冲突。技术上要平衡信息召回、内容保留与编辑成本。业界对自动化知识维护、多语言知识对齐及可审计更新需求强烈,KPR 以 claim 为单位进行知识整合,提供可解释的变更记录,提升 QA grounding 到多语言来源的能力。
行业类比
类似代码协作中 Pull Request 将代码变更原子化、可评审,KPR 将知识更新做成可审查的 claim 提案,使文档维护从“黑盒重写”走向可版本化的知识工程。
核心洞察
- 将知识更新单位从文本段落下沉到 claim(主张)层面,实现文档修订的意图与文字的分离。KPR 先抽取 claims、过滤路由并检测冲突,产出 ChangeLog 区分 claim proposal 与 document diff。相比直接编辑(无知识变更说明)或从头重生成(丢失已有内容),这种粒度让每次更新可审计、可回滚,并支持跨语言、跨时间的知识整合,显著区别于现有编辑方法。
- KPR 在跨语言 Wikipedia 更新与 RAGTIME 报告任务中,比重写或重新生成集成更多信息且更好保留原内容,每生成 token 的信息增量最高。其修订后文章在多语言问答上优于带搜索的前沿模型,因为后者无法检索仅以其他语言存在的知识。这揭示出:结构化的 claim 抽取与路由能有效利用非对齐语料中的隐性知识,为知识库维护和长文档自动更新提供了低成本高保真的工程路径。
方法
输入
- 给定一份主文档(如 Wikipedia 文章)和一组来源(sources,可能包含其他语言版本、最新报道或数据库),KPRs 目标是在保留原文结构的前提下融入新知识。
关键模块
- Claim Decomposition:从来源中抽取原子性声明(claims),每条 claim 表达一个独立事实,如实体关系、数值或事件。
- Claim Proposal:对候选 claims 做过滤(去重、可信度筛选)与路由(映射到文档对应章节),并检测与现有内容的冲突,标记需要更新或删除的旧 claim。
- Document diff:根据提案的 claims 生成文本级别的编辑操作,插入新句子、修改或删除旧句子,保持文档流畅性。
输出
最终产出ChangeLog,包含两层:知识层变更(claim proposal,说明哪些事实被添加/删除/修改)和文本层变更(document diff,显示具体字句差异),使得每次修订可解释、可审计。
差异点:与直接编辑(如 ConText)或完全重写(Scratch)不同,KPRs 将“知识变更”与“文本变更”解耦,以 claim 为原子单位驱动修订,既提升信息整合度,又减少对原文的破坏。
实验
实验设计
论文在两个场景验证 KPR 框架:
- 跨语言 Wikipedia 更新:利用不同语言版本的维基百科文章作为知识源,对某一语言的文章进行持续修订。
- RAGTIME 查询驱动报告更新:针对时间敏感的查询先检索生成报告,再基于新检索结果更新报告。
基线包括 ConText(上下文编辑)、ConClaim(基于 claim 的编辑)与 Scratch(从头重新生成)。
关键发现
- KPR 在集成信息量、保留已有内容、每 token 信息增益上均优于基线;通过将知识变化(Claim Proposal)与文本变化(Document Diff)解耦,生成 ChangeLog,使每次修订可解释、可审查。
- 经 KPR 修订的文章在问答任务中的接地能力优于前沿模型 + 搜索的组合,因为后者无法利用仅以其他语言存在的信息。
基线对比解读
相对于直接重写或从头生成,KPR 通过 Claim Decomposition 把新知识拆分为原子 claim,经 Filtering/Routing 定向插入到相关章节,并显式标记冲突,从而避免冗余重写,保留原文风格与已有信息。这一机制在需要持续维护且来源多样的文档(如技术文档、情报报告)中,比单一提示重写更可控、更高效,且产生的 ChangeLog 便于人工审核与版本审计。
行业影响
落地场景
KPR 适用于需要持续更新的文本资产:企业知识库、产品文档、法规合规手册、新闻摘要、多语言维基类内容。例如:
- 电商商品页面:从供应商多语言规格表、用户评价、售后反馈中提取 claim,自动同步到各语言商品描述,标记冲突(如尺寸、兼容性)。
- 企业服务知识库:当上游 API 文档、政策或行业标准更新时,自动拉取新知识,按章节路由,生成 ChangeLog 供人工审核。
商业价值
- 降本:减少人工重写整篇文档的成本;KPR 以 claim 为单位增量更新,编辑成本(token、时间)更低。
- 增收/体验:文档质量提升直接改善下游 QA 或搜索效果;论文显示 KPR 修订文章可超越带搜索的前沿模型,支持仅在其他语言存在的知识,提升多语言用户体验。
- 风险控制:冲突标记避免错误信息覆盖,满足合规审计要求。
接口与集成
KPR 可作为轻量级中间层嵌入现有 stack:
- 接入 LLM 网关(如 LangChain / 自建 pipeline),在文档生成后触发 KPR 流程。
- 与 内容管理系统 (CMS) 集成,将 claim proposal 和 document diff 作为 MR/PR 提交,保留人工审核环节。
- 利用 向量数据库 存储和检索已有 claims,快速判断冲突与冗余。
- 结合 RAG 系统,将更新后的文档实时同步到索引,提升检索准确性。
工程启示:KPR 将“知识变化”与“文本变化”解耦,使每次更新可跟踪、可回滚,比单纯 diff 或重写更贴近真实文档工作流。
局限
- - 论文默认使用 LLM 进行 claim 提取、冲突检测与路由,未讨论计算开销与延迟。在大规模文档库或实时更新场景下,每个更新请求都要完整执行 claim decomposition、proposal 和 diff 生成,推理成本可能远高于直接重写或编辑的基线。论文未提供 computational efficiency 的量化对比(仅报告了生成的 token 数量信息量),实际部署时 token 成本和延迟可能成为瓶颈。
- - 评估仅覆盖 Wikipedia 跨语言修订和 RAGTIME 报告更新两个中等规模任务,数据来源和文档结构相对规范(百科条目、结构化报告)。对于技术文档、法律文书、新闻稿等高度依赖上下文、隐含知识和领域规范的文档,claim 的原子化与路由策略是否仍然有效缺乏验证。跨语言实验仅考虑英德等少数语言对,对其他语言类型(如低资源语言)的表现未知。
- - 自动指标(information precision/recall, edit cost)无法完全反映文档质量的语义连贯性、语气一致性和事实冲突解决的准确度。尤其 conflict flagging 仅给出简单标记,未评估误报率或漏报率对最终文档可信度的影响。缺乏人工评审,且未见与人类编辑流程的对比,难以判断 KPR 生成的 ChangeLog 是否真正降低人工审核负担。