GAE:学习面向 3D 一致世界生成的几何原生潜空间
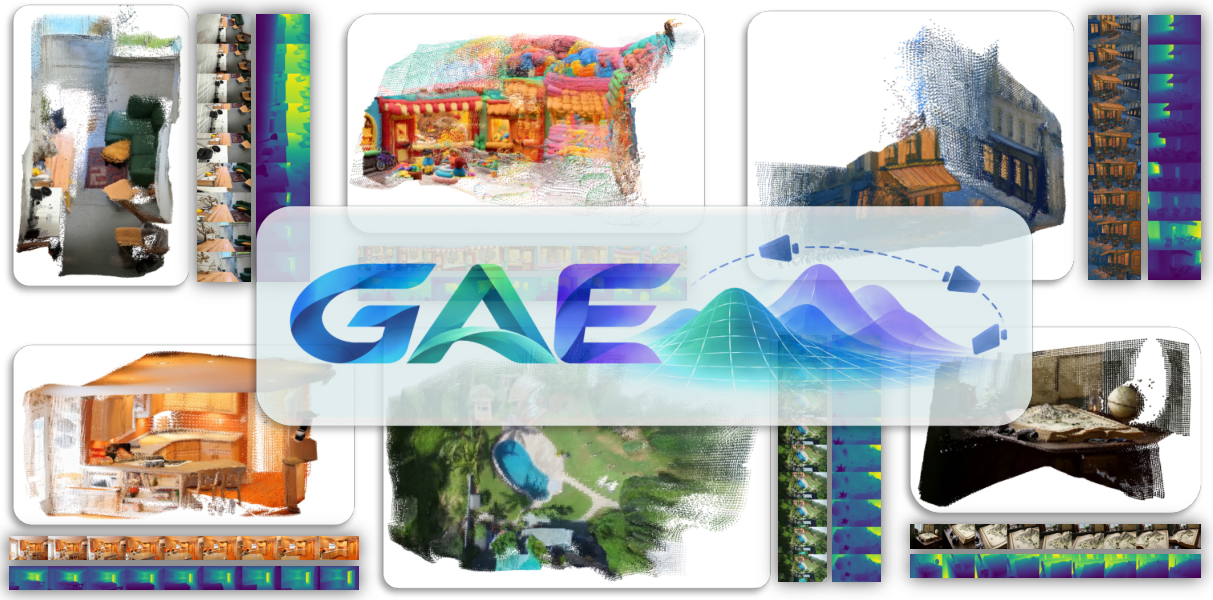
我们提出一个紧凑、几何原生 的潜空间,作为感知与生成的共享基础。 视觉生成器可以产出照片级真实的帧,却难以保持一致的 3D 场景。我们认为这不仅是建模问题,也是 表示问题:生成器通常演化以外观为中心的潜变量,而感知模型则在语义丰富的空间中恢复几何,该空间编码了跨视角结构。 我们没有把几何当作又一个输出,而是将 几何基础模型 的特征重参数化为一个紧凑的潜空间用于生成。我们以 geometry-native autoencoder (GAE) 实现这一转变,其潜变量可联合解码为外观、深度、相机与点图。在此基础上,标准的条件流(conditional flow)即可支持多样化的生成任务。 在固定生成器与训练协议的受控对比中,用 GAE 替换原有潜变量同时提升了视觉质量与独立测量的 3D 一致性:在 RealEstate10K 与 DL3DV 上 FVD 分别下降 12.7% 与 23.1%,RealEstate10K 上的相机轨迹误差减半。这些结果表明,潜空间 是几何一致生成的核心,并可作为感知与生成之间的共享接口。
论文精读
TL;DR GAE 学习几何原生潜在空间,可联合解码为 RGB、深度、相机和点图;替换标准生成器潜在后,在相同生成器下相机轨迹误差减半,FVD 显著下降,证明潜在表示是 3D 一致性生成的关键。
问题
问题背景
当前领域关注 3D 一致世界生成:视觉生成器能逐帧合成照片级图像,但在多视角或多帧序列中难以维持一致的底层 3D 场景结构,常出现相机运动时几何跳变、物体漂移等现象。
现有方法局限
主流生成模型在外观中心化潜在空间(appearance-centric latent)上操作,例如 VQGAN 潜码或像素/特征图。这类空间主要优化颜色和纹理重建,缺乏显式的跨视角结构编码。已有工作尝试将几何作为附加输出或条件,但生成过程仍由外观潜在主导,几何一致性没有内建到表示中;这导致生成视频的 3D 一致性差,相机轨迹误差大。此外,感知模型(如深度估计、点图回归)虽然能恢复几何丰富的语义特征,但这些特征没有被反向组织为适合生成的紧凑空间。
为什么这个问题难/重要
难点在于:潜在空间必须同时满足可解码性(RGB、深度、相机、点图)、紧凑性、以及条件生成的可控性,并保持跨视角几何结构。单纯添加 3D 损失或后处理难以奏效,因为误差在上游表征阶段已被固化。业界高度关注 3D 一致世界生成,因其是视频生成、具身智能、世界模型的核心瓶颈;若生成器不具备几何原生潜在,后续的相机控制、场景编辑、多视角合成都缺乏稳定底座。
行业类比
类似在具身智能仿真中,环境状态需要既能渲染出照片级图像,又能直接提供深度和位姿;若仅优化像素级外观,机器人在交互时会遇到空间不一致,如同视频模型在长镜头下“漂移”。
核心洞察
- **表示空间是 3D 一致性的瓶颈,而不仅是生成器架构或损失函数。** 现有视频生成器使用 appearance-centric latents,即使增加几何监督也难以保证跨视角结构。GAE 直接将 geometry foundation model 的语义丰富特征重新参数化为紧凑 latent,使生成器从一开始就生活在具有几何结构的空间中。与在 RGB latent 上附加几何损失或双分支解码的做法不同,GAE 从表示层面消除了 appearance 与 geometry 的割裂,因此在相同 generator 和训练协议下,FVD 下降 12.7%–23.1%,camera-trajectory error 减半。
- **GAE 将 perception 与 generation 统一到同一个 compact latent,作为 shared interface。** 该 latent 可联合解码为 appearance、depth、cameras、point maps,且这些输出彼此一致,避免了 post-hoc 融合多个模型的误差累积。与 3D-aware GAN(如 EG3D)依赖显式 tri-plane 或体渲染不同,GAE 保持 2D latent 但隐式编码 3D 结构,既保留了 2D generator 的高效性,又使条件 flow matching 能同时生成 photorealistic frames 和对应的几何输出,为多任务世界生成提供了简洁而强大的状态表示。
- **控制变量实验证明 latent space 选择对生成质量有因果影响。** 作者固定 generator 和 training protocol,仅替换 latent space(RGB-VAE vs. GAE),观察到 FVD 和 3D coherence 的显著改善。这种设计排除了模型容量、数据集规模、训练技巧等混淆因素,直接归因于 latent 的几何原生性。同类工作通常在完整系统层面比较,难以区分是表示改进还是生成器改进;GAE 的受控对比为社区提供了一个清晰的基准,说明在设计 3D 一致生成系统时,应优先考虑 latent 的几何语义而非仅增加几何输出分支。
方法
输入与整体流程
输入为单张参考图像及可选相机/文本条件。首先通过 geometry-native codec 将输入映射到紧凑几何原生潜在空间。
关键模块
- Geometry-native codec:编码器基于几何基础模型的特征层次,将其重新参数化为一个紧凑状态,而非直接输出几何。解码器联合解码为 RGB、深度图、相机参数 和 点图。
- 潜在空间组织:对潜在分布进行规范化与正则化,提升后续生成训练的稳定性与结构一致性。
- 条件流匹配:以潜在状态为生成目标,条件包括参考图像、相机射线和文本嵌入。采用标准条件流匹配训练,推理时从噪声采样并逐步去噪。
输出
生成具有 3D 一致性的新视角帧,同时可输出对应深度、相机位姿和点图,支持长序列 rollout 与文本控制。
与同类方法差异
不同于在现有外观潜在空间上附加几何输出或后处理对齐,GAE 直接将几何基础模型的特征压缩为生成状态,从表示层面统一感知与生成。
实验
实验设计
作者在 RealEstate10K 与 DL3DV 上进行了受控对比:固定生成器架构与训练协议,仅将潜在空间从 appearance-centric 替换为 GAE 的 geometry-native latent。评估指标包括视觉质量 FVD 和独立测量的 3D 一致性 camera-trajectory error。
关键发现
- FVD 在 RealEstate10K 与 DL3DV 上分别下降 12.7% 与 23.1%,表明生成帧的视觉质量与分布匹配度提升。
- camera-trajectory error 在 RealEstate10K 上减半,说明生成序列的相机轨迹与真实几何更一致。
与基线对比的深度解读
这一受控实验直接验证了论文核心论点:生成中的 3D 不一致不仅是模型架构问题,更是潜在空间表示问题。appearance-centric latent 缺乏跨视角结构约束,而 GAE 的几何原生潜在空间通过 joint decodable 到 depth、camera、point map 等显式几何量,迫使 generator 在几何一致的低维流形上采样。因此,即使生成器本身不变,仅更换 latent 即带来显著增益,凸显了将几何基础模型特征重参数化为生成状态的工程价值。
行业影响
落地场景
GAE 的几何原生潜空间可以直接用于 3D 一致性视频生成 和 可编辑场景重建。例如:
- 自动驾驶仿真:生成多视角一致的街景视频,减少几何断裂,提升训练数据质量。
- 电商 3D 商品展示:从单张商品图生成可旋转的 3D 商品视图,无需人工建模。
- 影视预演与虚拟制作:快速生成带准确相机轨迹和深度信息的场景预览,降低前期成本。
商业价值
将 GAE 作为生成基座能带来多重降本增效:
| 维度 | 影响 |
|---|---|
| 成本 | 减少人工修正 3D 几何不一致的后期工作;用单一潜空间替代多模型堆叠 |
| 质量 | FVD 下降 12.7%–23.1%,相机轨迹误差减半,直接提升内容可用性 |
| 体验 | 用户获得更稳定的多视角交互体验,如 VR/AR 场景漫游 |
与现有工作流集成
GAE 提供一个即插即用的 geometry-native latent,可替换现有视频生成模型中的 VAE 或 image tokenizer。集成路径:
- 将现有 flow matching / diffusion 模型的 latent 编码器替换为 GAE 的编码器;
- 复用已有条件机制(text、camera、reference tokens)进行训练;
- 输出端联合解码 RGB、深度、相机参数和点图,直接对接下游 3D 工具链(如 NeRF、3D Gaussian Splatting)。
现有产品团队可以在保持生成器架构不变的情况下,仅通过替换潜空间获得 3D 一致性提升。
局限
- **GAE** 的潜在空间源自**几何基础模型**(如 MASt3R)的特征,其性能受限于该模型对复杂动态场景、非刚性物体或极端视角的处理能力。论文实验主要使用 **RealEstate10K** 和 **DL3DV**,以静态建筑和室内场景为主,未验证室外动态环境或含显著运动物体的情形。若基础模型在这些条件下几何估计不准确,GAE 的潜在空间将难以保持跨视角一致性,进而影响生成质量。
- 方法采用两阶段训练:先训练 **geometry-native codec**,再在其潜在空间上训练**条件流匹配**生成器。这种设计增加了工程复杂度和训练时间,且阶段间可能存在误差累积。论文未给出详细的训练资源需求或推理效率数据,实际部署时可能面临显存占用高和延迟较大的问题,尤其在长序列 rollout 或实时生成场景中。
- 虽然相机轨迹误差在 **RealEstate10K** 上减半,但绝对误差仍然存在,且独立 3D 一致性指标(如 **xLNC**)的提升幅度是否足以满足严格几何应用(如可微渲染、仿真)尚不明确。FVD 主要衡量外观质量,不能完全反映几何细节;生成的点图和深度可能在边界处存在 artifacts。与显式 3D 表示(如 **NeRF** 或 **3DGS**)的生成方法相比,GAE 的潜在编码可能更偏向语义级一致性而非精确几何。