并非所有秩都相等:跨任务的预算感知 LoRA 合并
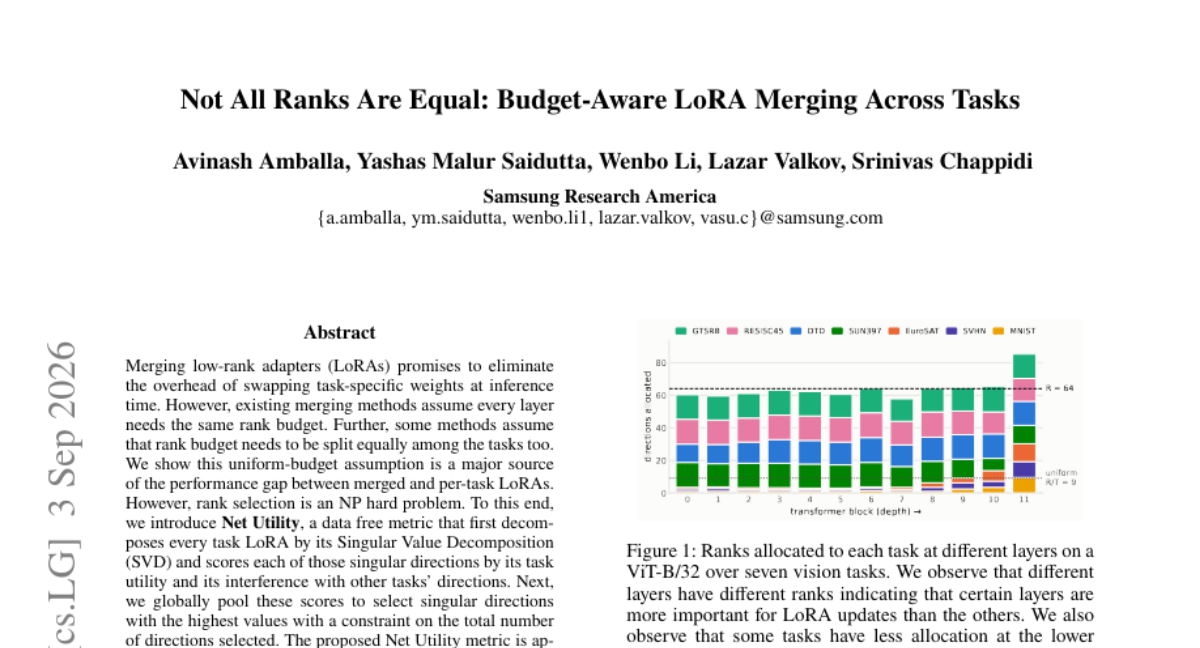
合并低秩适配器(LoRA)有望免除推理阶段切换任务专属权重的开销。然而,现有合并方法假设每一层都需要相同的秩预算 (rank budget),部分方法还假设秩预算需在任务之间平均分配。我们表明,这种均匀预算假设正是合并后 LoRA 与单任务 LoRA 之间性能差距的主要来源。但秩选择本身是一个 NP hard 问题。 为此,我们提出 Net Utility —— 一个无需数据的度量:它先对每个任务的 LoRA 做奇异值分解 (SVD),再对每个奇异方向按其任务效用,以及与其他任务方向之间的干扰程度打分。随后,我们将这些分数进行全局汇总,在所选方向总数的约束下,挑选出得分最高的奇异方向。 我们将 Net Utility 应用于三种合并空间中的五种合并方法,并在视觉与语言两组任务上完成合并。基于 Net Utility 的秩分配优于未做该分配的对照方法:在视觉任务上平均提升 +2.1% ,在语言任务上平均提升 +2.2%。
论文精读
TL;DR 提出 Net Utility 无数据度量:对每个 LoRA 做 SVD,按任务效用与跨任务干扰给奇异方向打分,全局优化秩预算分配,打破均匀分配假设,在视觉与语言任务上平均提升 2%+。
问题
问题背景
当前多任务 LoRA 部署面临推理时 adapter 切换开销,LoRA 合并成为消除开销的关键方向。
现有方法局限
现有合并方法(如 Task Arithmetic、Ties-Merging 等)普遍假设:每个层分配相同的 rank 预算,甚至任务间也平均分配。论文证明这一 uniform-budget 假设 是合并后模型与 per-task LoRA 性能差距的主要来源。不同层和不同任务对低秩方向的需求差异显著,但 rank 选择本身是 NP 难问题,缺乏数据无关、全局最优的分配策略,导致合并后性能下降。
为什么这个问题难/重要
难点在于:需要在不依赖额外数据的前提下,评估每个奇异方向(singular direction)的任务效用与跨任务干扰,并在总方向数约束下全局选择最优子集。这涉及 SVD 分解、几何度量与组合优化。业界对多任务推理的低延迟、低存储需求日益增长,有效的 rank 预算分配能显著提升合并模型质量,对端侧部署和高效推理有实际价值。
行业类比
类似于多任务视觉模型中,不同任务对 backbone 各层特征的敏感度不同,统一分配剪枝或量化预算会导致个别任务性能骤降,需要自适应资源分配。
核心洞察
- LoRA 合并性能差距的主要来源不是合并算法本身,而是均匀 rank 预算假设:不同层、不同任务对秩的需求差异极大,强行均分会导致关键方向被压缩或冗余方向被保留。现有方法如 Task Arithmetic、TIES、DARE 大多在每层使用相同秩,或在任务间均分预算,忽略了层间重要性差异与跨任务干扰。本文通过将秩选择形式化为 NP-hard 问题,避开暴力搜索,转而用数据无关的 Net Utility 对每个奇异方向独立评分,实现全局非均匀预算分配,从根源上缩小合并 LoRA 与单任务 LoRA 的性能差距。这一视角比单纯设计更复杂的合并算子更根本,解释了为何不同合并方法在相同均匀预算下都表现受限。
- Net Utility 将每个任务 LoRA 的 SVD 奇异方向作为可独立选择的单元,同时建模该方向对原任务的效用和对其他任务的干扰,并在全局总方向数约束下做贪心选择。这与以往按层或按任务分配秩的做法粒度更细,能自动识别某些层只需极少方向即可保持性能,而关键层需要更多方向,且不需要任何下游数据或梯度,仅依赖权重本身。该度量可即插即用叠加在五种合并方法和三个合并空间(如权重空间、子空间等)上,视觉和语言任务分别带来平均 +2.1% 和 +2.2% 的提升,表明它是一种通用的秩预算优化层,而非特定于某一合并算法的技巧。
方法
输入与问题设定
给定一组任务 LoRA 矩阵 (\Delta W_i = B_i A_i) 和一个全局 rank 预算 (R)(允许保留的奇异方向总数)。现有方法假设所有层、所有任务均分该预算,导致合并后性能与单任务 LoRA 存在明显差距。
关键模块
逐任务 SVD 分解
对每个任务的 LoRA 矩阵进行奇异值分解,得到一组奇异方向和对应的奇异值。每个奇异方向代表该任务权重更新中的一个低秩分量。Net Utility 评分
为每个奇异方向计算一个数据无关的分数,包含两部分:- 任务效用:该方向对自身任务性能的贡献,可由奇异值大小或启发式 surrogate 近似。
- 干扰惩罚:该方向与其他任务方向之间的重叠/冲突程度,通过行空间几何或子空间内积度量。 最终 Net Utility 为任务效用减去干扰项(可加权)。
全局池化与贪心选择
将所有任务、所有层的奇异方向汇总到一个全局候选池,按 Net Utility 降序排序。由于 rank 选择本身是 NP-hard,采用贪心策略选出前 (R) 个方向,同时满足总预算约束。选出的方向集合自然形成非均匀的层间与任务间 rank 分配。合并方法集成
将选出的奇异方向作为合并后的低秩结构,叠加在五种不同的 LoRA 合并方法之上(覆盖权重空间、子空间、奇异向量空间三种合并空间)。
输出
最终输出一个预算感知的合并 LoRA,各层及各任务的 rank 不再均等,而是由 Net Utility 决定。
与同类方法的差异
与 TIES、DARE、Task Arithmetic 等统一预算分配方法不同,Net Utility 首次在数据无关前提下,基于奇异方向的任务效用与跨任务干扰进行全局非均匀 rank 分配,从而缩小合并模型与逐任务 LoRA 的性能差距。
实验
实验设计
论文在 视觉任务 与 语言任务 两组 benchmark 上验证 Net Utility 预算分配方法。实验选取五种已有的 LoRA 合并方法,覆盖三个不同的合并空间(如权重空间、子空间等),并对比“均匀分配秩预算”与“Net Utility 全局选择奇异方向”两种策略。Net Utility 基于 SVD 分解对每个任务的 LoRA 奇异方向打分,结合任务内效用与跨任务干扰,在全局总方向数约束下选择最高分方向。
关键发现
- 均匀假设是性能差距的主要来源:合并 LoRA 与逐个任务 LoRA 的差距很大程度来自每层/每任务秩预算相等。
- Net Utility 在视觉任务上平均提升 +2.1%,语言任务上平均提升 +2.2%,且无需额外训练数据或梯度。
- 分析部分指出:不必花完全部预算、最优选择集不必是前缀、不同层/模块重要性差异显著。
与基线对比的深度解读
相比传统按层均分或按任务均分秩的方法,Net Utility 明确建模了奇异方向的“净效用”,并通过全局池化避免局部次优。这一数据无关、一次 SVD 的低成本策略,可无缝叠加于多种现有合并方法之上,为实际部署多任务 LoRA 提供了无需调参的秩分配方案。
行业影响
落地场景
多任务 LoRA 合并可直接用于端侧设备、边缘推理、多租户 SaaS 等需要同时服务多个 AI 任务的场景。例如电商平台的商品图片分类、文案情感分析、搜索意图识别等多个 LoRA 适配器,原本需动态换载,合并后单个模型即可覆盖全部任务,且不显著损失单任务精度。内容平台的语音识别、摘要生成、内容审核等 LoRA 也可合并为统一推理服务。论文在视觉与语言任务上分别带来 +2.1% 和 +2.2% 的平均性能提升,说明收益可跨模态复现。
商业价值
核心降本来自消除任务切换开销:不再需要为每个任务维护独立权重并在推理时交换,显存与存储占用大幅下降,尤其对端侧部署可直接降低硬件 BOM 成本。同时,合并模型性能接近单任务 LoRA,避免了过去因统一 rank 预算导致的质量下降,从而减少因性能不足带来的业务损失(如推荐点击率下降、分类错误率上升)。在多租户环境中,合并后的单一模型可同时服务多个客户任务,显著降低单位推理成本与运维复杂度。
与现有工作流接口
该方法作为数据无关的 rank 分配层,可插入现有 LoRA 训练后、合并前的流程。它只需各任务 LoRA 的权重矩阵,通过 SVD 分解与 Net Utility 评分即可输出全局 rank 预算分配,无需额外数据或反向传播。可直接配合 Task Arithmetic / TIES / DARE / RegMean / KnOTS 等五种主流合并方法,覆盖权重空间、子空间、激活空间三类合并空间。工程实现上,可将其封装为独立预处理模块,接入模型管理平台或 CI/CD 流水线,在合并前自动计算并缓存每层 rank 配置。
具体落地 use case:
- 电商搜索与推荐:将商品类目分类、搜索查询改写、点击率预估三个 LoRA 合并为一个服务,降低延迟与内存,同时保留各任务关键方向,避免统一预算导致的分类准确率下降。
- 医疗影像多任务分析:将器官分割、病灶检测、报告生成 LoRA 合并到单一推理引擎,在 CT/MRI 设备本地运行,减少模型加载时间并提升诊断辅助工具的响应速度。
局限
- 论文提出的 Net Utility 指标是数据免费的,这在实际部署中是优势,但同时也意味着它无法利用任务数据中的分布信息来更精准地评估奇异方向的重要性。当任务分布与训练 LoRA 时的数据分布存在漂移,或者不同任务间的干扰模式需要数据样例才能体现时,基于 SVD 分解的静态打分可能不够鲁棒。此外,论文未提供与数据驱动 rank 分配方法的直接对比,因此数据免费带来的性能损失程度尚不明确。
- Net Utility 依赖对每个任务 LoRA 进行 SVD 分解,并全局池化所有奇异方向进行评分选择。虽然论文声称计算是可接受的,但在超大参数模型(如数十亿参数)以及任务数量较多时,对所有 adapter 做 SVD 并计算成对干扰,其内存和计算开销可能成为瓶颈。作者在附录中提及复杂度分析,但缺少在真实大规模场景下的效率测量,这限制了对实际系统部署的参考价值。
- 实验仅在有限的视觉和语言任务集合上进行(视觉任务如 8 个,语言任务如 11 个,具体见论文),且这些任务可能具有相似的底层特征,不足以证明该方法在高度异构任务上的普适性。此外,论文将 Net Utility 应用于五种已有合并方法,但未探索与更先进的 rank 分配策略(如基于 Fisher 信息或基于梯度的选择)的对比,可能高估了其相对优势。全局 top-k 选择奇异方向本质上是一种贪心启发式,缺少对 NP-hard 问题的最优性保证,未来可结合理论分析进一步改进。