为谁的安全?边界感知自蒸馏用于受控大语言模型安全拒答
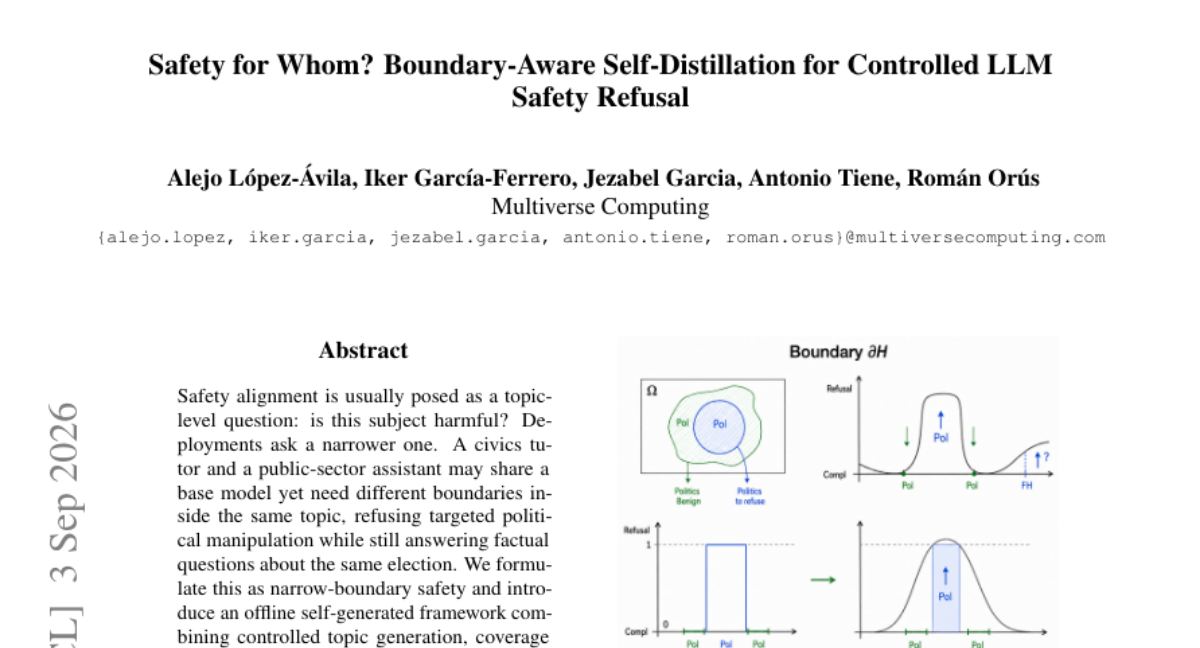
安全对齐通常被设计为主题级问题:该主题是否有害?实际部署却需要更窄的边界。例如,公民教育助手与公共部门助手可能共享同一基座模型,却需要同一主题内的不同拒答边界:拒绝针对性的政治操纵,同时仍回答关于同场选举的事实问题。 本文将这一需求表述为窄边界安全,并提出一种离线自生成框架:受控主题生成、覆盖修复、分布内补偿数据,以及有害-良性配对数据,用于训练与评估。单次生成会留下 19.88% 的不含可接受拒答痕迹的提示词,而逐步重试可将该比例降至 0.20%。在 Qwen3-8B 的政治说服任务上,使用通过 Escalate 补全的拒答数据进行训练,使目标域拒答率从 9.47% 升至 84.75%,并在三个更广泛的有害性基准上使平均不安全回复率从 26.26% 降至 0.14%,但 XSTest 上的过度拒答从 2.00% 升至 74.00%。 在另一组对照实验中,用经验证的目标模型回复替代外部回复,将过度拒答从 15.20% 降至 5.20%。边界对数据 在保留的边界对上面将服从侧过度拒答从 32.94% 降至 4.16%,而有害侧拒答仅从 91.88% 微降至 87.72%。这些结果表明,数据构成控制着安全性与可用性的权衡,安全对齐应在预期拒答边界的两侧进行评估。
论文精读
TL;DR 提出窄边界安全对齐:用自生成拒绝轨迹与边界对数据,在政治说服话题上将目标拒绝率从9.47%提至84.75%,并把过度拒绝从74%降至5.2%,实现LLM安全边界的精准控制。
问题
当前 LLM 安全对齐 主要围绕主题级有害性判断:模型学习在遇到特定话题(如政治、医疗)时整体拒绝或回答。但实际部署往往需要更细粒度的窄边界拒绝:同一话题下,不同应用需要拒绝与回答的边界不同。例如,一个 civics tutor 与一个 public-sector assistant 可能基于同一基座模型,却需要对同一选举话题设定不同的拒绝边界。
现有方法的局限主要体现在两方面。一是数据构建的粗糙性:使用通用有害数据或外部模型生成的拒绝样本,容易导致过拒绝(over-refusal)或有害响应残留,无法精确控制在边界两侧的行为。二是训练目标的单一性:仅优化拒绝率或仅优化可用性,无法同时校准边界。本文实验显示,单次自生成留下 19.88% 的提示无法获得可靠拒绝轨迹,而直接使用外部响应会使过拒绝率从 15.20% 上升;使用边界对数据虽能大幅降低 comply-side 过拒绝,但 harmful-side 拒绝率略有下降,说明需要专门的数据配比策略。
为什么难:安全边界本身是主观且上下文相关的,不同利益相关方对“有害”的定义不同;要训练模型在狭窄边界上精确拒绝,需要同时提供边界两侧的高质量监督,而这很难通过人工标注扩展。此外,评测必须同时报告目标域拒绝率与泛化过拒绝率,单一指标会掩盖 trade-off。业界关注点正在从“是否安全”转向“对谁安全、在什么条件下安全”,这使得窄边界安全成为可落地的关键挑战。
类比:类似内容审核系统需要区分政治宣传与事实报道,精准拦截操纵性内容而不屏蔽普通讨论。
核心洞察
- 窄边界安全是对主题级安全对齐的必要补充,更贴近真实部署中同一主题内差异化的拒绝需求。现有安全对齐通常将整个主题标记为安全或不安全,导致无法区分同一主题下的合法查询与滥用场景(如政治话题中拒绝操纵但回答事实问题)。论文通过自生成受控主题和边界对数据,实现了边界感知的训练与评估,与仅做主题分类或依赖人类反馈的 baseline 有本质差异,为从业者提供了可落地的细粒度控制思路。
- 自生成数据的覆盖率与质量直接决定安全-可用性权衡,递增重试(Escalate)显著优于单次生成。论文显示单次生成遗留 19.88% 无拒绝轨迹的提示,而 Escalate 将缺失率降至 0.20%,有效解决了分布外拒绝监督不足的问题。相比以往采用外部模型响应或一次性合成的做法,该工作通过验证目标模型响应和补偿数据,在保持目标域拒绝提升的同时将过度拒绝从 15.20% 降低到 5.20%,证明数据组成是可调节的工程杠杆。
- 安全评估必须同时在拒绝边界两侧进行,过度拒绝与有害响应同样关键。传统基准主要衡量有害输入是否被拒绝,但论文引入 XSTest 和边界对评估,揭示单纯提高目标域拒绝率会导致过度拒绝从 2.00% 飙升至 74.00%;而边界对数据可将遵守侧过度拒绝从 32.94% 降至 4.16% 且有害侧拒绝仅小幅下降,为安全对齐提供了更全面的评估框架,避免单边优化带来的可用性代价。
方法
输入与目标
输入为基座模型(如 Qwen3-8B)和用户定义的 窄边界安全主题,例如政治劝导中仅针对“针对性操控”的子话题,而非整个政治领域。
关键模块
- 受控主题生成:采用 层级化主题生成 构造细分话题树,将安全边界映射到具体 prompt 分布。
- 覆盖修复:初始单次拒绝轨迹生成会留下 19.88% 的未覆盖 prompt。通过 Escalate(逐步升级重试直到产生有效拒绝)和 Graft(嫁接相近已覆盖样本)将缺口降至 0.20%。
- 补偿数据构造:生成 表面危险但真实安全的 benign 提示 与 FakeHarm 合成有害样本,用于抑制过度拒绝;同时构建 有害-良性边界对,同一话题两侧各取一个样本,训练模型区分边界。
- 损失路由:对不同的数据组件(拒绝轨迹、正常响应、边界对)分配不同损失权重或掩码,平衡安全性与可用性。
输出
输出经 自蒸馏 微调后的模型,能够对窄边界内的特定子话题稳定拒绝,同时对边界外的相邻话题正常回答。
核心思路:数据组成直接决定安全与过度拒绝的权衡,而非仅靠增加安全数据。
与同类方法的差异
区别于依赖外部模型生成响应或仅做主题级安全对齐,该方法完全离线自生成监督信号,并通过 边界对与补偿数据 在局部边界上做精确校准。
实验
实验设计
论文在 Qwen3-8B 上以政治说服为主题构造窄边界安全任务,采用自生成拒绝数据,包含 controlled topic generation、coverage repair(Graft / Escalate / Escalate+Graft)、in-distribution compensation data、harmful-benign boundary pairs。训练采用 loss routing 区分不同类型的监督样本。评估覆盖目标域拒绝率、三个通用有害性基准、XSTest 过度拒绝,以及 OOD 边界对。
关键发现
- 单次生成留有 19.88% 提示无可用拒绝痕迹,Escalate 重试将未覆盖降至 0.20%。
- 在政治说服任务上,使用 Escalate 完成拒绝数据训练后,目标域拒绝率从 9.47% 提升至 84.75%;三个有害性基准的平均不安全响应率从 26.26% 降至 0.14%;然而 XSTest 过度拒绝从 2.00% 升至 74.00%。
- 将外部响应替换为验证过的目标模型响应后,过度拒绝从 15.20% 降至 5.20%。
- 边界对数据将留出集的合规侧过度拒绝从 32.94% 降至 4.16%,而有害侧拒绝仅从 91.88% 微降至 87.72%。
与基线对比解读
基线为未经窄边界训练的原始 Qwen3-8B 模型。实验表明,数据覆盖度(Escalate)大幅提升目标域拒绝能力,但代价是明显提高过度拒绝。通过补偿数据(替换为验证响应)和边界对数据,能够在保持高安全性的同时显著降低过度拒绝,证明数据组成直接控制安全性与可用性的权衡。对于工程实践,应同时评估拒绝边界的双侧指标,而不是仅看单一有害性分数。
行业影响
落地场景
论文提出的 窄边界安全(narrow-boundary safety)适合需要定制安全策略的 AI 助理。同一话题下,不同业务需要不同拒绝边界:例如教育辅导助手可能拒绝政治竞选操控建议,但回答事实性选举知识;企业服务助手可拒绝内部舞弊指导,但正常回答合规流程。具体用例如:
- 电商智能客服:识别并拒绝恶意退款欺诈教程,同时正常处理退换货咨询。
- 金融顾问助手:拒绝市场操纵方案,但正常回答投资基础知识。
- 内容平台审核:精准过滤仇恨言论,但保留合理的批评内容。
这些场景都要求模型“在边界处精准拦停”,而非全拒或全放。
商业价值
该框架直接降低安全对齐的边际成本与用户体验损耗。通过 自生成拒绝数据 与 Escalate 重试机制,将无有效拒绝轨迹的提示从 19.88% 降至 0.20%,大幅减少人工补标成本。边界对训练将目标领域拒绝率从 9.47% 提升至 84.75%,同时配合补偿数据与自生成响应,将过度拒绝从 74.00% 降至 5.20%(XSTest 及相关匹配实验)。这意味着模型既能合规拦截风险,又不会因过度拒绝导致可用性下降,从而提升客户留存与 NPS。定制化安全策略可成为 B2B 模型服务的差异化卖点,为不同行业客户提供专属的拒绝边界。
集成方式
该方法是离线数据合成 + 有监督微调,可直接嵌入现有 LLM 后训练流水线:
- 数据层:利用现有基础模型自生成多样化的有害/无害边界对,结合
Escalate与Graft提高覆盖率和真实性。 - 训练层:将生成数据按
loss routing混入现有 SFT/DPO 数据集,按需调整 补偿数据 比例以控制过度拒绝。 - 评估层:在标准安全评估集之外,新增 held-out boundary pairs 来测试边界两侧的精度,替代单一有害率指标。
该方法与现有护栏(guardrails)模块互补:模型内部对齐负责泛化边界,外部护栏负责硬性规则兜底。多租户模型平台可将不同边界配置作为“安全配置文件”交付。
局限
- 论文构建的窄边界安全数据仅覆盖政治劝说和宗教两个主题,且生成依赖 Qwen3-8B 自身与外部 guard model。其他高风险领域(如医疗、法律、金融)的边界形态差异较大,方法的跨主题迁移能力未经验证。自生成数据可能继承基座模型的隐性偏向,即便通过验证过滤,仍可能遗漏某些 subtle harmful patterns,导致训练后的边界在未见话题上不稳定。
- 实验结果中,加入 Escalate 后目标域拒绝率提升至 84.75%,但 XSTest 过度拒绝从 2.00% 飙升至 74.00%。虽然边界对数据可将该指标降至 5.20%,但需要额外构造 compensation data 并精心配比,实际部署时安全与可用性的权衡曲线高度依赖数据组成,缺乏一个统一的自动调节机制。不同应用场景对过度拒绝的容忍度不同,如何低成本校准仍是开放问题。
- 所有训练与评估均围绕 Qwen3-8B 单模型展开,未在更多模型规模或架构上进行验证。离线自生成的流水线涉及多个超参(重试次数、graft 策略、过滤阈值等),这些参数对最终边界精度的敏感性没有系统消融。此外,论文未与在线 RLHF 或 DPO 等直接优化边界的方法进行端到端对比,难以判断自蒸馏方案在样本效率与最终性能上是否具备实际优势。