JEPA-Anything: 跨不同世界学习预测模型
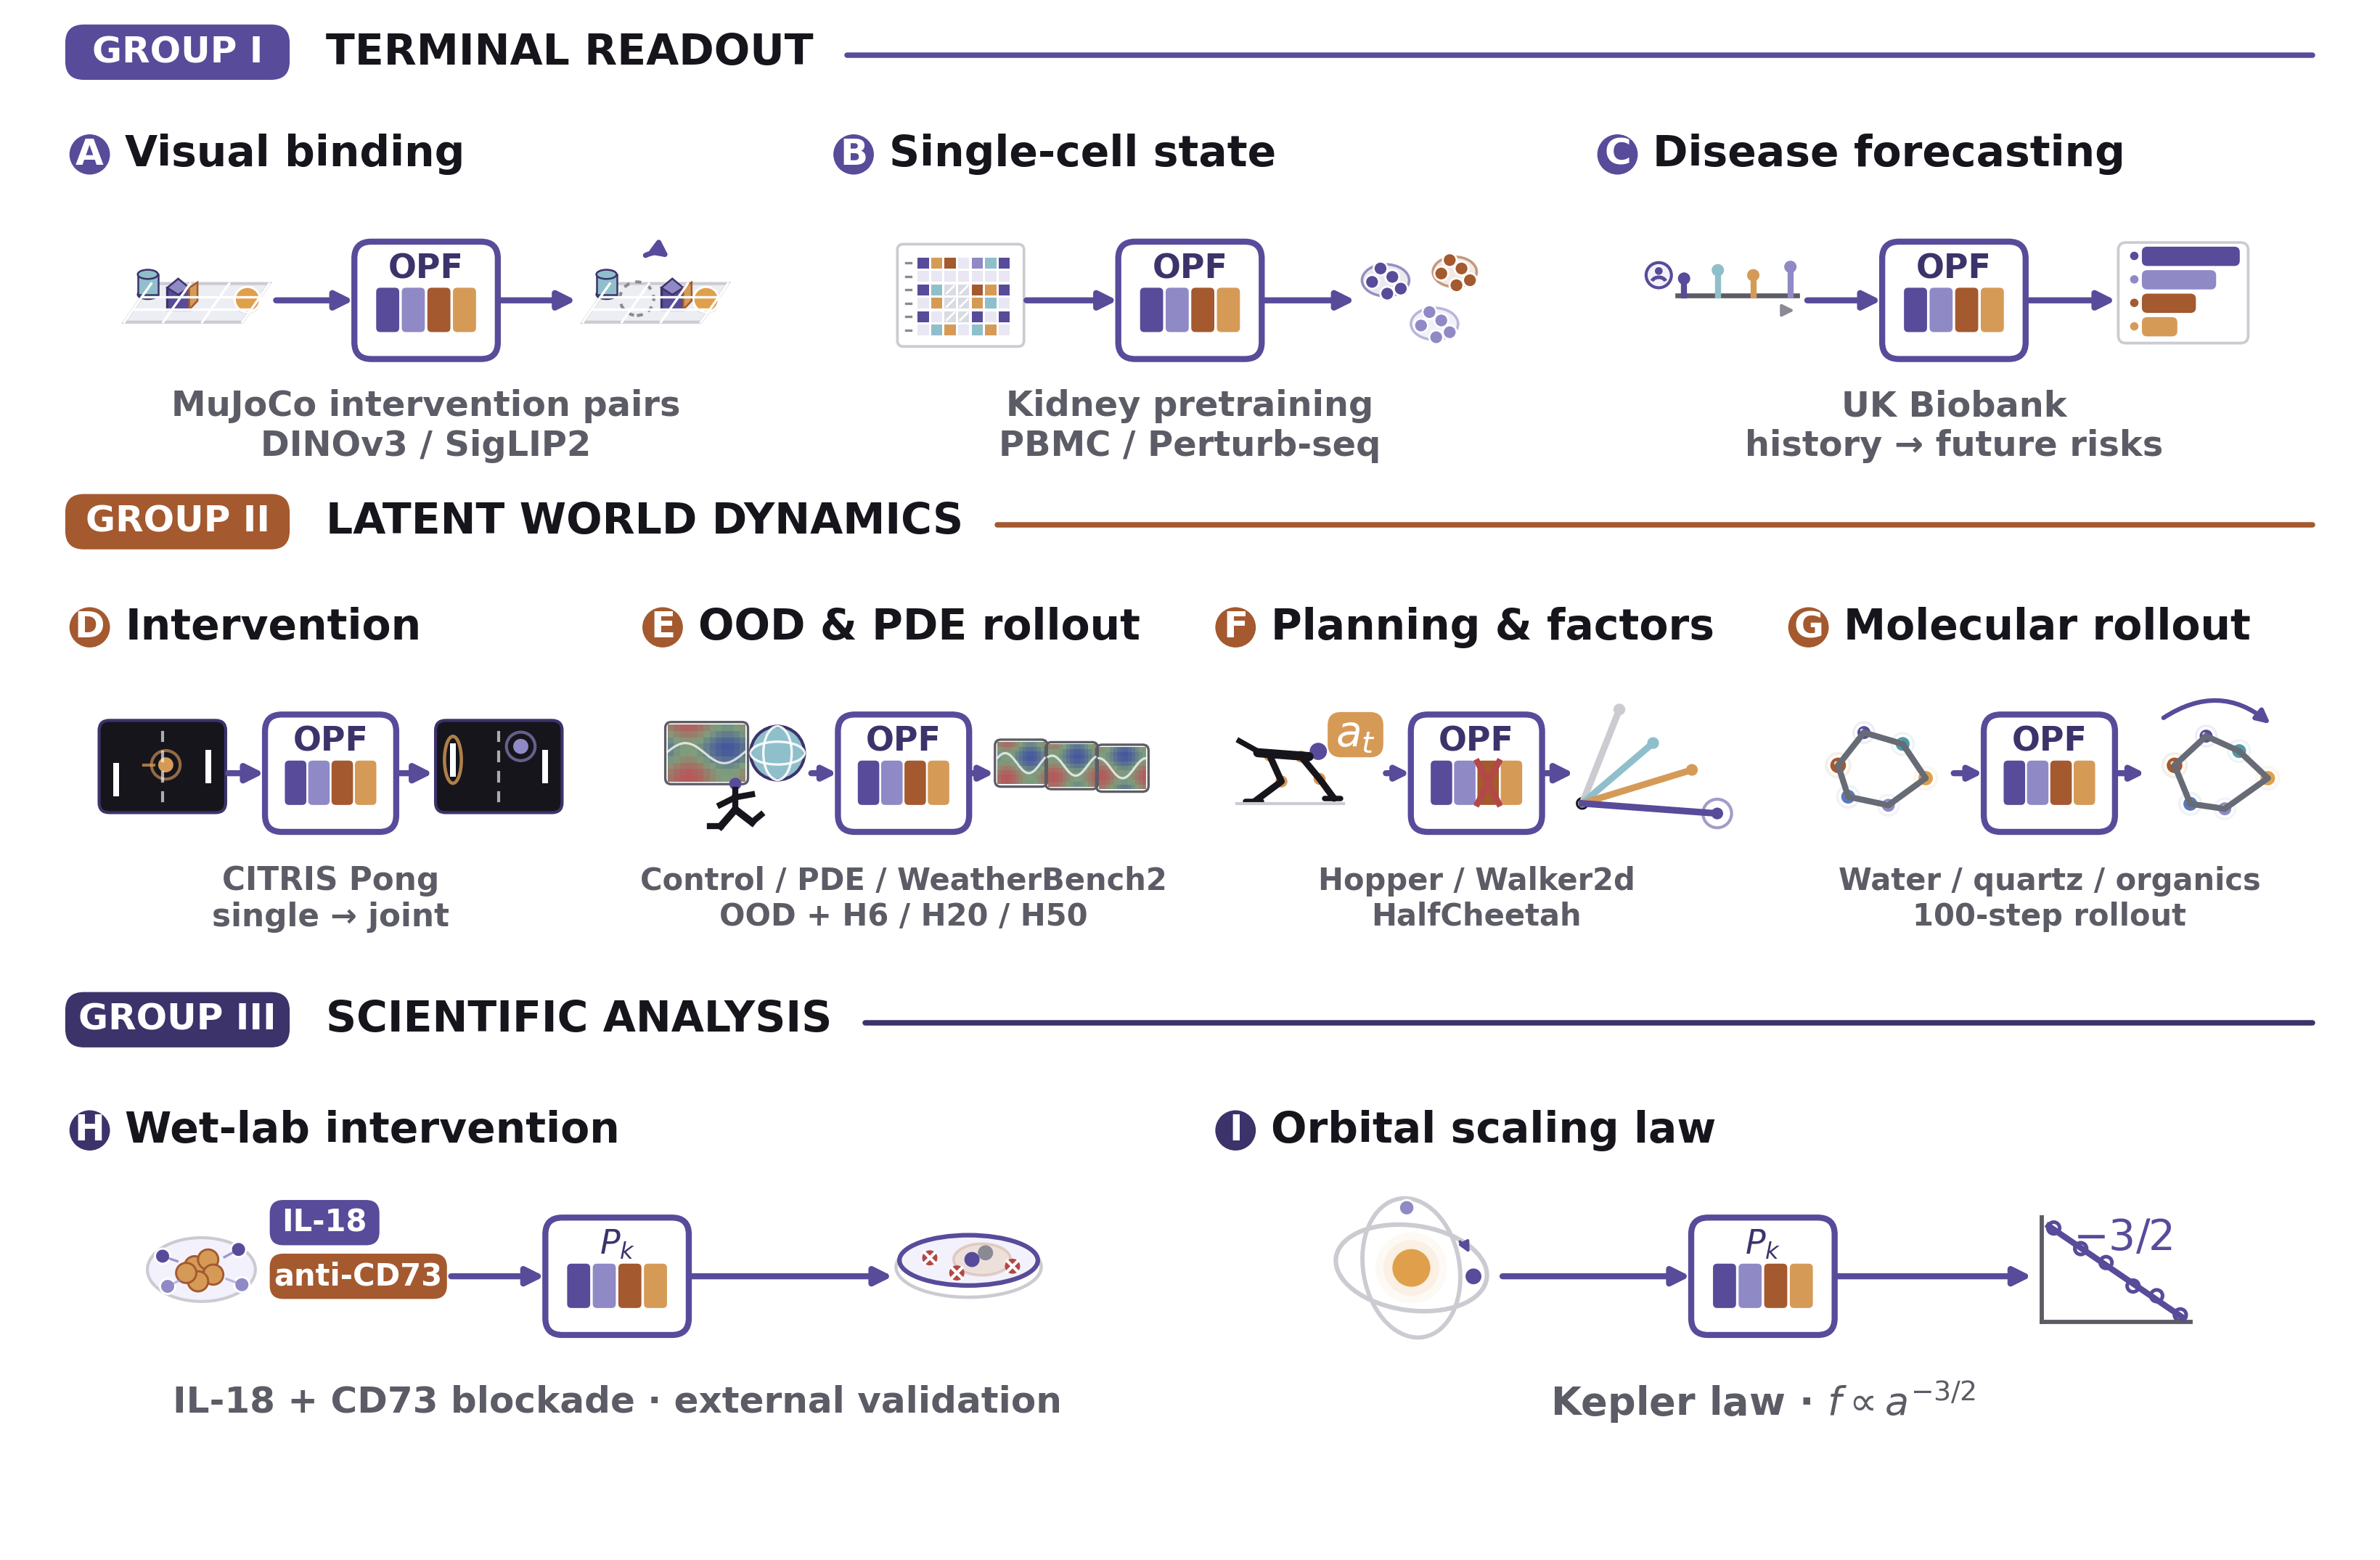
世界建模让智能体能够预判后果、指导干预并从交互中学习。然而预测模型仍局限于单一领域:是否存在一种通用的学习原则,能够支撑跨越截然不同系统的世界建模? 我们提出 JEPA-Anything,一个基于正交预测分解(OPF)的领域无关框架。OPF 扩展了 joint-embedding predictive architectures,将潜目标分解为互补因子,通过专门的通路分别学习,再在共享的预测设计中重新组合。 我们在七个领域评估 JEPA-Anything:视觉、生物学、临床轨迹、控制、分子动力学、物理场与天气。实验覆盖表征学习、干预预测、分布外泛化与长时程动力学,包括 10 个匹配的动力学任务、超过 1,000 个临床事件预测,以及四个系统上的 100 步分子 rollout。与匹配的 JEPA baselines 相比,JEPA-Anything 在全部 10 个动力学任务上提升报告指标,并将 Interventional Pong 的单次干预预测误差降低 34.8%;在四个系统中均取得最低的一步与 100 步分子误差。 超越预测本身,一个由因子提名得到的生物干预在细胞共培养、患者来源类器官、肿瘤碎片和小鼠中获得实验支持;latent orbital modes 恢复了 Keplerian scaling exponent,拟合斜率为 -1.4991。这些结果支持一种跨异构世界的共同因子化预测原则,将世界建模与干预及有实验支撑的科学发现联系起来。代码:https://github.com/Gen-Verse/JEPA-Anything
论文精读
TL;DR 域无关框架 JEPA-Anything 通过正交预测分解统一七类系统的世界建模,在动态预测、干预推断与长时程 rollout 上全面超越匹配基线。
问题
问题背景
世界模型是 AI 智能体进行预测、规划和因果推理的核心组件。当前研究聚焦于如何跨视觉、物理、生物、临床等异质系统学习可泛化的预测表示。
现有方法局限
传统 JEPA 类方法通常针对单一领域设计,缺乏跨域通用的因子分解机制。例如,I-JEPA 等模型在图像表示学习中表现良好,但其潜在目标常为整体嵌入,未显式分离互补因子,导致表示纠缠、冗余和坍缩风险。预测模型难以从视觉迁移到分子动力学或临床轨迹;干预预测需要结构化因子,但现有方法缺少正交约束,无法稳定控制不同因子的贡献。此外,多数世界模型依赖重建或对比目标,无法直接适配连续物理场、稀疏事件序列等非图像模态。
为什么这个问题难/重要
不同世界的动态系统在模态、时间尺度、干预方式上差异巨大。视觉是静态高维,分子是连续物理场,临床是稀疏事件序列。一个通用预测核心若能分解潜在目标为互补因子,并通过专用路径学习再重组,将大幅降低多领域建模成本。更进一步,干预和科学发现需要可解释因子,这不仅是预测精度问题,也是从表示中提取因果结构的挑战。业界关注通用世界模型能否突破单一领域限制,赋能机器人、药物发现、气候模拟等应用。
行业类比
这类似于构建一个可同时处理图像补全、分子轨迹和临床事件预测的多模态基础世界模型,需要统一的因子化预测内核,类似 Transformer 在不同任务间的共享架构。
核心洞察
- JEPA-Anything 的核心洞察是正交预测分解(OPF)提供了一种领域无关的世界建模原语。它将潜在目标分解为互补因子,经专用路径学习后重组,这不同于传统 JEPA 的单一路径预测,有效避免了表示坍缩,并在跨领域(视觉、生物、临床、控制、分子、物理场、天气)的 10 个动态任务上全部超越匹配的 JEPA 基线,表明分解式预测可作为通用世界模型的基础构件。
- OPF 的独特价值在于将预测因子直接对接干预与科学发现,而非仅止步于状态预测。因子提名干预在湿实验中(细胞共培养、患者衍生类器官、肿瘤片段、小鼠)获得验证,且潜在轨道模式以拟合斜率 -1.4991 复现开普勒幂律,这在 latent world models 中罕见。与仅关注下一状态预测的 baseline 相比,OPF 将因子作为可操作单元,使世界模型成为因果推断和实验设计的接口。
方法
方法核心:正交预测分解(OPF)
输入:任意模态的观测序列或状态,如视觉帧、单细胞表达谱、临床时序、控制信号、分子构象等。
关键模块:JEPA-Anything 将 joint-embedding predictive architecture (JEPA) 扩展为 正交预测分解 (Orthogonal Predictive Factorization, OPF)。
- 统一接口与预测核心:所有领域共享同一输入编码接口和预测主干,目标潜在表示被分解为多个互补的正交因子,避免信息冗余。
- 专用通路与重组:每个因子通过专用通路独立学习,再在共享预测设计内重组,形成完整的预测目标表示。
- 因子与编码器活跃性维护:通过正则化或架构约束防止潜在因子坍缩、编码器输出退化,保持各因子持续活跃且相互正交。
- 共享预训练与任务特定读出:基于共享预测目标预训练后,下游任务通过独立 readout 从学习到的世界状态中提取信息,不改变预测核心。
输出:可复用的预测世界状态,支持终端读出(分类/回归)、潜在动态 rollout、干预预测和科学发现。
与同类 JEPA 变体相比,OPF 强制潜在目标的正交分解,而非单一潜在表示或启发式解耦,从而在异构世界建模中统一干预预测、长期动态与可解释因子提取。
实验
实验设计
JEPA-Anything 在七个领域(视觉、生物、临床轨迹、控制、分子动力学、物理场、天气)进行评测,采用统一接口与共享预测核心。实验分三组:终端读出预测状态、潜在动态与 rollout 稳定性、科学分析。涵盖 10 个匹配动力学任务、超过 1,000 个临床事件预测、四个系统的 100 步分子 rollout,以及 Interventional Pong 干预条件组合预测和 Burgers 方程长时 rollout。
关键发现
- 在全部 10 个动力学任务上,相对匹配 JEPA 基线提升所有汇报指标。
- Interventional Pong 单干预预测误差降低 34.8%。
- 四个分子系统上,1-step 与 100-step 误差均为比较方法中最低。
- 因子提名的生物干预在细胞共培养、类器官、肿瘤片段、小鼠模型中获得实验支持。
- 潜在轨道模式恢复开普勒标度指数,拟合斜率 -1.4991,与理论值 -1.5 高度一致。
基线对比深度解读
相比容量匹配的 JEPA 基线,OPF 通过 正交预测因式分解(orthogonal predictive factorization)将潜在目标分解为互补因子并走专用路径,避免因子混淆与坍缩,从而在干预预测和长时 rollout 中更稳定。分子 100 步低误差表明因子分解缓解了误差累积。科学发现方面,潜在因子呈现物理可解释性(开普勒定律),说明该框架不仅是预测工具,还可作为假设生成器。整体上,改进来源于结构化先验而非更多参数,体现出跨领域世界建模的通用性原则。
行业影响
落地场景
JEPA-Anything 的 正交预测分解 (OPF) 提供领域无关的世界模型构建方式,适合需要跨域预测与干预建模的产品:
- 自动驾驶:利用其长时程动力学能力,预测交通参与者未来轨迹,支撑规划器训练与仿真。
- 药物发现:分子动力学 100 步 rollout 的低误差特性,可加速候选分子稳定性筛选。
- 临床决策支持:对超过 1000 个临床事件的纵向预测,辅助疾病进展模拟与治疗方案比较。
- 智能推荐/内容平台:建模用户行为在干预(如推荐策略变化)下的响应,优化收益。
商业价值
核心价值在于 降低多领域预测模型的开发与维护成本:共享预测核心减少重复建模,因子化设计提升预测精度与长时程稳定性(10 个动力学任务全部提升,Interventional Pong 干预误差降低 34.8%)。在药物发现和临床场景,因子提名干预可减少湿实验或 A/B 测试次数,直接降本;在自动驾驶和推荐系统,更准确的长期预测可提升安全性与用户留存,带来增收。
与现有工作流的接口
JEPA-Anything 可作为 预训练世界模型模块 嵌入现有 ML stack:
- 输入多模态序列(视觉、时间序列、图),输出因子化潜在状态。
- 通过任务特定 readout 接入下游预测、规划或控制头。
- 与现有 JEPA 变体(如 I-JEPA、V-JEPA)兼容,后端可替换为 Transformer 或 Mamba。
- 导出 ONNX/TorchScript 便于服务化部署,或作为特征提取器接入特征平台。
具体用例:在电商平台,利用 JEPA-Anything 对用户点击序列进行干预条件预测,模拟不同排序策略下的长期留存,减少在线实验成本;在医疗 SaaS 中,预测患者疾病轨迹并推荐干预措施,辅助医生决策。
局限
- - **局限 1:因子设计与正交先验依赖人工设定。** OPF 要求为每个领域手动指定因子数量、正交系数和通路结构,这限制了完全 domain-agnostic 的自动迁移。例如在生物学和临床轨迹中,因子数目需要根据领域知识调整,缺乏端到端的学习机制。与 DreamerV3 等 latent world model 相比,后者通过统一 latent dynamics 自动学习状态分解,JEPA-Anything 的因子分解可能加重对任务先验的依赖,增加调参成本,尤其在缺乏明确因子语义的新领域,正交约束可能强制不相干维度解耦,反而损失表示容量。
- - **局限 2:实验规模与 baseline 覆盖有限。** 虽然跨 7 个领域,但每个领域仅选择少量匹配的 JEPA baseline,未与更广泛的生成式世界模型(如 IRIS、Genie)或扩散预测模型对比。分子动力学仅覆盖 4 个系统,临床事件预测未说明是否处理缺失值、不规则采样等真实医疗数据问题。此外,代码仓库 star 数仅 19,社区验证不足,难以评估框架在大规模预训练和产业级部署中的稳定性与可扩展性。
- - **局限 3:训练稳定性和计算开销未量化。** 保持因子和编码器活动的机制(如 whitening 或 variance regularization)需要额外的前向 / 反向计算,但论文未报告训练时间、显存占用量,也未讨论长序列 rollout 下的误差累积(尽管他们在分子 100 步上评估,但未分析发散模式)。与标准 JEPA 相比,OPF 的多通路设计可能带来三倍以上参数增加,这对资源受限场景不友好,限制其在边缘设备或在线学习中的应用。