RiskChainBench:面向混淆平台消息还原与证据支撑网页调查的基准
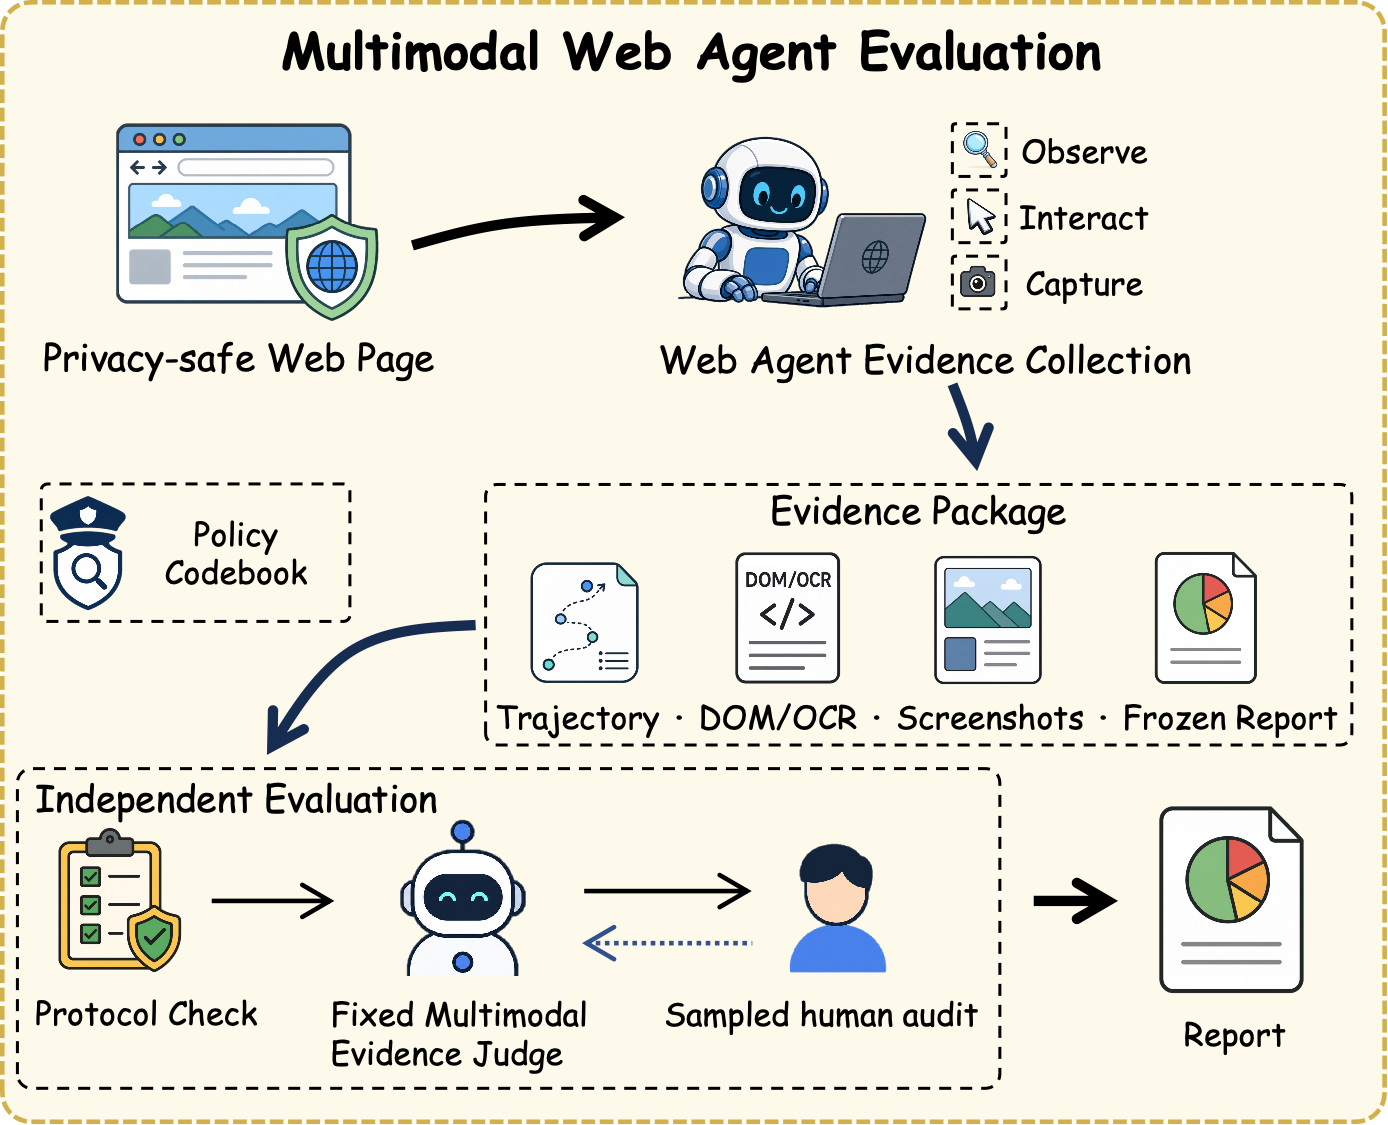
平台滥用 活动利用 emoji、同音字、字符拆分与冗余符号隐藏跳转指令,再通过伪装链接把用户引向色情、欺诈、赌博或非法交易相关服务。现有基准将混淆文本与风险网页分开评估,掩盖了目标还原如何影响下游证据获取。 我们提出 RiskChainBench,把来自 600 个源会话的 3,600 条合成 token-text 还原输入,与 600 个对应的人工标注本地网页环境配对。模型首先还原消息、操作意图与目的地;随后同一底层模型充当 VLM 驱动的网页智能体,调查正确关联的网站,并在不使用消息侧语义或域名信誉线索的条件下,生成一份冻结的、引用证据的风险报告。 评估分两路:分别对还原与正确路由的网页调查打分,再以冻结的 primary-entry 预测作为门控,离线叠加到同一 Task 2 结果上。人类标注判定任务正确性,固定的 多模态证据评判器 评估忠实性、充分性、完整性与一致性。 在十个模型中,Entry Top-1 介于 35.2% 与 95.2% 之间,网页决策准确率介于 26.3% 与 62.8% 之间;领先系统在入口还原、完整重建、网站决策与细粒度分类上各不相同。执行失败占网页运行的 31.9%,而决策后的类型错误仅占 0.9%,说明稳定的探索与风险判断是主要瓶颈。我们发布该基准、协议以及可重置的本地沙箱。
论文精读
TL;DR RiskChainBench 首次将混淆消息恢复与证据驱动的网页调查配对,端到端评估模型从识别被 emoji 或谐音伪装的跳转消息,到在本地网站取证并生成风险报告的能力;十模型测试显示执行失败是主要瓶颈。
问题
问题背景:平台滥用活动日益隐蔽,攻击者利用 emoji、同音字、字符分解、冗余符号混淆重定向信息,将用户引向色情、欺诈、赌博等高风险服务。AI 安全与内容审核领域亟需自动恢复这些指令并开展基于证据的网络调查。
现有方法局限:现有基准将混淆文本理解和危险网页评估视为独立任务,仅评估单点能力,割裂了“从消息恢复到证据获取”的完整链路。纯文本基准不涉及视觉与交互,模型可能依赖表面模式而非真正推理;网页端评估则常借助域名信誉等捷径,未要求模型在隔离环境中仅凭页面内容做出风险判断。因此,无法诊断上游恢复错误对下游取证的影响,也难以定位真实瓶颈。
为什么这个问题难/重要:混淆文本形态多变且跨模态,需要组合字符级、语音、视觉等多重线索;危险网页的动态交互与陷阱要求 VLM 代理稳定探索并做出准确风险判定,执行失败率高达 31.9%,说明工程落地远非单纯文本理解。对行业而言,自动化的滥用检测、网络犯罪调查和威胁情报系统都依赖此类端到端能力,现有评估缺口直接阻碍模型迭代与部署决策。
行业类比:类似于构建一个自动化安全分析师,从可疑聊天记录中还原真实意图,再实地访问目标网站取证并输出有引用依据的风险报告,服务于内容安全与反欺诈流水线。
核心洞察
- 端到端门控组合评估量化了上游混淆文本恢复误差对下游网页证据获取的级联影响,而现有基准将两者孤立评估,掩盖了流水线中的误差放大效应。RiskChainBench 通过将 Task1 冻结的 primary-entry 预测作为门控直接应用于同一 Task2 结果,无需重复运行 Web agent 即可计算端到端损失。这揭示了即使文本恢复 Top-1 较高,细粒度路由错误仍会显著拉低整体性能。工程上应在上游恢复模块中引入置信度阈值与回退机制,避免将高不确定性的推断直接送入下游高风险决策环节。
- 执行失败贡献了 31.9% 的 Web run 失败,而决策后类型错误仅占 0.9%,表明当前 VLM 驱动的 Web agent 的主要瓶颈在于稳定探索与交互工程,而非风险判断能力本身。与多数工作聚焦提升模型推理精度不同,该基准的诊断分析指出浏览器自动化中的页面加载、元素定位、状态管理等工程缺陷更值得投入。这为实际滥用检测系统的构建提供了明确优先级:先夯实可重试、可恢复的 agent 执行框架,再考虑升级判断模型,否则更强的判断力也会被不稳定的执行层消耗殆尽。
方法
输入与任务定义
RiskChainBench 的输入为 3,600 条合成混淆消息(来自 600 个源会话),每条消息通过 emoji、同音词、字符分解和冗余符号隐藏真实指令。每个会话还对应一个本地网页环境,该环境已人工标注金标,包含风险类别(色情、欺诈、赌博、非法交易等)。模型需要完成两个串联任务:先恢复消息,再进行网页调查。
关键模块
- 混淆消息恢复:模型接收混淆文本,输出三条规范化信息:原始消息、操作意图和目的地(primary-entry)。评估独立进行,使用 Entry Top-1、完整重建精度等指标。
- 证据引导的网页调查:同一个底层模型作为 VLM 驱动的 web agent,进入恢复出的目标网站(或离线门控指定的网站),通过多步探索收集页面证据,最终生成一份冻结的、带引用的风险报告。该报告不依赖消息侧语义或域名声誉线索。
- 离线门控组合:将 Task 1 的 primary-entry 预测作为硬门控,如果入口网址预测错误,端到端结果直接判为失败;如果正确,则沿用 Task 2 的网页调查报告结果。这种设计将恢复准确性与下游调查能力解耦并组合。
输出与评估
模型输出包括恢复的消息、意图、目的地,以及证据引用的风险报告。任务正确性由人工标签判定,同时一个固定的多模态证据评判器对报告的 faithfulness、sufficiency、completeness、consistency 四维打分。诊断分析显示,执行失败占 31.9%,而决策后类型错误仅 0.9%,说明稳定探索和风险判断是主要瓶颈,而非细粒度分类能力。
与现有基准把混淆文本和风险网页分开评估不同,RiskChainBench 将两者显式链接,并通过离线门控量化目标恢复对下游证据获取的实际影响。
实验
实验设计
RiskChainBench 构建了 3,600 个合成 token-text 复原输入(来自 600 个 source sessions),并配对 600 个人工标注的本地 web 环境。评估分为两个独立任务:消息复原(恢复消息、操作意图、目的地)与证据引导的 web 调查(同一 VLM 驱动 agent 调查正确网站,生成引证报告)。离线合成阶段将冻结的 primary-entry 预测作为 gate 应用到 Task 2 结果,人工标签决定任务正确性,多模态证据 judge 评估忠实度、充分性、完整性与一致性。
关键发现
在 10 个模型中,Entry Top-1 范围为 35.2%–95.2%,Web decision accuracy 范围为 26.3%–62.8%。领先系统在 entry 恢复、完整重建、网站决策和细粒度类型上各不相同。执行失败占 web runs 的 31.9%,而决策后类型错误仅占 0.9%,表明稳定探索和风险判断是主要瓶颈。
对比解读
与分别评估混淆文本和风险网页的既有基准不同,RiskChainBench 通过配对与 gate 机制显式建模目标恢复对证据获取的影响。高 entry recovery 并不保证高 web decision accuracy,说明模型能力在不同阶段不均衡。执行失败远高于语义错误,提示工程实践中需优先优化 agent 的交互稳定性与探索鲁棒性,而非仅关注语义理解。
行业影响
落地场景
RiskChainBench 直接面向对抗性混淆文本与下游网页取证场景,适用于内容安全与反欺诈产品线:
- 电商平台:商品描述或评论中通过 emoji、同音字隐藏违禁品跳转链接,模型恢复原始意图并自动访问落地页,生成带证据的风险报告。
- 社交/内容平台:私信或评论区伪装成正常内容的赌博、色情引流信息,需跨消息和网页追踪证据,辅助精准封禁。
- 金融反钓鱼:识别短信/邮件中被字符分解或冗余符号混淆的 URL,恢复真实目标并自动判定欺诈属性。
商业价值
该基准的价值主要集中在降本和风险控制两条线:
- 降低人工审核成本:自动化消息恢复与网页调查替代人工逐条排查,高风险案例的筛选效率可提升数倍。
- 减少合规与品牌风险:证据引用式报告降低误报和漏报,避免平台因违规内容受罚或用户流失。
- 指导模型选型与调优:Entry Top-1、web decision accuracy 等指标便于比较不同 VLM/Agent 系统,诊断执行失败(31.9%)与风险判断瓶颈,推动针对性优化。
与现有工作流集成
RiskChainBench 可作为一种评测与训练基础设施嵌入现有安全技术栈:
- 作为内容审核 pipeline 的前置模块:将消息恢复结果(操作意图、目的地)输入规则引擎或下游风控模型。
- 对接 SOAR / 安全编排平台:web agent 调查环节封装为可调用取证函数,自动抓取网页证据并生成结构化报告。
- 利用本地可重置沙盒进行回归测试与红队演练,避免真实网络风险;其“冻结主入口预测作为 gate”的离线组合设计,可复用于多阶段推理系统的质量门禁。
局限
- **合成数据与受控环境存在泛化差距**:RiskChainBench 使用 synthetic token-text 和 controlled local web environments,难以完全覆盖真实平台滥用中动态演化的混淆手段(如上下文依赖的表情符组合、多级跳转、对抗性更新)及真实网页的反爬虫与动态渲染特性。模型在本地沙盒上的稳定表现可能高估其实际风险处置能力,评测结果向真实流量的迁移需要额外验证。
- **门控式端到端评估可能低估模型实际能力**:协议将 Task 1 的 Top-1 预测作为硬门控,仅对正确路由的案例计算端到端得分,忽略了模型在部分恢复或不确定场景下调整探索策略的可能。这种离线组合方式与真实 web agent 的在线决策过程存在差距,不能充分反映模型在错误恢复后的自适应纠错能力。
- **证据评判器的可靠性未充分验证**:固定 multimodal evidence judge 虽避免了消息侧语义泄漏,但其本身可能存在偏差或校准问题,论文未报告评判器与人类标注的一致性水平。同时,“充分性”“完整性”等维度主观性较强,不同模型生成报告的分数差异可能部分源于评判器偏好,而非模型能力真实差异。