Mind2Dialogue:通过模拟用户心理状态训练人类感知语言模型
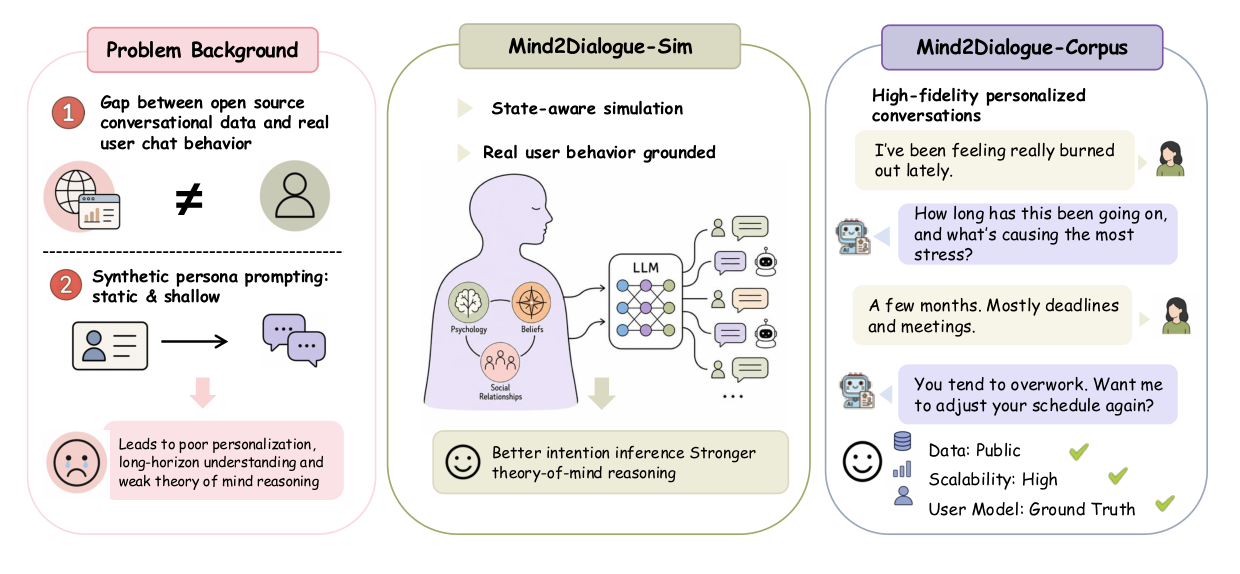
随着语言模型能力增强,学习、推理与决策中的长期协作要求它们更深入地理解所服务的人。但训练人类感知语言模型 面临根本性的监督缺口:现有 LLM 助手训练数据几乎不包含明确基于用户未言明信念与目标的知情回复,而用户的潜在状态又无法直接观测,这类监督难以规模化。 为此,作者提出 Mind2Dialogue 框架。首先构建心理学引导的模拟器,在保持个人特征的同时通过交互更新心理状态以生成连贯对话,其核心是维护一个共享、演化的心理状态,既驱动用户行为,也引导 Oracle 助手的回复;随后通过特权蒸馏,让模型学习 Oracle 的知情回复,从而在部署时无需直接访问用户心理状态也能提供辅助。 评估方面,该工作结合个性化 与心理理论(theory of mind),考察模型如何理解人并据此行动。在完整 Mind2Dialogue 语料上训练后,所有报告的个性化指标均优于对应的 Qwen、Llama、OLMo 指令微调基线,偏好遵循生成提升 26.6–40.9 个百分点;在 Qwen 与 Llama 上,增益还延伸到信念与行动推理。 展望未来,Mind2Dialogue 让用户模拟成为真正 AI 协作者的基础——理解人们言语背后的信念与意图,并支持其在教育、工作与日常生活中的长期目标。
论文精读
TL;DR Mind2Dialogue 通过模拟用户共享心理状态生成特权监督,训练语言模型不直接访问用户内心也能按信念与目标回应,偏好跟随生成提升 26.6–40.9 个百分点。
问题
问题背景
大模型助手正从单轮指令执行走向长期协作,业界开始关注模型对用户内在信念、目标等心理状态的建模能力,即human-aware 或 theory of mind。
现有方法局限
当前 LLM 助手训练语料主要由通用指令、偏好数据构成,回复大多只基于用户字面表达,缺乏对未言明内心状态的显式利用。已有的个性化工作要么依赖静态 persona 描述,要么使用历史对话归纳偏好,但无法跟踪交互中动态变化的心理状态;Theory of Mind 基准(如 ToMi)通常只做离线推断题,不直接优化对话策略。更根本的是,用户内在状态在真实数据中不可观测,人工标注成本高且主观性强,导致监督信号长期稀缺,难以规模化构建训练数据。
为什么难/重要
核心挑战在于监督鸿沟:训练时可访问用户心理状态(作为 privileged information),但部署时模型只能看到用户话语,必须学会在缺失该信号时仍给出 human-aware 回复。这要求蒸馏训练策略、心理学合理的状态更新机制,以及高质量模拟器设计。业界关注度较高,因为教育、健康咨询、工作助手等长期协作场景中,模型若无法理解用户真实目标,会频繁误解、重复询问,削弱信任。
行业类比
类似自动驾驶仿真中,车辆真实位置与意图作为 privileged ground truth 训练感知模型,但实车部署只能从传感器推断;这里则是用模拟的心理状态训练对话模型学会从语言推断并辅助用户。
核心洞察
- 将用户不可观测的信念与目标通过心理学引导的状态仿真转化为可扩展的监督信号,解决 human-aware LLM 训练中的监督 gap。 现有助手数据集极少包含显式基于用户未言明意图的回应,人工标注又受限于状态不可观测;Mind2Dialogue 构造共享演化的 mental state,同时驱动用户行为与 Oracle 回应,再用 privileged distillation 把知识迁移给学生模型。与普通 self-chat 或基于 persona 的合成数据不同,它强制长程状态一致性,使监督信号从表面文本升级为可推理的隐藏意图层。
- 将 privileged distillation 与心理状态模拟结合,使部署模型学会在不直接访问用户 mental state 的情况下,从对话历史推断并按目标行动。 传统个性化/ToM 模型往往在推理时显式输入 persona 或 belief,或仅评估静态心理归因;Mind2Dialogue 的 oracle 训练阶段可访问状态,学生模型仅在部署时使用外部对话,评估则同时覆盖 preference-following 生成与 belief/action reasoning。这种设计与学习 privileged information 的经典思想一脉相承,但针对 LLM 助手场景进行了适配,指向从‘读取用户状态’到‘推测并支持长期目标’的协作范式转变。
方法
输入与核心思路
Mind2Dialogue 的训练输入包含三类要素:用户画像 (persona,描述稳定特质与偏好)、场景定义 (scenario,如教育、工作、日常情境) 以及交互历史。核心思路是在模拟对话中显式建模用户不可观测的心理状态,将其作为特权信息生成高质量监督信号,再用蒸馏方式训练模型隐式捕捉这些状态。
关键模块
- 心理学引导的状态化用户模拟器:模拟器维护一个共享的演化心理状态 (beliefs, goals, emotions 等),该状态同时驱动用户行为与 Oracle 助手的回应。用户行为由状态和画像共同决定,保证对话连贯且贴合个人特性;Oracle 助手可以直接读取该状态,从而产生well-informed responses。
- 特权监督语料库构建:模拟器生成大量对话后,将 Oracle 的回应与对应的心理状态、用户画像、场景配对,形成训练数据集。只有 Oracle 回应作为监督标签,心理状态不直接暴露给最终模型。
- 特权状态监督蒸馏:采用类似 learning using privileged information (LUPI) 的思路,在训练时让模型预测 Oracle 回应,但输入仅包含对话上下文和用户画像(不含心理状态),迫使模型从上下文推断隐含的信念与目标。
输出与评估
最终输出是部署时无需直接访问用户心理状态的对话模型,能够根据用户画像和对话历史提供个性化、符合长期目标的回应。评估结合两个维度:个性化指标(如 preference-following generation)和心理理论推理(belief/action reasoning)。在 Qwen、Llama、OLMo 等基座上,个性化指标提升 26.6–40.9 个百分点。
与同类方法的差异
相比传统用户模拟器(仅使用静态 persona 或行为克隆)或合成对话方法(缺少明确心理状态建模),Mind2Dialogue 将心理状态作为可演化的共享变量贯穿用户行为和 Oracle 回应,并通过特权蒸馏实现从显式状态到隐式推理的迁移。
实验
实验设计
- 语料构建:使用心理学引导的用户模拟器生成 Mind2Dialogue 对话语料,每轮同步更新用户心理状态,并由 Oracle 助手基于该隐藏状态产生回答,形成特权监督。
- 训练与蒸馏:通过特权状态监督蒸馏,在 Qwen、Llama、OLMo 的 instruction-tuned 基线模型上训练部署模型;部署时模型只看到用户话语,不访问心理状态。
- 评估维度:组合个性化与 Theory of Mind 两类任务,覆盖偏好跟随生成、信念推理、行动推理等。
关键发现
- 偏好跟随生成:在完整 Mind2Dialogue 语料上训练后,提升幅度达 +26.6~+40.9 pp,且覆盖三类基线。
- 个性化指标:所有报告的个性化指标均超过对应 instruction-tuned 基线。
- 信念与行动推理:在 Qwen 和 Llama 上同样观察到增益,说明模型不仅能生成更符合用户喜好的回复,也增强了从话语推断潜在心智状态的能力。
与基线的深度对比
- 特权监督差异:相比普通 SFT 数据,Mind2Dialogue 把用户未言明的信念与目标作为显式训练信号,弥补了人类反馈中难以标注的监督缺口。
- 部署假设:通过 Oracle 蒸馏,模型学会在仅观察用户话语的条件下隐式建模心理状态,避免推理时依赖外部状态估计器。
- 局限:实验数据为合成生成,真实用户分布偏移尚未验证;此外训练算力未披露,可能影响复现与规模化评估。
行业影响
落地场景
- 个性化教育辅导:模型追踪学生知识盲点与学习动机,动态调整讲解策略,支持长期学习陪伴。
- 电商客户支持:识别用户未明说的预算、偏好与决策焦虑,提供更贴合的选品建议,提升咨询质量。
- 企业知识助手:面向员工长期项目协作,理解个人目标与工作风格,主动推送相关信息,减少沟通摩擦。
商业价值
- 降本:减少客服人工介入,通过更准确的意图理解降低平均处理时长,节省人力成本。
- 增收:提升推荐转化率与用户复购,尤其在高客单价咨询场景中转化更显著。
- 体验提升:用户感知被“理解”,增强粘性与满意度,适合教育续费、会员留存等指标优化。
与现有产品 / 工作流的接口
- 可将 Mind2Dialogue 生成的对话语料直接用于 SFT 或偏好优化,无缝接入 Qwen、Llama 等基座模型微调流水线。
- 通过特权蒸馏,模型训练时使用带心理状态的 Oracle 回复,部署时无需额外状态输入,与现有聊天接口兼容。
- 可与 RAG、多轮对话管理框架结合,在需要长期用户建模的场景中作为上下文理解增强模块。
具体用例
- 电商导购:用户说“想给父母买台相机,操作别太复杂”,模型需推理用户隐含的耐用性、易用性偏好,推荐相应机型并解释,而非仅罗列参数。
- 教育辅导:学生反复做错同类题且语气沮丧,模型识别其信心不足,调整为先给予肯定并提供分步提示,而非直接给答案。
局限
- 模拟用户心理状态的保真度局限:论文通过 **psychology-guided simulator** 生成用户 **mental states**,但真实人类心理状态难以完全模拟。模拟器依赖预定义场景和 **persona**,可能限制交互多样性,导致训练数据偏向特定行为模式。此外,合成数据由 LLM 生成,可能继承 LLM 的幻觉或偏见,影响监督信号质量。该局限可能使模型学习到对特定模拟用户群体的过拟合,削弱对真实用户的泛化能力。
- 评估依赖自动指标,缺乏真实用户研究:论文构建的 **human-aware 评估框架** 结合 **personalization** 和 **theory of mind**,但指标主要基于合成 QA 和 generation 任务。这些 **proxy metrics** 虽然显示了显著提升,但无法完全代表真实协作场景中的用户满意度。论文未进行人类评估或长期交互实验,因此模型在真实环境下的性能尚不确定。部分 reasoning 指标只在 Qwen 和 Llama 上报告,模型覆盖范围有限。
- 部署时用户 **mental states** 不可直接观测,模型间接推断能力有待验证:论文通过 **privileged distillation** 让模型学习从对话历史推断用户状态,但实际部署中,用户可能不充分表达自身信念和目标,模型推断错误可能导致不恰当的回应。论文未深入分析推断失败案例或不确定性建模,也未讨论如何将不确定性纳入交互策略。此外,训练数据合成和模拟器运行需要大量计算资源,成本较高,限制了方法的可扩展性。