MoME:面向上下文感知稀疏查找的 Mixture-of-Memory Embeddings
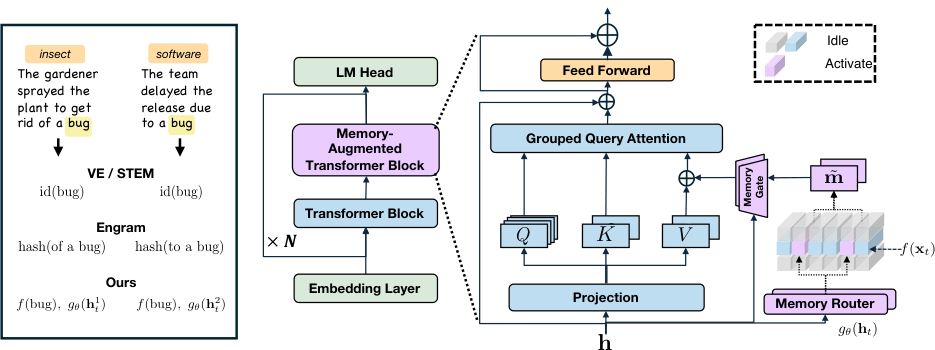
高效扩展大语言模型推动了稀疏容量机制的发展,例如 Mixture-of-Experts,以及更近期的条件记忆:用 token 索引的嵌入表,以廉价的参数化查找来增强主干网络。然而现有 memory-embedding 方法通过表层形式的确定性函数进行检索,这会把同一 token 在不同上下文中截然不同的语义(例如 python 指编程语言还是指蟒蛇)压缩进单一固定条目。 我们提出 Mixture of Memory Embeddings (MoME),一种上下文感知的记忆机制:它将每个 token 原本的单一记忆行替换为 M 个槽位的混合,并利用基于隐状态学习得到的门控,在每个位置决定应当读取哪些槽位。 在 nanochat、Llama-3/MobileLLM 与 Qwen3 主干上开展的受控预训练实验中,MoME 在等参数与等训练 FLOP 设定下均优于 Value Embedding、Bigram 和 STEM 基线;在 sub-billion 规模上展现出更具潜力的记忆容量缩放趋势,同时在训练与推理阶段都保持高效。 针对多义词的定性路由分析进一步表明,所学到的混合具有一定程度的语义可解释性:同一个表层 token 在不同语义下会被分派到不同的记忆槽位。
论文精读
TL;DR MoME 用可学习门控将每个 token 的单一记忆行替换为多个槽的上下文相关混合,解决传统 token-indexed 记忆的多义性塌缩,在等参数/等 FLOP 下优于主流记忆增强基线。
问题
问题背景
在大模型高效扩展的研究中,稀疏容量机制 已成为平衡模型容量与训练/推理成本的关键方向。其中 条件记忆(token-indexed embedding tables)通过廉价的参数化查找增强 backbone,被视为 Mixture-of-Experts 的轻量替代方案。
现有方法局限
现有 memory-embedding 方法(如 Value Embedding、Bigram、STEM)均采用基于 token 表层形式的确定性检索函数:token -> row。这种设计将同一 token 的所有上下文义项(例如 python 指编程语言或动物)坍缩为单一固定向量,无法根据当前语境区分语义。其本质是上下文无关的查找,导致记忆模块对多义词、同形异义词的表达能力受限,也无法按需为不同义项分配独立容量。
为什么难且重要
实现上下文感知路由需要在每个位置读取 hidden state 并执行软门控稀疏选择,同时保持参数与 FLOPs 可控,并避免路由坍塌和训练不稳定。业界对低成本扩展模型容量需求强烈,条件记忆被寄予厚望,但上下文无关的 lookup 成为性能瓶颈。MoME 提出的 mixture of M slots + learned gate 在 iso-parameter 与 iso-FLOP 设置下同时提升性能与可解释性,为 sub-billion 模型的 scaling 开辟了新路径。
行业类比
类似 搜索引擎中的查询词义消歧:同一查询词(如 apple)需要根据用户上下文(设备类型、搜索历史)路由到不同结果集,而非返回一个固定聚合页。
核心洞察
- MoME 将 token-indexed memory 从离散查找升级为上下文门控的连续混合,解决了多义词记忆冲突问题。传统方法(Value Embedding、Bigram、STEM)使用确定性检索函数,同一 token 的所有语义共享一个固定向量,导致信息混淆。MoME 通过学习门控从 M 个 slot 中加权组合,使每个位置能够根据上下文选择不同记忆,实现了更细粒度的条件记忆访问,这是对现有 conditional memory 机制的重要改进。
- MoME 在 iso-parameter 和 iso-training-FLOP 条件下优于基线,且 memory-size scaling 趋势更优,表明其在 sub-billion 规模上能高效利用额外记忆参数。与稀疏 FFN MoE 的 compound scaling 实验(见附录)显示,MoME 可以与 MoE 正交叠加,这为参数高效扩展提供了新路径:不依赖专家路由,而是通过记忆混合增加容量,训练和推理开销低,更适合低成本扩充模型知识。
方法
输入与索引
MoME 在每个 token 位置接收 token 索引 与 backbone 当前 hidden state。与传统 token-indexed memory 只依赖 surface form 不同,MoME 通过 Token-Index Grouping Function 将 token 映射到分组,每组分配 M 个可学习 memory slots,形成容量更大的记忆表。
关键模块
- Context-Aware Routing:一个轻量 router(MLP 或线性投影)从 hidden state 生成 M 维 gating score,经 softmax 得到上下文相关的 slot 权重。
- Memory Aggregation:按 gating 权重对 M 个 slot 行做加权求和,得到该位置的 context-aware memory embedding。
- Gated Injection:memory embedding 通过可学习 gate(如 sigmoid 缩放)与 backbone hidden state 残差相加,控制注入强度,避免破坏主干表示。
- Multi-Head Memory:为提升并行性和容量,memory table 分为多个 head,各 head 独立路由与聚合,输出拼接后注入,兼顾效率与表达能力。
输出
最终 hidden state = backbone hidden + gated memory embedding,后续可正常接 FFN、Attention 等层。训练中 memory table 与 router 随 backbone 联合优化,推理时仅增加一次查表与加权求和,延迟开销很低。
与 Bigram / STEM 等固定映射方法相比,MoME 的 router 完全由 hidden state 条件化,同一 surface token(如 python)在不同语境下可路由到不同 slot 组合,实现语义消歧。
实验
实验设计
MoME 在 nanochat、Llama-3/MobileLLM、Qwen3 三类 backbone 上进行受控预训练,对比 baseline 包括 Value Embedding、Bigram、STEM。采用 iso-parameter 与 iso-training-FLOP 设置,评估下游任务(CORE 域)与 WiC 词义消歧。
关键发现
- MoME 在等参数与等训练 FLOPs 下均优于所有 baseline。
- 在十亿规模以下,MoME 展示更优的 memory-size scaling 趋势;随 slot 数 M 增大增益更明显。
- 推理/训练延迟可控,multi-head memory 设计降低额外开销。
- 对多义词(如 python)的可视化路由分析显示,同一 surface token 在不同语义下被派发到不同 slot,呈现语义可解释性;WiC 上的量化结果也支持 sense-sensitive routing。
与基线对比
传统 memory-embedding 方法通过 surface form 的确定性函数检索,导致同一 token 的多个语境义被压缩到单一行。Value Embedding 仅提供单行静态记忆,Bigram 引入局部共现但无上下文门控,STEM 缺乏动态选择机制。MoME 用 learned gate over hidden state 选择 M 个 slot 的混合,使记忆读取依赖当前表征而非 token 字面,从而解决多义性问题,同时保持稀疏查找的计算效率。
行业影响
落地场景
MoME 适合低成本扩充模型容量 的场景,尤其端侧/轻量模型 (如 MobileLLM 系列)和垂直领域 LLM。在电商搜索与推荐 中,商品标题常含多义词(如 “apple” 品牌 vs. 水果),MoME 的上下文路由让同一 token 激活不同 memory slot,提升 query/product 理解。内容平台 的评论审核或标签生成中,俚语、简称的语境义变化也能被更好地捕获。
商业价值
核心在降本增效:用查表代替部分 FFN 计算,在 iso-parameter 下提升模型质量,等效于更少训练 FLOPs 达到同等性能,直接降低训练成本。推理端由于 memory lookup 的稀疏性,延迟增加有限,适合按需扩容。可解释路由为模型审计提供依据,降低合规风险。
与现有产品/工作流集成
MoME 可作为插件式模块 插入现有 Transformer 层,替换或增强 token embedding,无需改动 backbone。推理框架(vLLM、TensorRT-LLM)可通过自定义 lookup kernel 支持。训练时用 gated injection 保证稳定,可逐步 rollout。
局限
- **可扩展性仍待验证**:MoME 在 nanochat、Llama-3/MobileLLM、Qwen3 等 sub-billion 规模骨干上展示了优于基线的 memory-size scaling 趋势,但尚未在 7B 以上模型验证。额外引入的 M 个 slots 与门控网络虽然保持推理延迟友好,但参数量增加可能导致大模型训练不稳定或收益递减。此外,`token-index grouping function` 强制组内 token 共享同一组 slots,可能在高频词或语义差异大的组内产生 slot 冲突,降低路由特异性。
- **评测范围较窄**:论文仅在预训练困惑度上对比 Value Embedding、Bigram、STEM 基线,未报告下游任务(如推理、知识问答、语义消歧)的表现。这些基线相对陈旧,未与最新 conditional memory 方法(如更复杂的键值记忆或可微分路由)比较。缺乏大规模指令微调或 RLHF 阶段的验证,难以判断 MoME 在实际生产模型中的增益能否保持。
- **语义可解释性仅定性**:作者通过路由分析展示了多义词(如 python)被分配到不同 slots 的定性模式,但未提供定量指标(如 slot 与语义标签的一致率、纯度),也未在标准语义消歧数据集(如 WiC)上系统评测。这种可解释性可能仅适用于少数高频多义词,泛化性存疑。与可解释性更强的显式记忆方法相比,MoME 的隐式门控机制仍缺乏严格的语义对齐证据。