HarnessVLN: 通过 Agent Harness 统一免训练具身导航
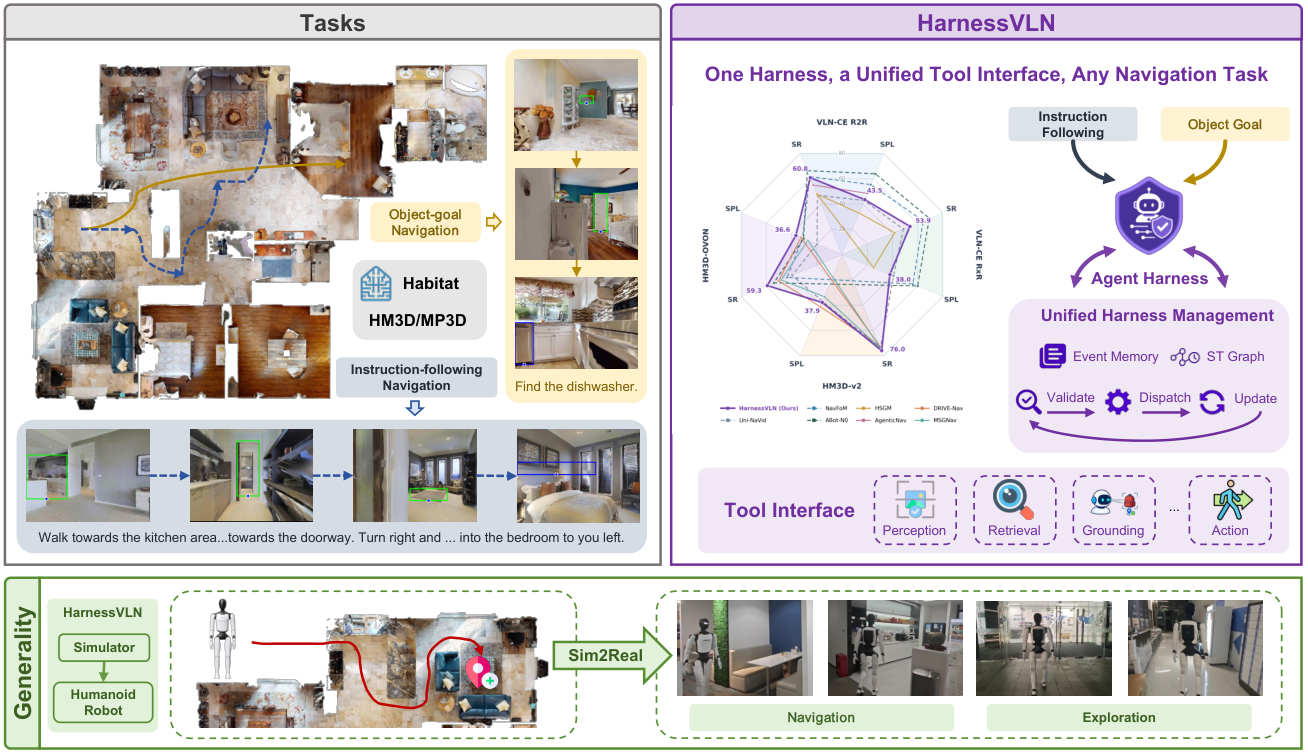
具身导航要求智能体解读视觉观测、累积空间知识并执行动作,以遵循指令或定位目标。基于训练的方法面临泛化挑战,而免训练方法虽利用多模态大语言模型(MLLMs),却常缺乏将所提动作与空间证据、任务进度和执行失败相调和的机制。 我们提出 HarnessVLN,一个零样本、免训练的框架,其 Agent Harness 通过统一工具接口协调感知、检索、定位、导航、恢复与终止。Harness 依据空间证据、几何可行性和子目标一致性验证规划器提案,并把结构化工具反馈纳入后续决策。分层事件记忆追踪任务进度与执行历史,持久化的时空图(Spatiotemporal Graph)则维护可复用的空间证据与失败标注,用于验证与恢复。可替换的 Navigation Executor 将验证后的目标转为可执行运动,使同一 Harness 协议同时支持指令跟随与物体目标导航。 HarnessVLN 在 R2R、RxR、HM3D-v2 和 HM3D-OVON 上分别取得 60.8%、53.9%、76.0% 与 59.3% 的成功率,超越此前的免训练 SOTA。人形机器人部署进一步表明其可适用于真实环境中的两类任务。项目主页:https://harnessvln.netlify.app/。
论文精读
TL;DR HarnessVLN 用 Agent Harness 统一工具接口,将 MLLM 规划与空间证据、几何可行性校验结合,并维护分层记忆和时空图,在 R2R、RxR、HM3D 等基准上以零样本免训练方式超越此前 SOTA。
问题
问题背景
具身导航(Embodied Navigation)要求智能体在真实或仿真环境中解析视觉观测、积累空间知识并执行动作,以完成指令跟随(如 R2R、RxR)或目标搜索(如 HM3D-OVON)。近年来,基于多模态大语言模型(MLLM)的训练自由(training-free)方法利用常识与推理能力,试图绕过传统监督学习在场景泛化上的瓶颈。
现有方法局限
现有 training-free 导航方案通常让 MLLM 直接输出下一步动作或航点,但存在三类突出问题:
- 空间证据脱节:MLLM 的提议动作缺乏与已观测空间结构的一致性校验,容易产生穿墙、跳跃等几何不可行的目标。
- 任务进度失察:缺乏对子目标完成状态、历史失败事件的显式建模,导致重复探索或过早停止。
- 错误恢复薄弱:导航执行失败后,系统难以复用失败注释和空间记忆进行针对性恢复,往往重启整个决策链。
这些局限使得 training-free 方法在长距离、多步导航中成功率和效率远低于训练基线。
为什么这个问题难/重要
具身导航的核心挑战在于长期空间推理与鲁棒执行的耦合:智能体必须在若干步决策中维持对“我在哪、我要去哪、我有没有偏离”的准确估计,同时处理视觉歧义、动作噪声和目标语言模糊。业界对此高度关注,因为零样本、免训练的统一框架能显著降低部署成本,使同一套神经符号协议适配各类机器人和任务形态。HarnessVLN 提出的 Agent Harness 正是针对上述缺口,通过工具接口统一协调感知、检索、规划、执行和恢复,并在 R2R / RxR / HM3D 系列上取得 SOTA,展示了结构化验证与记忆机制的有效性。
行业类比
类似 LLM agent 在复杂工具调用场景中需要 orchestrator 进行参数校验和状态回滚,具身导航也需要一个“执行外壳”来确保模型自信但不可靠的决策落到物理可行的动作序列上。
核心洞察
- Harness 层将 MLLM 的动作提案视为待验证假设,通过空间证据、几何可行性和子目标一致性三重校验过滤幻觉,并利用结构化工具反馈修正后续决策,从而在零样本条件下引入闭环验证。与以往直接采用 MLLM 输出动作的训练自由方法不同,这种机制弥补了缺乏训练时奖励信号导致的不可靠规划,使导航决策更接近基于学习方法的稳定性,同时保留零样本泛化能力。
- 持久时空图(Spatiotemporal Graph)同时承担可复用的空间证据库与失败注释库双重角色,使 agent 能够跨任务累积环境知识并避免重复路径错误。相比单次导航的 episodic memory,该图在长程任务和目标搜索中提供持久验证依据,显著提升 HM3D-OVON 等目标导航任务的容错性与效率。
- 可替换的 Navigation Executor 将高层规划与底层运动执行解耦,使同一套 Harness 协议无需修改即可同时支持指令跟随导航和目标导航。这避免了为不同任务定制独立完整 pipeline 的重复工程,降低了多任务部署与维护成本,也为后续扩展至其他具身任务提供了统一接入点。
方法
输入与核心框架
HarnessVLN 以 视觉观察序列、自然语言指令(指令跟随)或 对象目标(对象目标导航)为输入。整体框架由 Agent Harness 统一调度,将感知、检索、锚定、导航、恢复、终止封装为一致的工具接口。
关键模块与流程
- 规划提案验证:MLLM 规划器生成候选动作后,Harness 依据空间证据、几何可行性、子目标一致性进行校验,并将结构化工具反馈注入后续决策,避免直接执行不合理动作。
- 分层事件记忆:包含工作记忆(
working memory)、进度记忆(progress memory)与反思记忆(reflection memory),用于跟踪任务进度和执行历史,支持失败后的恢复。 - 持久时空图:维护可复用的空间证据与失败标注,通过任务条件检索为验证与恢复提供上下文。
- 导航执行器:将验证过的目标转换为可执行运动,该执行器可替换,使同一套 Harness 协议同时适配指令跟随和对象目标导航。
- 基于证据的终止:终止决策同样要求空间证据支撑,减少误停止。
输出与差异点
最终输出为一系列低层导航动作(如移动、旋转、停止),在仿真和真实环境中完成任务。与先前训练零样本方法相比,HarnessVLN 的差异在于引入显式的 Harness 验证机制,将规划器提案与空间证据、执行失败持续对齐,而非只依赖单次 MLLM 推理。
实验
实验设计
HarnessVLN 在四个导航基准上评估:R2R 和 RxR 为指令跟随任务,HM3D-v2 和 HM3D-OVON 为物体目标导航。采用零样本设置,与先前 training-free SOTA 方法对比,遵循官方评估指标(成功率 SR)。
关键发现
- 在四个基准上成功率分别达 60.8%、53.9%、76.0%、59.3%,全面超越先前最佳 training-free 方法。
- 消融实验表明 Agent Harness 的时空图、层次事件记忆和多维度验证均对性能有显著贡献。
基线对比解读
与直接使用 MLLM 生成动作的训练-free 方法相比,HarnessVLN 的核心优势在于将规划器提议通过空间证据、几何可行性、子目标一致性三重验证,并将失败信息反馈到后续决策,形成闭环。这有效减少了 MLLM 幻觉和长轨迹错误累积。可替换的 Navigation Executor 使同一套 Harness 协议能统一处理指令跟随和物体目标导航,展示了跨任务泛化能力,对实际部署(如类人机器人)具有工程参考价值。
行业影响
落地场景
HarnessVLN 面向训练自由的具身导航,可快速嵌入两类产品:
- 仓储物流机器人:在大型电商仓库中,机器人接收自然语言指令(如“把 A 箱搬到 B 区”),无需针对每个仓库重新训练,借助 MLLM 的零样本泛化即可执行指令跟随导航。
- 服务机器人:医院或酒店场景的物体目标导航(如“到护士站取药”),利用统一工具协议,同一套框架无需改动即可适配不同任务。
商业价值
- 降本:省去数据采集与训练算力,部署周期从周级缩短至天级;免训练特性降低 CD 成本。
- 体验提升:在 R2R 达到 60.8%、HM3D-v2 76.0% 等指标,超过先前 training-free SOTA,减少机器人错误与人工远程接管,提升客户信任。
- 可扩展性:替换式 Navigation Executor 支持多底盘,同一协议跨硬件复用,降低维护成本。
与现有产品/工作流的接口
- 机器人软件栈:封装为 ROS 2 节点,订阅 RGB-D 相机与里程计,发布速度指令;Navigation Executor 直接对接现有运动规划栈(如 Nav2)。
- MLLM 服务:作为云端推理微服务,通过 REST/gRPC 与机器人本地策略交互,支持模型热更新与多租户调度。
- 时空图 可对接现有 SLAM/建图 模块,形成持久环境记忆,跨任务复用失败标注,减少重复探索。
具体 use case:
- 电商仓储:跨国电商平台的智能拣选机器人使用 HarnessVLN,将订单语言描述转为导航路径,在动态货架间高效移动,试验显示任务成功率提升并降低回充/避障成本。
- 医疗配送:医院楼宇内配送机器人部署 HarnessVLN,根据护士语音指令导航至指定病房,同时利用时空图记录临时障碍(如走廊病床),提升夜间配送可靠性。
核心价值在于将 MLLM 的通用推理与可验证的空间执行桥接,让训练自由导航从研究走向工业部署。
局限
- **依赖 MLLM 基础能力**:该框架是 training-free 的,所有规划、感知与校验均基于现有多模态大模型。若底层 MLLM 在陌生场景、复杂指令或细粒度物体识别上出错,Harness 的验证与恢复机制只能做有限修正,无法像可微调策略那样针对特定环境优化。因此性能上限受 MLLM 能力制约,在 OOD 场景下可能会明显退化。
- **决策延迟与计算开销较高**:Agent Harness 引入了统一工具接口、层级事件记忆、时空图校验与迭代反馈,每一步决策需要多次 MLLM 调用与结构化验证。虽然提高了成功率,但显著增加了推理延迟和内存占用,对资源受限的真实机器人部署不够友好,且论文未充分量化端到端响应时间与显存消耗。
- **真实环境泛化验证不足**:实验主要在仿真基准(R2R、RxR、HM3D-v2、HM3D-OVON)和有限的人形机器人演示上完成,未系统测试动态障碍、多楼层、长期任务、传感器噪声等真实世界扰动。时空图的 failure-aware 更新属于启发式策略,长时运行中错误标注可能累积,影响后续验证与恢复的可靠性。