StepAudio 3 Music 技术报告
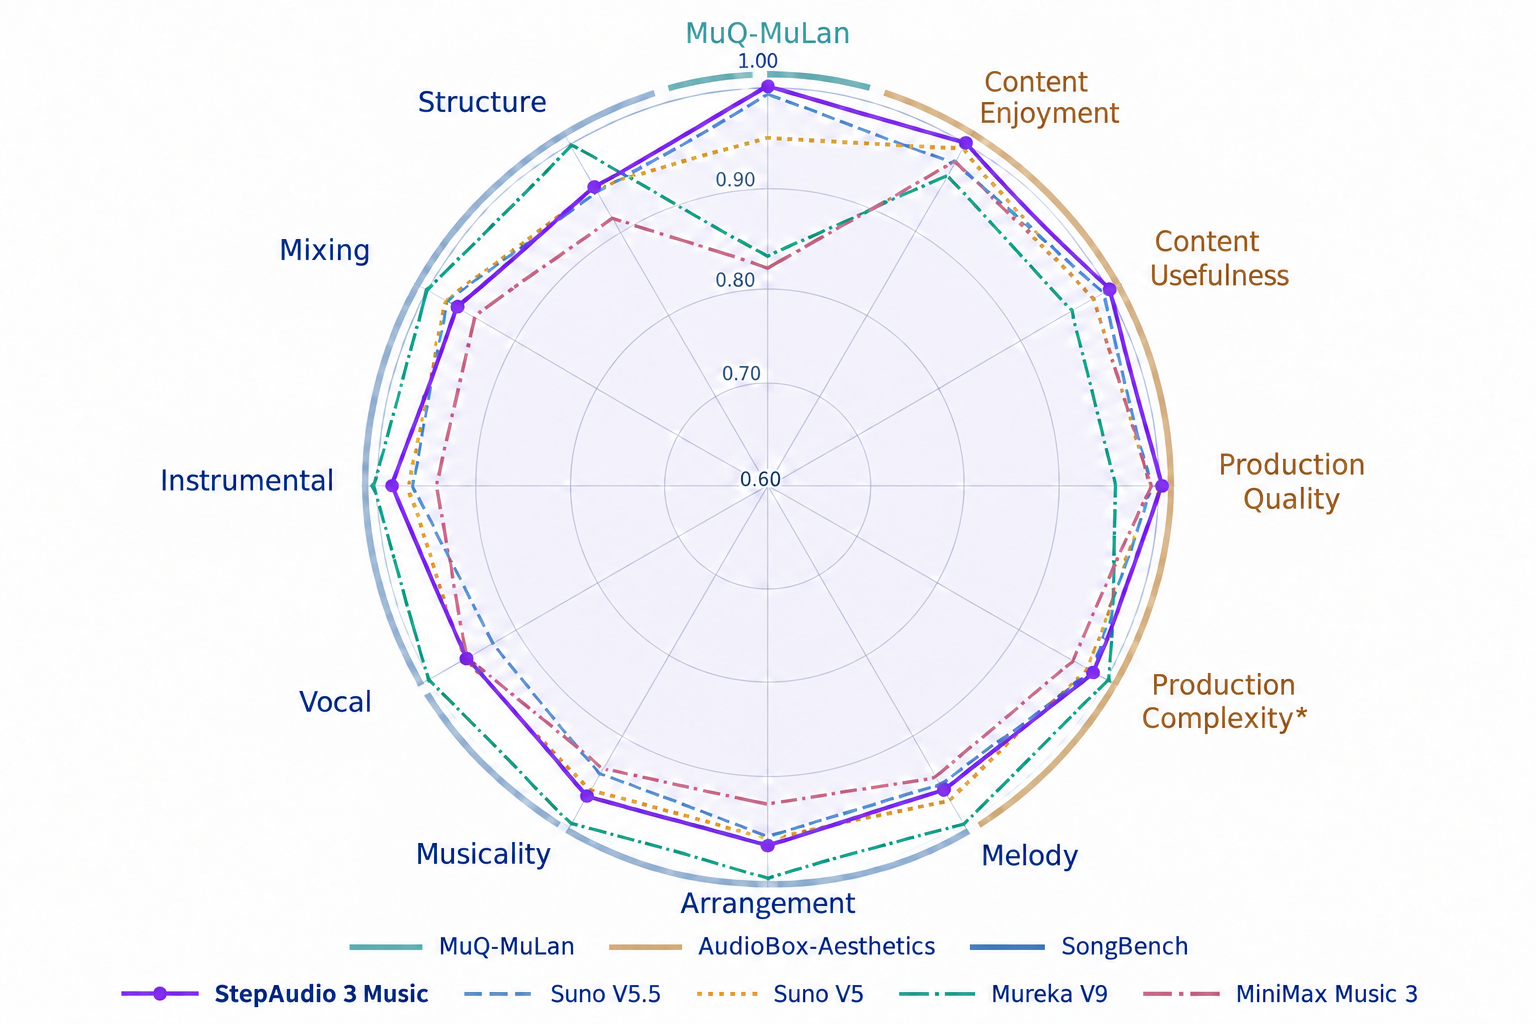
StepAudio 3 Music 是一个大规模、长时长音乐生成模型,支持显式音乐规划 与开放域文本控制生成。其 StepAudio Music Tokenizer 以来自 65536 词表单一码本的 50 Hz 流表示音频,并通过语义自监督与多任务训练保留音乐结构与重建相关信息。 flow-matching diffusion Transformer (DiT) 预测连续的 StepAudio VAE latent,再由 VAE 解码器转换为 48 kHz 音频;该离散-连续混合设计经单码本 VQ、Semantic/Acoustic RVQ 与不同 DiT 配置的对比确定。在显式规划上,Mixture-of-Experts 自回归模型 先用 ABC notation 生成中间编曲方案(ABC-CoT),再预测音乐 token,使和声、节奏与旋律结构进入生成上下文。 借助渐进式训练课程与监督微调,模型支持歌曲与器乐生成、干声伴奏生成及翻唱合成,最长 5 分 30 秒。经直接偏好优化(DPO) 强化学习后,最终模型在评测系统中取得最高的 AudioBox Content Enjoyment、Content Usefulness、Production Quality 分数与最高的 MuQ-MuLan 相似度,SongBench 结果亦具竞争力。在初步的 Artificial Analysis Music Arena Vocals 榜单上,其 Quality Elo 为 1105,仅次于 Suno V5.5 与 Mureka,领先 Suno V5、MiniMax 系列等系统。
论文精读
TL;DR StepAudio 3 Music 支持显式音乐规划,通过单一码本 tokenizer、ABC 记谱规划与流匹配 DiT 生成最长 5.5 分钟音乐,人工评测质量 Elo 1105,仅次于 Suno V5.5 与 Mureka。
问题
问题背景
长时音乐生成(>3 分钟)正从娱乐 demo 走向专业创作工具,业界核心关注音质、结构连贯性、显式可控性三者能否兼得。
现有方法局限
当前主流方案分两类,各有硬伤:
- 自回归 token 模型(如 MusicGen、早期 Suno):使用 RVQ 多码本离散表示,token 序列长、训练推理开销大;缺少显式音乐理论规划,生成几分钟后常出现结构松散、和声重复或旋律断裂。
- 扩散/潜在扩散模型:音质较好,但难以精确控制歌词对齐、段落结构;多数只能生成短片段或需要拼接,无法做长时统一生成。
- 音频 codec 设计:单码本 VQ 简洁但重建音质不足;语义 RVQ 或声学 RVQ 要么丢细节要么 token 过长,缺少针对音乐信号优化的离散表示。
- 不支持干声伴奏生成、翻唱合成等专业生产场景,难以嵌入 DAW 工作流。
为什么这个问题难/重要
音乐是长时结构化信号,局部音色、全局和声走向、节奏动机、歌词音韵必须一致;显式规划要求模型先理解 ABC 记谱(和声/节奏/旋律),再生成音频 token,这类似思维链引入音乐生成。技术上需同时解决:
- 设计保留音乐语义且重建质量高的 tokenizer(50Hz 单码本 65536 词表);
- 用 flow-matching DiT 做离散-连续混合解码,平衡生成效率与音质;
- 通过课程学习 + SFT + DPO 支持多任务与长序列。 业界关注度极高:音乐生成平台(Suno、Mureka 等)争夺专业创作者,客观指标(MuQ-MuLan similarity)与主观指标(AudioBox Production Quality)并重,且已进入 Artificial Analysis 竞技场排名竞争。
行业类比
类似长文本生成中 outline-then-write 的策略,音乐生成也开始采用“先规划 ABC 结构,再生成音频”,从而显著提升长时一致性与可控性。
核心洞察
- 用单码本离散 token 作为语义蓝图、由 flow-matching DiT 预测连续 VAE latent 还原声学细节的混合生成架构,平衡了自回归模型的长程结构建模与扩散模型的高保真合成。相比主流的多码本 RVQ 方案,该设计避免了码本利用率低和训练不稳定的问题,同时连续 latent 保留了音频细微变化;在 5 分 30 秒的长音乐生成中,既保证了结构一致性,又实现了计算效率与音质的折衷。
- 显式音乐规划(ABC-CoT)将 ABC 记谱作为中间推理步骤,使和声、节奏、旋律结构成为生成上下文的一部分,而非仅在 prompt 中隐含描述。与端到端直接预测音乐 token 的模型相比,该机制提供了可解释的中间表示,支持 LLM-based plan editing 和更精细的条件控制;同时通过课程学习和 SFT,将规划能力扩展到伴奏生成、翻唱等任务,提升了可控性和任务泛化性。
方法
整体流程
输入 为开放域文本描述(风格、情绪、歌词等)及可选的参考音频(如干声、翻唱源)。
关键模块 包括:
- 音乐分词器:将音频编码为 50 Hz 的单码本离散 token 流(码本大小 65536),采用语义自监督与多任务训练保留音乐结构与重建信息。
- 显式规划:MoE 自回归模型首先生成 ABC 记谱 格式的中间编排计划(ABC-CoT),再基于该计划预测音乐 token,使和声、节奏、旋律结构成为生成上下文。
- 流匹配 DiT 解码:给定离散 token,流匹配扩散 Transformer 预测连续 StepAudio VAE 隐变量,VAE 解码器将其还原为 48 kHz 音频,形成“离散-连续”混合生成链路。
输出 为最长 5 分 30 秒的高质量音乐,支持歌曲、器乐、伴奏(基于干声)及翻唱合成。
训练采用渐进式课程、SFT 与 DPO,强化偏好对齐。
差异点:与多数直接端到端生成音频或纯离散 token 自回归的方法不同,本工作通过 ABC-CoT 显式规划与离散-连续解码相结合,在长时音乐结构与音质之间取得更好平衡。
实验
实验设计
StepAudio 3 Music 采用 离散 token + 连续潜变量 混合架构:StepAudio Music Tokenizer 输出 50Hz 的 65536 码本流,经 flow-matching DiT 预测连续 VAE 潜变量并由解码器恢复 48kHz 音频。显式规划通过 ABC notation 生成中间编排方案(ABC-CoT),由 MoE 自回归模型 先产生 ABC-CoT 再预测音乐 tokens。训练分阶段:分词器自监督预训练 → 多任务表征学习 → 离散化;LLM 大规模预训练 → 多任务中期训练 → 高质量退火;后接 SFT 与 DPO 强化学习。评估覆盖客观指标(MuQ-MuLan similarity、SongBench)与主观指标(AudioBox 三维度),并参与第三方 Artificial Analysis Music Arena Vocals 排行榜。
关键发现
单一 65536 码本在 50Hz 下即可保留音乐结构与重建信息,离散-连续解码设计在生成质量与码本利用率间取得平衡。ABC-CoT 显式规划使和声、节奏、旋律成为生成上下文,显著提升长时序结构一致性。DPO 后模型获得最高 AudioBox Content Enjoyment / Usefulness / Production Quality 和最高 MuQ-MuLan similarity,SongBench 结果具竞争力;在 Artificial Analysis 排行榜上 Quality Elo 达 1105,排名第三,落后于 Suno V5.5 和 Mureka。
与基线对比解读
相较于常见 RVQ 方案(如 Semantic/Acoustic RVQ),单一码本 VQ 与连续潜变量结合在保持低比特率的同时避免了多码本残差误差累积;ABC-CoT 规划提供可解释的中间表示,便于后期编辑与条件生成(如干声伴奏、翻唱)。DPO 强化学习进一步拉开主观评分差距,验证了偏好优化对音乐生成主观体验的正向作用。
行业影响
落地场景
StepAudio 3 Music 支持长时音乐生成(最长 5 分 30 秒)、显式音乐规划(ABC-CoT 中间计划)及多任务输出(歌曲 / 纯音乐 / 伴奏生成 / 翻唱合成),可直接用于:
- 电商:批量生成商品短视频的促销感背景音乐,替代人工选曲或商业授权采购;
- 内容平台:为 UGC 视频自动匹配无版权风险的原创配乐,提升创作体验;
- 游戏 / 虚拟世界:动态配乐生成,适配不同场景与情绪;
- 教育:音乐教学辅助,生成练习伴奏或旋律示例。
商业价值
模型在 AudioBox 主观指标和 MuQ-MuLan 相似度上领先,并在 Artificial Analysis Music Arena Vocals 榜单获得高质量 Elo,证明生成内容具备商业可用性。降本方面,减少版权采购和作曲费用,缩短制作周期;增收方面,提供 API 订阅、企业定制、极速配乐等服务,提升专业音乐工具 ARPU;体验提升方面,用户可快速迭代多样风格,无需等待人工编排。
与现有工作流的接口
模型接受文本描述及可选参考音频(干声 / 风格示例)输入,输出 48 kHz 音频文件,可通过 REST API 集成到视频编辑器、数字资产管理平台、游戏引擎及 AI 音乐创作工具。ABC-CoT 计划可编辑,允许专业用户调整和声 / 节奏 / 旋律结构后再生成,适合半自动创作流程。伴奏生成能力可对接卡拉 OK 平台和播客后期工具,提供快速分离人声、生成专业伴奏的流水线。
局限
- 评估视角的局限:论文仅报告了 Artificial Analysis Music Arena Vocals 的初步 Quality Elo(1105),且未披露主观测试的完整样本量和置信区间;SongBench 结果标注为 competitive 但未给出具体分数或消融对比。此类 leaderboard 通常依赖有限的用户投票,prompt 分布和评价者偏好可能引入偏差,跨风格、跨语言和长时段的泛化能力尚需更大规模、更受控的盲测验证。此外,AudioBox 和 MuQ-MuLan 指标虽高,但客观指标与人类感知的相关性仍待进一步分析。
- 方法层面的局限:显式规划依赖 ABC notation 作为中间表示,其表达能力受限于记谱体系,可能无法完整覆盖现代流行音乐中的复杂和声、音色细节或微节奏变化。ABC-CoT 生成质量直接影响后续音乐 tokens 的结构一致性,若规划出现错误,扩散去 tokenizer 难以自动纠正,且模型最长支持 5 分 30 秒,对于更长作品需分段拼接,可能引入衔接不自然。多阶段 tokenizer 训练管线(自监督→多任务→离散化)复杂度高,增加了工程部署与维护成本。
- 与同类系统的对比局限:该工作采用离散 token + 连续 VAE latent 的混合架构,虽然通过对比实验选型,但整体管线仍比端到端模型(如 Suno 或 Udio 的部分版本)多出显式分离、转录、规划等环节,误差可能在管线中累积。论文未提供与最新闭源模型的公平同场对比,除 leaderboard 外缺乏统一的客观评测协议;DPO 训练依赖偏好数据,但未讨论奖励模型在分布外提示下的稳定性或潜在过优化问题。