DF26: 我们再也无法分辨真假
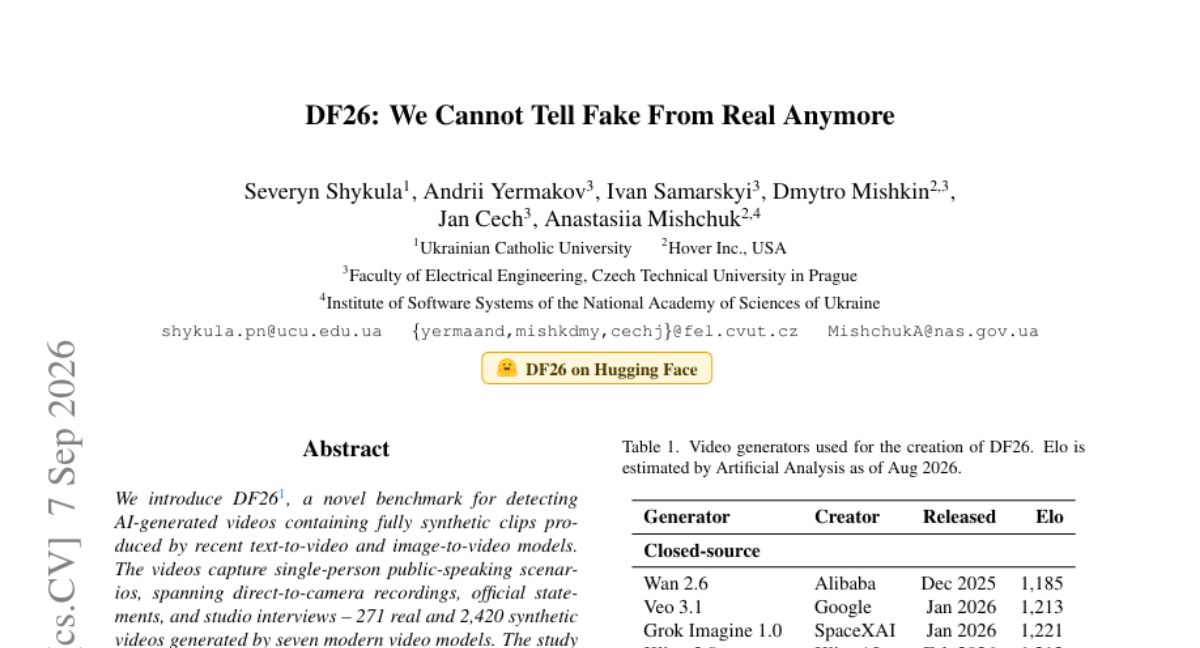
我们提出了 DF26,一个用于检测 AI 生成视频的新基准,其中的视频包含由近期 text-to-video 与 image-to-video 模型生成的完全合成片段。这些视频聚焦单人公开演讲场景,涵盖直视镜头的录制、官方声明以及演播室访谈等形式,共包含 271 个真实视频与 2,420 个合成视频,后者由七种现代视频模型生成。 在 DF26 上的研究表明,人类检测 AI 生成视频的表现,以及当前最先进的 deepfake detectors,都接近随机猜测水平。这一结果凸显了现有评测协议的局限,也说明亟需能够显式衡量对现代生成模型 distribution shifts 鲁棒性的基准。
论文精读
TL;DR DF26 基准收录 271 真实与 2,420 条合成单人演讲视频,覆盖 7 款新式视频生成模型;实验显示人类和前沿检测器准确率均接近随机,暴露现有评测在生成分布偏移下的失效。
问题
问题背景
视频生成模型(如 Sora、Veo、Kling)快速演进,全合成视频的真实感已接近实拍。检测此类 AI 生成内容成为安全关键任务,尤其针对单人口播、官方声明、演播室访谈等高风险场景。
现有方法局限
主流 deepfake 检测器 主要基于 FaceForensics++ 或 DFDC 等旧基准训练,这些数据集中于人脸交换、面部重演、属性编辑。模型往往依赖篡改过程遗留的伪影(如边界不一致、频域异常、拼接痕迹),但对 text-to-video 与 image-to-video 模型一次性生成的完全合成视频,这类线索几乎不存在。DF26 论文表明,人类受试者和 SOTA 检测器在 DF26 上的准确率均接近随机猜测(约 50%),说明现有评测协议与真实威胁严重脱节。
为什么这个问题难/重要
技术挑战在于:全合成视频没有「真实参照物」可以对比,传统空间/时间一致性假设失效;生成模型每更新一代,数据分布就发生剧烈漂移,检测器在前一代上训练的特征迅速过时。业界关注度极高:此类视频可低成本批量制造虚假演讲或采访,对社会信任构成直接威胁。
行业类比
类似 语音合成欺骗检测 中,基于固定说话人数据训练的模型遇到 zero-shot TTS 系统时性能骤降——生成方式的代际变化足以让检测器从高精度跌至无效。
核心洞察
- DF26 证明,对于完全由现代 text-to-video / image-to-video 模型生成的 full-scene 视频,人类和现有 SOTA 检测器的准确率都逼近随机猜测,说明检测能力已面临根本性失效。与 FaceForensics++、DFDC 等以面部操纵为核心的基准不同,DF26 系统性构造的七个现代生成器、单人口头演讲场景,暴露了检测模型只学到旧有伪造痕迹,无法泛化到新的生成分布。工程上意味着在部署检测器前,必须用与实际威胁同源的生成模型做分布偏移鲁棒性测试,否则指标虚高。
- DF26 将评估焦点从“特征是否被篡改”转向“内容是否完全合成”,重新定义了 deepfake 检测的基准设计逻辑。传统基准中的假视频往往源于对真实人脸的操作,保留了可识别的底层特征;而 DF26 中合成视频是端到端生成,每一帧都是模型输出,导致传统检测器依赖的低级伪影(如拼接边界、GAN 指纹)失效。这迫使研究者必须设计能够感知语义一致性、物理规律和生成模型分布特性的检测器,而非仅依赖图像级伪造痕迹。
方法
DF26 基准构建方法
输入: 271 段公开来源的真实单人公开发言视频(直拍、官方声明、演播室采访),以及由 7 款现代视频生成模型(涵盖 text-to-video 与 image-to-video)合成的 2,420 段全合成视频。
关键模块
- 数据筛选与溯源: 人工审核确保真实视频符合"单人面对镜头、采访者或观众发言"标准,记录来源与授权信息;剔除多人、剪辑、水印干扰等不适用片段。
- 合成生成: 对每个真实场景构造文本提示或直接使用真实帧作为条件,通过不同生成模型产生多样化伪影;生成参数覆盖多种分辨率与时长,保证分布多样性。
- 基准协议: 评估三类检测方式——基于帧的检测器(逐帧分类后聚合)、基于时序的检测器(利用光流或注意力时序特征)、以及人类受试者研究;另设重训练实验,将 SOTA 检测器在 DF26 训练子集上微调以测试对新分布的鲁棒性。
输出: 提供标注为 real / fake 的完整数据集,以及人类与检测器的 AUC / 准确率结果;核心发现是人类与现有检测器在 DF26 上均接近随机猜测,揭示旧基准与真实分布漂移之间的差距。
与 FaceForensics++ / DFDC 等聚焦换脸或面部属性编辑的旧基准不同,DF26 专门隔离全场景文本 / 图像到视频生成在公共演讲场景下的检测难度。
实验
实验设计
DF26 数据集包含 271 个真实视频与 2,420 个合成视频,由 7 个现代文生视频/图生视频模型生成,场景限定为单人公开演讲(直接对镜头、官方声明、演播室采访)。评估对象包括帧级与时序检测器、SOTA 模型在 DF26 上重训练后的泛化能力,以及人类受试者的判别表现。实验还按生成器(开源 vs 商用)和场景进行了细分分析。
关键发现
- 人类受试者 在区分 AI 生成视频与真实视频时,准确率接近随机猜测(约 50%)。
- 当前最先进的 deepfake 检测器 在 DF26 上同样表现不佳,AUC 或准确率逼近随机水平。
- 在 FaceForensics++、DFDC 等旧基准上性能强劲的检测器,迁移到 DF26 后性能大幅下降,说明存在严重的生成模型分布偏移。
- 按生成器分析显示,不同商用/开源模型的检测难度差异显著,但整体均未达到可靠水平。
与基线对比
DF26 与现有基准的关键差异在于:它针对全场景文生视频/图生视频生成,而非传统人脸替换或重演。Deepfake-Eval-2024 已指出学术基准与真实传播内容的脱节,DF26 进一步验证了该问题。在 DF26 上重新训练 SOTA 检测器虽有一定提升,但仍不足以应对未知生成器,这表明单纯依赖训练数据扩充无法解决根本的泛化瓶颈。需要设计对分布偏移鲁棒的评估协议和检测架构。
行业影响
落地场景
DF26 基准针对单人口播视频(direct-to-camera、官方声明、演播室访谈),为内容安全审核、媒体真实性验证、社交平台风控提供高价值测试集。电商直播、新闻采编、企业对外发布等场景均可引入基于 DF26 训练/评估的深度伪造检测 模块。
商业价值
当前 SOTA 检测器在 DF26 上接近随机,说明现有产品对现代 text-to-video / image-to-video 生成 的覆盖严重不足。使用 DF26 微调或作为持续评估基准,可显著降低漏检带来的品牌与合规风险(降本);同时,向平台或媒体客户提供更鲁棒的检测 API 能直接创造收入(增收)。此外,提升用户对内容真实性的信任可改善平台体验。
跟现有产品/工作流的接口
DF26 可直接作为模型回归测试集 接入 MLOps pipeline,用于跟踪检测器对生成模型分布偏移的鲁棒性。在内容上传流程中,可部署检测模型作为异步审核步骤,对视频进行逐帧或时序分析。团队可先在 DF26 上微调现有检测器(如 Xception、CLIP-based),再结合主动学习 迭代标注线上难例。
具体落地 use case:
- 视频分享平台:在用户上传视频时触发 DF26 训练的检测模型,自动拦截由 Sora、Runway Gen-3 等生成的虚假口播内容,减少人工审核成本。
- 新闻机构:对接收到的访谈或声明视频进行真实性预筛,标记出可能由 Kling、Pika 等模型合成的片段,辅助编辑决策。
局限
- - **场景局限性**:DF26 仅涵盖单人口播场景(直接对镜头、官方声明、演播室采访),未包含多人交互、群体事件、复杂动作或非演讲类视频。现代视频生成模型在非口播场景下同样可能产生逼真 deepfake,但该基准无法评估检测器在这些情境下的鲁棒性。应用 DF26 的研究者需注意其评估结论不能直接外推到更广泛的伪造视频类型。此外,数据集规模(271 真实视频)相对较小,可能不足以捕获真实视频的完整分布变异。
- - **检测器评估与人类研究的局限**:论文报告了多个 SOTA 检测器在 DF26 上接近随机表现,但未说明这些检测器是否经过了充分的超参数调优或领域自适应;且评估可能仅限于帧级或特定时间模态,未系统比较不同检测器架构(如基于 ViT、光流、音频等)的失效模式。人类研究虽引用 meta 分析支持接近随机,但 DF26 自身的人类实验样本量和协议细节需进一步公开以验证结论的稳健性。与专门针对语音驱动或 avatar 合成的基准相比,DF26 未提供多模态(音视频)联合检测评估。
- - **生成模型覆盖与分布偏移的有限性**:DF26 使用七种现代 text-to-video / image-to-video 模型生成合成视频,但生成器集合不可能穷尽快速迭代的商业模型(如闭源模型可能无法获取),且生成参数(prompt、seed、分辨率、时长等)的变异性未详细报告。这会引入**生成器分布偏移**(generator distribution shift)未被完全捕获的风险,导致检测器在 DF26 上表现差可能部分源于特定生成器的伪影,而非通用伪造特征。未来工作需扩展生成器多样性并引入持续更新机制,以提高基准的长期有效性。