Srijika:面向九种 Indic 文字的 OpenType 布局复用字体重风格化
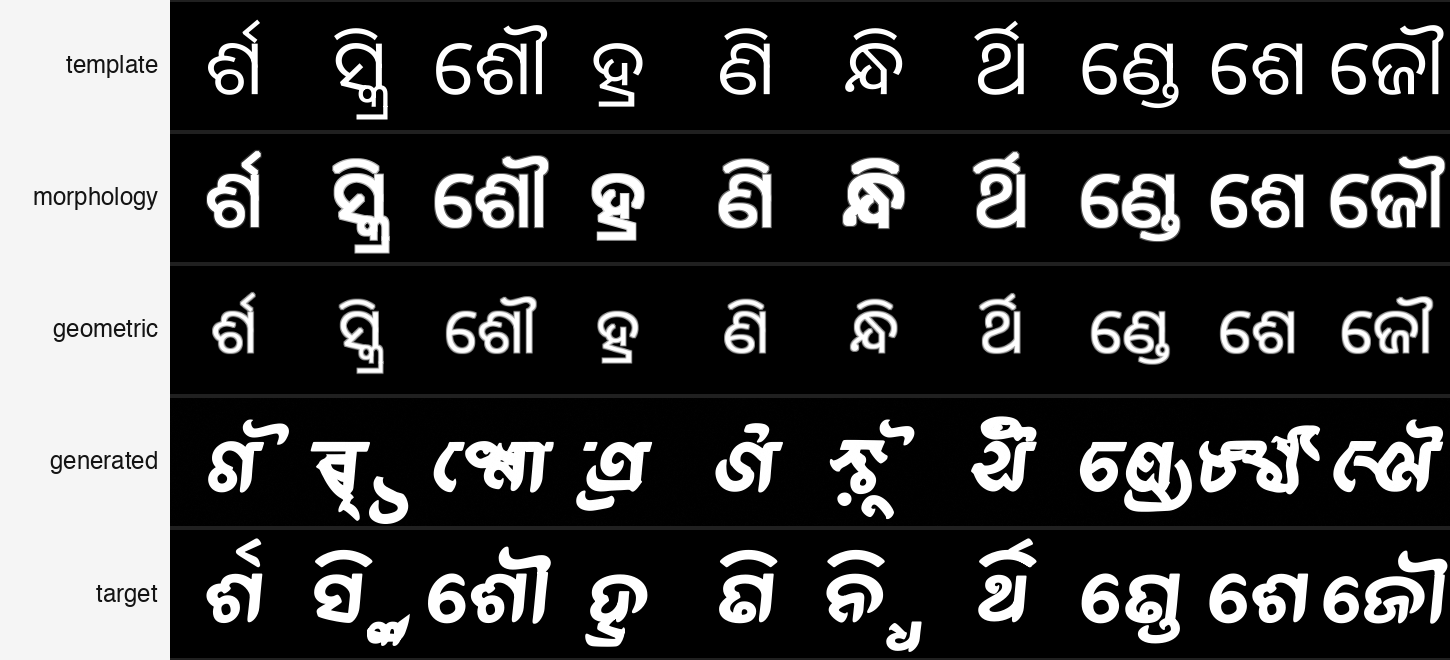
我们提出 Srijika,一个为九种 Brahmic 文字(Devanagari、Tamil、Bengali、Telugu、Kannada、Malayalam、Gujarati、Gurmukhi、Odia)生成可安装 OpenType 字体的系统。它不从零生成,而是从 shaping 完整的模板字体重绘字形轮廓,保留其 cmap、GSUB 闭包与 GPOS 数据,使每个输出在构造上即为完整字体。这解决了 Indic 字体生成的核心难题:数百至数千个 conjunct、半形与 matra 变体必须在 OpenType shaping 下保持一致。 Srijika 产出 66 个 TTF:57 个精选预设与 9 个开放词汇展示字体,全部通过 OpenType Sanitizer,HarfBuzz 与 CoreText 在 conjunct 密集探测中复现模板的 glyph-ID 序列。覆盖 80,915 字形与 54,812 anchor 的全闭包审计量化了度量变化。自然语言风格选择依赖 Lipika(约 650 个开放许可字体族的检索索引),再由参考条件潜扩散模型重绘字形,经内容门控、协调化与 shaped-cluster 验证,失败时回退模板轮廓。 与无学习基线对比,在字体族留出的 SSIM 门槛上,模板复制在 56 个 face 中的 50 个上优于生成;风格位移仅有内部同模型嵌入可测,结果需谨慎。贡献为布局复用的形式化与流水线、九种文字的审计与基准,以及一份负结果目录。
论文精读
TL;DR Srijika 以复用模板字体 OpenType 布局为前提,仅用扩散模型重绘字形轮廓,为九种婆罗米系文字生成可安装字体;这种 layout-reusing 策略从构造上保证了连字、半形等上千字形在 OpenType 整形下的一致性,解决了生成式字体方法难产出的核心问题。
问题
问题背景
生成式 AI 在字体设计领域的探索日益活跃,尤其关注如何自动生成多样化字体风格以降低设计成本。然而,现有工作多集中于拉丁文字,对复杂书写系统的覆盖有限。
现有方法局限
- 直接生成范式(如扩散模型逐个生成字形轮廓)缺乏对 OpenType 布局规则的显式建模。印度文字依赖 GSUB 替换生成数百至数千个合字、半形和元音附标变体,这些字形必须与基础字形风格一致且满足上下文替换逻辑。直接生成难以保证所有变体在 shaping 引擎下产生正确字形序列,常导致字体不可用或渲染错误。
- 模板复制范式虽然保留完整布局信息,但仅复制模板轮廓,无法实现风格迁移或自然语言引导的重新设计,输出样式单一,缺乏创新性。
为什么难 / 重要
- 技术挑战:九种 Brahmic 脚本的字体需包含约 80,000 个字形和 54,000 多个锚点,任何字形缺失、度量不一致或替换链断裂都会使字体无法通过 OpenType Sanitizer 或在实际排版中出错。风格迁移还必须在保持布局完整性的前提下进行,这是生成模型与字体工程规范的交叉难题。
- 业界关注:全球使用这些文字的人口超过十亿,数字出版、移动设备和网页设计对字体多样性的需求旺盛。专业字体设计师稀缺,自动化字体生成可大幅降低创作门槛,缩短设计周期,具有明确的产业价值。
行业类比
这一挑战类似于多语言语音合成中的音素覆盖问题:不仅要求单个音素发音准确,还必须保证所有音素变体在音系规则下协同一致,才能生成可用的语音系统。
核心洞察
- Srijika 的核心洞察是将印度文字的 OpenType 布局信息视为不可分割的契约,通过复用模板字体的 cmap、GSUB 闭包和 GPOS 数据,保证输出的任何字体在工程上完整可用。与从零生成字形的同类工作相比,该方法避免了同时生成并协调数百个连字、半形和 matra 变体的难题;与仅追求视觉风格的生成模型相比,它通过模板替换与回退机制确保了 shaping 行为的一致性,这是一种面向实际字体部署的务实路径。
- 该工作贡献的负结果目录揭示了在有限训练数据和字体风格迁移任务中,无条件扩散生成并未普遍超越模板复制的基线。在 diffusion-training-family-held-out 的 SSIM 门控测试中,模板复制在 56 个字体中的 50 个上优于生成,这量化了生成模型的真实边界。与大多数论文仅展示正向结果不同,Srijika 系统记录了失败的条件化尝试、客观损失选择和数据壳限制,为后续研究者提供了可复用的调试地图,避免了重复无效路线,增强了该领域的工程可信度。
方法
输入
用户提供自然语言风格描述(如“圆润的现代无衬线”)并指定一个shaping-complete 模板字体(覆盖九种 Brahmic 脚本之一)。模板字体包含完整的 cmap、GSUB 闭合和 GPOS 数据。
关键模块
- Lipika 检索索引
将风格描述映射到一个具体的开源 donor 字体(索引覆盖约 650 个家族),作为风格参考条件。 - Reference-conditioned 潜在扩散模型
以 donor 字体为条件,对模板字体的每个 glyph 轮廓逐一重绘。训练采用 warm-start grafting,单脚本约 20–48k 步;通过 per-script routing 避免跨脚本稀释。 - 内容门控与和谐化
用 SSIM 等指标门控生成的 glyph,保留语义;对通过门控的 glyph 做风格和谐化统一。 - Shaped-cluster 验证与修复
对复杂连字、半形、matra 变体等 OpenType shaping 序列进行验证;任何不合格 glyph 回退到模板轮廓,确保布局闭合。
输出
生成可安装的 OpenType TTF 字体。系统保留模板的 cmap 和 GSUB 闭合不变,GPOS 数据按 metric policy 调整;所有输出通过 OpenType Sanitizer,HarfBuzz 与 CoreText 在连字探针上重现模板 glyph-ID 序列。
差异点
与直接生成完整字体或仅输出单 glyph 图像的方法不同,Srijika 复用模板的 OpenType 布局,将字体生成转化为“轮廓替换”,从构造上保证了 Indic 字体所需的 shaping 契约完整性。
实验
实验设计
- 使用 9 种婆罗米系文字模板字体,通过 Srijika 流程生成 66 个 TTF(57 预设 + 9 开放词表)。
- 评估采用 no-learning 基线(template copy),在扩散训练家族留出的 SSIM gate 上比较模板复制与生成。
- 进行全闭包审计(80,915 glyphs, 54,812 anchors)量化度量变化。
- 使用 OpenType Sanitizer、HarfBuzz/CoreText 验证字体结构与序列复现。
- 训练脚本 graft 需要 20–48k steps。
关键发现
- 模板复制在 50/56 测试面上优于生成,风格移动仅在内部 same-model embedding 下可测,结果需谨慎。
- 所有 66 字体通过 OpenType Sanitizer,HarfBuzz/CoreText 完整复现模板 glyph-ID 序列。
- 风格轴分析表明 reference-conditioned diffusion 存在局限,但布局复用方案保证了字体可用性。
与基线对比解读
- 与 no-learning 模板复制相比,扩散生成在 SSIM 上多数情况不占优,说明生成风格迁移在数据量和度量上仍需改进。
- 然而该方法的核心优势在于布局复用:通过替换 glyph 轮廓,继承 cmap/GSUB/GPOS,确保所有输出为完整字体,这是生成模型难以单独实现的。
- 内部嵌入度量可能高估风格一致性,后续需独立风格度量与人工评估验证。
行业影响
落地场景
Srijika 直接服务需要多文字字体定制的产品线,尤其适用于面向南亚文字用户的内容平台、电商 UI、数字出版与教育科技产品。
- 电商与品牌设计:跨境电商或全球品牌在进入使用 Devanagari、Bengali、Tamil 等文字的市场时,需要与拉丁品牌字体风格一致的本地化字体。传统设计周期长达数月,Srijika 将模板字体与参考风格结合,快速产出可安装 TTF,缩短上线周期。
- 内容平台与工具:新闻聚合、社交媒体、在线文档工具需支持复杂 conjuncts 且保证渲染一致性。Srijika 的输出通过 OpenType Sanitizer 校验,可直接嵌入 Web 字体管线。
- 字库厂商与设计软件:作为快速原型工具,设计师可在 Glyphs/FontLab 中导入模板与参考字稿,生成初始候选字库,再进行精修。
商业价值
- 降低成本:人工绘制一套 Indic 字体需处理数百至上千个组合字形,Srijika 复用模板的
cmap、GSUB闭包与GPOS数据,将设计周期从月级压缩到天级,大幅降低人力与时间成本。 - 提升体验:保证所有输出字体通过 OTS 校验,且 HarfBuzz 与 CoreText 在复杂 conjunct 探针上重现模板 glyph-ID 序列,减少渲染错误与用户投诉。
- 增收路径:字库厂商可针对长尾语言或小众品牌提供快速定制服务,按字体族或项目收费,开辟增量市场。
与现有产品/工作流的接口
- 设计工具插件:Srijika 可封装为 Glyphs 或 FontLab 插件,接收模板字体与参考风格图像,输出 TTF 文件。
- 云端 API 化:参考 项目主页 的 Demo 形态,可部署为字体生成 API,集成到品牌资产管理平台或设计系统中,支持自然语言描述风格(如“圆润的现代风格”)。
- 前端集成:输出字体无需额外后处理即可用于 Web 字体服务,与现有
@font-face流程兼容;同时可作为扩散模型训练的数据增强工具,生成风格多样的字形样本。
关键限制:论文自述风格度量仅在同模型嵌入下有效,且模板复制在多数测试面上优于生成,因此工业部署需将其定位为“辅助设计”而非全自动替代,保留人工审核环节。
局限
- **评估基线不足**:论文仅与无学习基线比较,缺乏学习型基线、独立风格度量和人类研究。风格移动指标仅由内部同模型嵌入测得,且训练语料包含 held-out families,易引入偏差,作者亦呼吁谨慎解读。该局限削弱了风格迁移有效性的证据强度,使系统是否真正学到有意义的风格变换存疑。
- **模板依赖限制**:方法依赖模板的 cmap/GSUB/GPOS 数据,字形覆盖完全受限于模板,无法生成模板未定义的新字形或扩展字符集。扩散模型重建的字形可能风格不一致,尽管内容门控和回退机制确保输出安全,但论文显示在 50/56 面上模板复制优于生成,表明实际风格变换幅度有限,生成器尚未展现明显优势。
- **创意与扩展性受限**:与完全生成式字体设计方法相比,Srijika 的布局复用策略虽然保证了字体完整性,却也限制了创意自由度,无法探索模板之外的新字形结构或更激进的风格化。此外,系统目前仅覆盖九种 Brahmic 脚本,其他复杂文字系统的适配需要重新训练与工程调整,横向扩展成本较高。