一个编辑器,多种编辑:多样化视频编辑的统一免训练框架
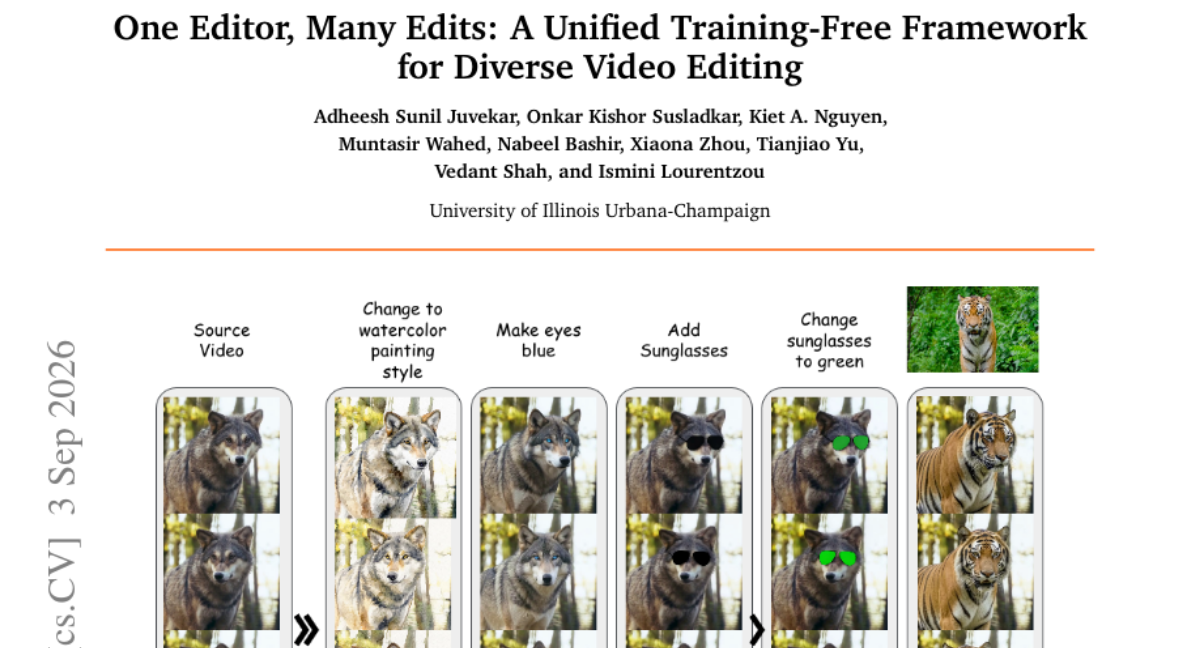
视频编辑涵盖多种编辑范式,但如何在统一框架内实现高质量的指令引导和主体引导编辑仍具挑战性。本文提出 EditVid,一个免训练框架,同时支持指令引导与参考引导编辑,包括风格迁移、属性修改、对象插入、部分级编辑和主体替换。 方法上,EditVid 结合三项关键技术:稀疏因果记忆 用于局部时序连贯性,基于对应关系的注意力后令牌注入 用于长程身份保持,以及 软潜在混合 用于约束编辑区域。该设计使框架无需额外训练即可适应多种编辑任务。 在 FiVE 数据集上,EditVid 达到 78.16 FiVE-Acc,而目前最强的免训练基线仅取得 58.95;同时在 IVEBench 上也获得有竞争力的结果。用户研究进一步表明,EditVid 的整体偏好率为 51.8%,优于 7 种对比方法。
论文精读
TL;DR EditVid 是一个训练无关视频编辑框架,通过稀疏因果记忆、基于对应的 token 注入与软潜变混合,在无需视频训练的情况下同时支持指令引导与主体引导编辑,FiVE-Acc 达 78.16,显著超越最强训练无关基线。
问题
问题背景
视频编辑领域正从专用模型向通用训练自由方法演进,核心诉求是复用图像编辑模型的丰富指令遵循与参考条件能力,在视频上完成风格迁移、属性修改、主体替换等多样化编辑任务。
现有方法局限
训练专用视频编辑模型需大量配对视频数据,成本高且难以覆盖所有编辑类型。逐帧应用图像编辑器缺乏时序耦合,会出现闪烁、身份漂移、编辑不一致以及背景意外改变。现有训练自由方法(如基于注意注入或 DDIM 反演的方案)在指令引导与主体引导任务上泛化有限:对长视频的身份保持不足,编辑区域可能泄漏到背景,局部一致性差,导致在 FiVE 基准上,训练自由最好基线仅 58.95 FiVE-Acc,远低于有监督方法。
为什么难且重要
难点在于:如何在现代 MM-DiT (如 FLUX、Qwen-Image) 中注入时间建模而不破坏其强大的图像先验;同时要解决三个相互制约的目标——局部时序连贯(帧间编辑区域一致)、长程身份保持(主体跨帧不变)、编辑局部性(不影响非编辑区域)。训练自由方法缺乏显式时序层,需要精心设计内存与令牌注入机制,且需避免过强的时序约束抑制编辑多样性。业界高度关注零样本视频编辑能力,因为它可大幅降低部署成本,允许单一图像编辑模型通过推理时技巧适配视频,与 LoRA 或微调方案形成互补。
行业类比
类似于将图像 inpainting 模型直接迁移到视频修复任务:仅逐帧处理会产生遮罩边缘闪烁与背景不一致,必须引入跨帧令牌对应或光流引导才能保证连贯,这正是训练自由视频编辑框架需要解决的核心工程问题。
核心洞察
- 统一训练免视频编辑框架通过解耦时间一致性、身份保持和编辑局部性,使指令引导与主体引导编辑在同一模型中有效共存。与以往训练免方法通常针对单一编辑范式或依赖视频扩散先验不同,EditVid 以现代图像多模态扩散 Transformer 为基础,在推理时引入稀疏因果记忆、基于对应的 token 注入和软潜在混合,不增加任何训练参数。这种思路为复用成熟图像编辑能力提供了低成本的视频扩展路径,值得工程团队在快速原型中验证。
- 稀疏因果记忆与基于对应的后注意力 token 注入分别处理短期与长期时间一致性,而软潜在混合负责编辑区域控制,三者组合显著提升了 FiVE-Acc。相比只使用注意力扩展或潜在混合的 baseline,EditVid 的设计更加精细:稀疏记忆降低计算成本并保证局部平滑,token 注入通过跨帧对应关系缓解长距离身份漂移,软潜在混合在 DDIM 潜在空间做平滑,避免编辑泄漏。这种分层结合机制为视频编辑中的一致性-保真度权衡提供了工程可复用的方案。
- EditVid 证明了训练免方法在视频编辑中可以达到甚至超越部分训练基线的性能,为快速部署和迭代提供了强有力证据。在 FiVE 上 78.16 的 FiVE-Acc 比最强训练免 baseline 高出 19 个百分点,用户研究也显示 51.8% 的偏好。对实际工程而言,这意味着无需视频特定训练即可利用图像模型实现高质量编辑,大幅缩短开发周期;但 FiVE-Acc 指标主要衡量编辑准确性,人类偏好还需结合更多样化场景评估。
方法
输入与整体流程
EditVid 接收两种输入:指令引导编辑 (文本指令) 或 参考引导编辑 (参考图像 + 可选指令),以及一段待编辑视频。统一处理流程基于预训练 MM-DiT 图像编辑器,通过三个无训练模块扩展时序,输出编辑后视频。
关键模块
- Sparse causal memory:在空间-时间注意力中引入稀疏因果记忆,每个 token 仅关注若干历史帧的对应 token,而非全部帧,以低成本维持局部时序一致性,抑制闪烁。
- Correspondence-based post-attention token injection:在注意力计算后,利用跨帧对应关系将源帧的编辑 token 注入到当前帧对应位置,保持长程身份一致性,防止主体漂移。
- Soft latent blending:在潜在空间对编辑区域与保留区域进行软混合,通过掩码或注意力权重控制编辑范围,确保局部编辑不扩散到背景。
输出与任务覆盖
输出为高保真编辑视频,支持风格迁移、属性修改、物体插入、部分编辑、主体替换等多种任务。
与以往 training-free 视频编辑方法仅支持单一编辑模式不同,EditVid 在无训练设置下同时统一指令与参考引导,并以三个模块显式解耦局部一致性、身份保持和编辑局部性。
实验
实验设计
EditVid 在 FiVE 与 IVEBench 两个视频编辑基准上评估。FiVE 覆盖指令引导的编辑任务,IVEBench 侧重参考引导与身份保持。对比对象包括 7 个训练无关基线,指标使用 FiVE-Acc 与 IVEBench 的编辑一致性/保真度指标。推理采用相同 MM-DiT 主干,不引入任何视频微调。
关键发现
- 在 FiVE 上,EditVid 取得
78.16FiVE-Acc,最强训练无关基线 为58.95,提升+19.21。 - 在 IVEBench 上结果具有竞争力(摘要未给具体数值)。
- 用户研究中,EditVid 相对 7 个竞争方法的整体偏好率为
51.8%,超过半数。 - 三类机制作用定位清晰:稀疏因果记忆 保证局部时序一致,基于对应的后注意力 token 注入 维持跨帧身份,软潜在混合 限制编辑区域。
与基线对比解读
EditVid 相比训练无关基线的主要差异在于把三个独立模块统一到同一框架,避免为不同编辑范式切换方法。FiVE-Acc 提升近 20 点,说明对应机制在指令编辑任务上并非仅靠单一 token 注入或注意力替换。用户偏好 51.8% 是在 7 个方法中排名第一,但仍有近半用户选其他方法,说明风格化/物体替换等细粒度场景还有提升空间。工程上,该框架无需训练,但推理包含后注意力注入与软混合,可能略增计算,需在部署时权衡延迟与一致性。
行业影响
落地场景
EditVid 的训练自由视频编辑能力可直接嵌入视频创作工具与内容生产流水线。例如 电商产品视频:商家提供参考图,工具自动替换视频中的产品颜色、材质或背景,无需重新拍摄;短视频创作平台 可让创作者通过文本指令对现有素材做风格迁移或局部修改(如给人物换装、插入 Logo)。
商业价值
核心降低成本:训练自由意味着无需收集标注视频、无需微调模型,只需复用预训练图像 MM-DiT,显著减少计算与数据成本。同时统一框架覆盖 指令引导 与 参考图引导 的多种编辑任务,避免为每种编辑类型维护独立模型。用户研究显示 51.8% 的偏好率,相比 7 种竞争方法有可感知的质量优势,利于产品差异化。
与现有工作流的接口
EditVid 基于预训练 MM-DiT 图像模型,可封装为轻量推理服务,通过 REST API 或插件嵌入现有视频编辑软件(如 Premiere / DaVinci Resolve)。输入为原视频 + 文本指令或参考图,输出编辑后视频,无需改变现有工作流。模型权重可作为模型权重加载,与当前扩散模型推理栈兼容。
具体落地 use case
- 跨国电商平台:买家上传参考图,运营人员批量生成同一产品在不同颜色/场景下的视频,用于 A/B 测试和个性化推荐。
- 在线教育平台:教师上传讲解视频,使用指令将板书手写内容替换为电子字体,或修改示意图局部,快速迭代课程素材。
局限
- 论文在 IVEBench 上仅取得 competitive 而非领先结果,表明该方法在部分编辑任务(如多物体互动或大幅运动)上的指令遵循与身份保持仍可能弱于有监督视频编辑模型;训练-free 策略依赖预训练图像 MM-DiT,难以弥补视频级时序先验的缺失,可能造成复杂场景下的伪影或闪烁。
- 方法引入了稀疏因果记忆、token injection 与 soft latent blending 三个模块,推理时需额外计算 attention 和 correspondence,可能增加显存占用与延迟;论文未提供与逐帧编辑或轻量时序一致方法的效率对比,也未报告长视频(数百帧)下记忆稀疏性带来的质量退化。用户研究偏好为 51.8%,仅略高于半数,说明主观一致性仍有提升空间。