VeriPhy: 用于世界模型评估与修正的智能体物理推理
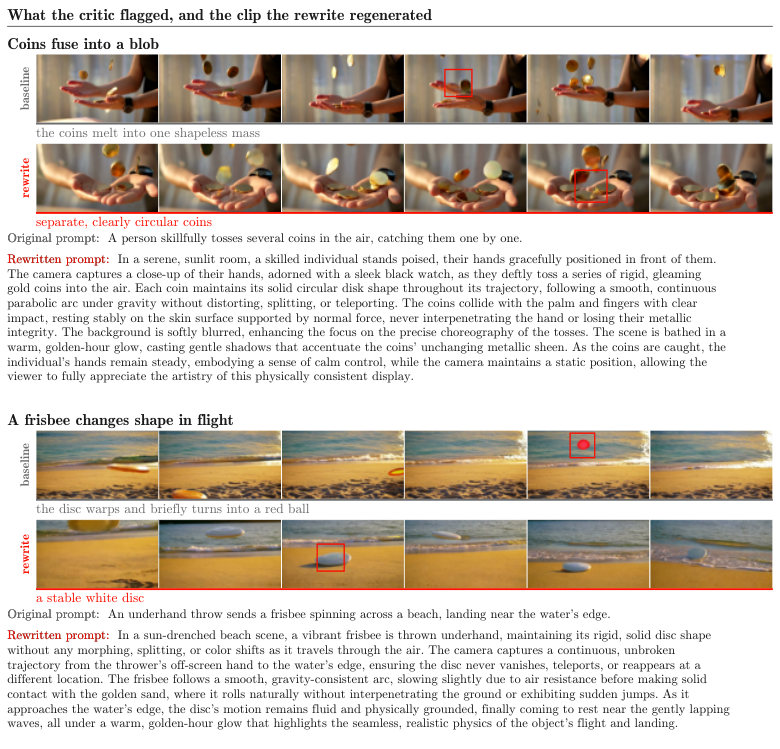
生成视频的视觉流畅性并不代表物理可靠性,单一质量分数也无法指出视频违反的约束或失败的时刻。我们提出 VeriPhy,一个可审计的物理验证系统:在观测任何帧之前,纯文本规划器将提示编译为类型化物理约束和经过静态验证的执行计划。执行过程中,观测仅对冻结的低层专家(如分割与跟踪、计数、基于轨迹的十一类物理测量、深度估计、OCR 和音频事件检测)的声明调用进行门控和限定范围。每个动作返回带有溯源记录的证据,其有效载荷为类型化测量值或显式标记的学习状态。类型化解析器和固定组合逻辑将可用证据映射为三值状态(支持、矛盾或未知,分别对应合理、不合理或弃权),并附带完整溯源,使每个判定都可追溯至产生它的证据。 我们以 1,500 条人工标注缺陷记录为语料进行评测,这些记录定位了生成在提示引用、空间和时间维度上的真实失败。在包含 304 条此类记录的 149 条核心视频子集上,VeriPhy 成功解释了 228 条,而同样的片段和声明下,已发表的问句分解评估器仅覆盖 164 条。单独看召回率,VeriPhy 并未区别于以整体方式提示同一骨干模型(后者达到 222 条),但其关键区别在于:每项决策都保留其证据记录和溯源,使单条判定即可审计,并可作为批评性判定写入生成过程的接口。
论文精读
TL;DR VeriPhy 将视频生成提示编译为类型化物理义务,调用冻结专家(分割、跟踪、深度等)测量并保留证据链,给出可追溯的三值判定;在 149 个剪辑上召回 228 条物理缺陷,核心优势是每个判定都可审计并能写回生成。
问题
问题背景
生成视频的 视觉流畅度 已经大幅提升,但物理可靠性仍难以保证。当前 AI 行业对世界模型的评估与生成修正高度关注,需要超越表面质量,验证视频是否违背了提示中隐含的物理义务。
现有方法局限
- 标量质量分数 (如
FVD/CLIP score) 只能给出整体评分,无法指出具体违背哪条物理约束、在哪个时间点失败。 - 已有 问题分解评估器 (question-decomposition evaluator) 虽然拆解了义务,但召回率有限,且缺乏证据溯源,难以定位失败原因。
- 单体大模型 直接评判视频物理合理性,召回较高但决策不可审计,无法形成可反馈到生成闭环的结构化证据。
为什么这个问题难/重要
物理义务类型多样(计数、轨迹、碰撞、深度、文字、音频事件),需要多模态时序证据(分割跟踪、深度估计、OCR、音频检测)协同验证。可审计性要求每个判定都能追溯到具体证据记录,这对世界模型在机器人 / 自动驾驶仿真中的可靠性至关重要——只有可追溯的判定,才能作为生成修正的接口,形成闭环优化。
行业类比
类似 自动驾驶仿真 中的碰撞评估:不仅需要事故率分数,还要输出具体碰撞帧、涉及对象和因果链,才能驱动场景生成器修正参数。
核心洞察
- **声明式物理义务** 将验证从“给视频打分”重构为“检查显式枚举的物理约束”。现有评估器往往只在剪辑级别给出总体判断或分解问答,不预先声明要验证哪些物理规律(如支持、碰撞、守恒),也无法定位违反发生的精确时刻。VeriPhy 在生成前用纯文本规划器把提示编译为类型化义务,并静态验证执行计划,使每个最终结论都能指向具体义务及其证据,审计粒度远细于现有工作。
- **冻结专家 + 溯源证据** 让验证系统在保持与端到端模型相近召回率(228 vs 222)的同时,获得逐条可追溯的决策路径。单一提示骨干虽然也能发现很多缺陷,但它是黑箱,无法说明哪个测量支持哪个判断;VeriPhy 把推理过程编排为对冻结低级专家(分割、跟踪、深度、OCR 等)的计划驱动调用,每个调用返回带溯源的证据记录,最终三值判定可沿证据链逐步重建,这是从“评分器”到“验证器”的关键差异。
方法
输入为生成视频与对应自然语言命题(如物理义务)。VeriPhy 首先由 text-only planner 在未观察任何帧前将命题编译为 typed physical obligations(带类型的物理义务)和静态验证的执行计划,计划声明可调用的低层专家及其调用条件。
关键模块:
- 静态验证:确保执行计划只调用已声明的 frozen low-level experts,例如 segmentation/tracking、counting、depth、OCR、audio-event detection,且每个调用都有 observation gating 和 scope 限制。
- 时间线条件执行:沿视频时间线按计划调用专家,每个动作返回 provenance-carrying evidence record,其 payload 为 typed measurement 或显式标记的 learned state。对跟踪轨迹可计算十一种 typed physical measurements(如位移、接触等)。
- 裁决聚合:typed resolvers 与固定组合规则将可用记录映射为三值状态
supported/contradicted/unknown,对外呈现为plausible/implausible/abstain,每个裁决都能回溯到具体证据记录。
输出为带完整 provenance 的三值裁决及证据链,可作为 refinement 接口写回生成循环。 与同类 decomposition evaluator 或 monolithic prompting 的差异在于:不依赖单一标量分数,每个决策保留证据记录和 provenance,使判断可逐条审计。
实验
实验设计
- 构建 1,500-clip 人工标注缺陷记录语料,每条记录定位 prompt / 空间 / 时间的生成失败;核心评估集为 149-clip / 304 条缺陷记录,另在 Physion-Eval 上做 held-out 测试。
- 对比基线包括已发表的 question-decomposition evaluator(给定相同 clip 与 claims)和同 backbone 的单体提示。
关键发现
- VeriPhy 在核心集上追溯出 228/304 条缺陷,优于 question-decomposition 的 164 条。
- 单体提示达到 222 条,召回接近,但缺少 evidence record 和 provenance,无法逐条审计。
- 每项判定保留完整证据链,traceable 到具体测量,如 segmentation/tracking、depth、OCR、audio-event detection 等。
工程启示与差异
- 与仅输出标量评分或黑盒判断不同,VeriPhy 用 typed physical obligations + frozen low-level experts 生成 provenance-carrying evidence,使判定可回溯、可写回生成循环。
- 实际评估系统不应只追求召回,决策可解释性与可写入生成器的接口同样关键;VeriPhy 的 verdict 可作为 critic 反馈驱动 refinement。
行业影响
落地场景
VeriPhy 可直接嵌入生成视频的质量保障链路,尤其适合对物理一致性有强要求的场景。
- 电商产品视频:虚拟试穿、商品动态展示中,衣物飘动、物体碰撞等物理错误会直接损害转化率。VeriPhy 可自动标记违反物理常识的片段。
- 自动驾驶与机器人仿真:生成式仿真数据若出现车辆轨迹、刚体碰撞的错误,会污染下游训练。VeriPhy 的 typed physical obligations 能定位失败时刻,帮助过滤或修正数据。
- 内容平台审核:UGC 或 AI 生成视频中,可审计的 verdict(plausible / implausible / abstain)能作为自动打回或二次人工复核的依据。
商业价值
核心价值在降本与信任提升。
- 减少人工审核:传统物理合理性检查依赖逐帧人工,VeriPhy 将证据记录结构化,人工只需复核有 provenance 的判决,审核成本可显著下降。
- 降低返工与召回风险:在生成流水线中前置 critic,可避免带有物理错误的视频进入交付环节,减少客户投诉与产品召回。
- 可审计性成为卖点:对于医疗教育、工业仿真等高风险场景,提供可追溯的证据链能满足合规要求,支撑付费溢价。
与现有产品/工作流的接口
VeriPhy 适合作为生成后 critic 微服务接入现有 MLOps 或视频生成平台。
- API 化集成:将 prompt 与视频帧输入,输出三值判决及证据 JSON,可对接内容审核系统或数据标注平台。
- 与生成循环耦合:将 VeriPhy 的批评 verdict 写回生成器(如论文中的 refinement 实验),形成闭环优化,提升生成质量。
- 与专家工具库解耦:其冻结的底层专家(分割、跟踪、深度、OCR 等)可替换为企业自有模型,便于私有化部署与定制。
例如,某电商平台使用 Sora/Kling 生成商品展示视频,可将 VeriPhy 作为后置检查器:对“物体从桌面滑落”等物理约束进行验证,只发布
supported片段,并对contradicted片段自动触发重新生成或降级处理。
局限
- - **覆盖范围受限于冻结专家**:VeriPhy 依赖一组固定的低级专家(分割、跟踪、深度、OCR、音频事件检测)输出类型化测量。对于无法被这些模态化证据直接支撑的物理义务——例如流体动力学、材料形变、因果链或复杂遮挡关系——系统只能返回 `unknown`/`abstain`。规划器静态校验仅保证类型正确,无法判断专家是否真正能测量该义务,导致漏检或大量弃权。作者未在实验中系统分析 `abstain` 比例对结论的影响。
- - **评价基准规模有限且标注主观**:核心评估集仅 149 个视频片段、304 条缺陷记录,虽然来自 1500 条人工标注语料,但覆盖面窄。人工标注的缺陷位置和时间区间可能存在主观性和一致性偏差,匹配协议未交代标注者间一致性。因此召回率比较(VeriPhy 228 vs 分解评估器 164)在统计上可能不稳定。作者在 Physion-Eval 上的 held-out 评估也偏小,泛化到不同生成模型和提示分布的证据不足。
- - **审计性未转化为感知质量提升**:将 critic 判定写回生成器的闭环实验显示,在 VeriPhy 自身指标上有效,但独立评分者未观察到变化。这说明 provenance 和 typed obligations 虽能定位问题,但生成的修正反馈不足以改善视频的物理合理性。此外,与 monolithic prompting 相比,VeriPhy 的召回优势很小(228 vs 222),主要贡献是证据可追溯,实际部署中用户可能更关注提升检测准确率而非审计链路。