Enoki: 高效的多层次幻觉检测
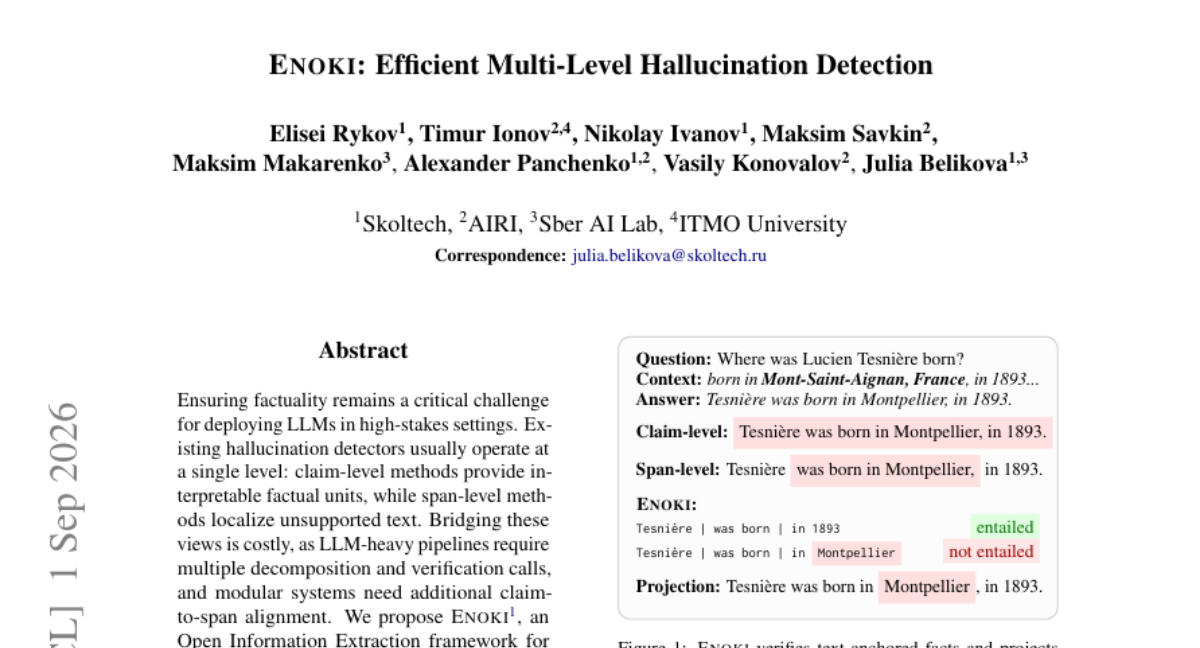
确保事实性仍是高价值场景中部署 LLM 的关键挑战。现有幻觉检测器通常只在单一层面运作:claim 级方法提供可解释的事实单元,而 span 级方法定位不受支持的文本。桥接这两种视角成本高昂,因为依赖 LLM 的流程需要多次分解和验证调用,模块化系统还需要额外的 claim-to-span 对齐。 我们提出 Enoki,一个用于多层次幻觉检测的开放信息抽取框架。Enoki 抽取文本锚定的关系事实,对照证据进行验证,并将不受支持的事实投影回幻觉 span。这种共享表示使得 claim 级验证和 span 级定位无需单独对齐即可实现。Enoki 支持基于 LLM、基于编码器和基于规则的抽取机制,通过通用接口平衡准确性和推理成本。 实验表明,Enoki 在使用更少资源的情况下与强 claim 级系统保持竞争力,并在细粒度 span 级和实体级定位上取得了更优性能。我们还发布了 EnokiQA,一个具有对齐的 claim 级验证和 span 级定位标注的双粒度数据集。
论文精读
TL;DR Enoki 用开放信息抽取统一声明级验证与片段级幻觉定位,以共享关系事实降低资源消耗,并发布双粒度标注数据集 EnokiQA。
问题
问题背景:LLM 幻觉检测是事实性保障的关键环节,当前研究在检测粒度与可解释性之间寻求平衡。
现有方法局限:主流方案通常在单一级别工作。claim-level 方法(如 FActScore)将文本拆解为原子事实进行验证,可解释性强,但分解后丢失原文位置信息,无法回溯到具体 span;span-level 方法(如 RAGTruth)虽然能定位不支持片段,却缺乏结构化事实级证据,难以解释。桥接两者成本高昂:LLM-heavy 流程需要多次分解与验证调用,模块化系统则要额外做 claim-to-span 对齐,增加延迟与工程复杂度。
为什么难/重要:事实性验证需要同时满足细粒度定位与可解释验证,但不同粒度的表示不一致,导致工程实现割裂。高吞吐、低成本的幻觉检测在 RAG、医疗、金融等高 stakes 场景需求迫切,而现有 LLM 中心化流程推理开销大,难以规模化。需要一种统一表示,将验证与定位投影到同一事实表征上。
行业类比:这类似于代码审查工具把 lint 报错精确到具体代码行,同时提供规则解释;RAG 系统需要指出源引用中哪些字段不支持生成结论。
核心洞察
- 共享文本锚定的关系事实作为统一表示,消除 claim 到 span 的对齐开销。传统多层级检测要么分别运行两套系统(如先做 claim 分解验证,再进行 span 定位),要么需要 LLM 多次调用;Enoki 利用 OpenIE 提取的 (subject, relation, object) 三元组天然带有原文偏移量,验证失败的事实可以直接投影回对应文本片段,从而在一次抽取和验证中同时获得 claim 级与 span 级结果。这种设计将原本需要额外对齐模块的 pipeline 简化,降低了推理成本并提高了可维护性。
- 多后端抽取策略(LLM / encoder / rule)提供了一个精度-成本可调的统一接口。相比现有系统通常绑定单一后端(如纯 LLM 或纯规则),Enoki 允许根据场景选择:在线低延迟场景用 encoder 或 rule,离线高精度场景用 LLM,且后端之间共享验证逻辑。这在实际工程部署中非常关键,因为幻觉检测的延迟和成本往往决定了系统能否上线。
方法
输入与总体流程
Enoki 接收一段待检测文本(通常是 LLM 生成的回答或句子)以及对应的证据上下文(如检索段落或源文档)。框架按 事实抽取 → 事实验证 → 投影对齐 三个模块依次处理,最终同时输出声明级验证结果与跨度级定位结果。
关键模块
事实抽取
从待检测文本中提取文本锚定关系事实(text-anchored relational facts),每个事实由主体、关系、客体组成,并明确对应原文中的具体文本片段。Enoki 提供三种抽取后端,通过统一接口平衡精度与成本:- Enoki-LLM:基于指令微调或提示的大模型抽取,采用 CycleOIE 风格的增量生成方式,适合高精度场景。
- Enoki-Encoder:训练一个编码器模型(如序列标注或生成模型)直接抽取事实,推理开销远低于 LLM。
- Enoki-Rule:基于句法规则库与模式匹配的抽取,零推理成本,适合简单句式或低延迟要求。
抽取的事实作为共享表示,同时支撑声明级和跨度级任务,避免额外的 claim-to-span 对齐步骤。
事实验证
对每个抽取的事实,与证据上下文进行核对(使用 NLI 模型或轻量验证器),输出支持/不支持/无关的标签。验证粒度是独立事实,因此可以复用现有 NLI 模型而无需逐声明分解。投影对齐
将验证为不支持的事实直接映射回原文中的锚定片段,得到幻觉 span;若多个不支持事实覆盖同一实体,则可进一步聚合为实体级幻觉标注。
输出
- 声明级:整句或整段文本是否包含幻觉(二分类或分数)。
- 跨度级/实体级:具体哪些文本片段或实体为幻觉,并附对应的不支持事实作为解释。
与同类方法差异:Enoki 通过共享关系事实表示统一了声明级验证与跨度级定位,单次抽取即可同时服务于两个任务,显著减少 LLM 调用次数或额外对齐模块,在保持竞争性精度的同时降低推理成本。
实验
实验设计
Enoki 在多个基准上评估,包括新发布的 EnokiQA 数据集(含对齐的 claim-level 验证与 span-level 定位标注),以及 MuSHROOM 和 RAGTruth 等幻觉检测基准。实验覆盖三个粒度:entity-level 检测、span-level 定位、sentence-level 检测,并对比三种提取后端:Enoki-LLM、Enoki-Encoder、Enoki-Rule。同时进行消融研究,分析去语境化依赖、增量投影等组件的作用。
关键发现
Enoki 通过 Open Information Extraction 提取 text-anchored 关系事实,统一了 claim 级验证与 span 级定位,无需额外对齐步骤。在 claim-level 验证上,Enoki 与强基线保持竞争力,但推理资源消耗更少;在细粒度的 span-level 和 entity-level 定位上,Enoki 取得显著优于基线的性能。
与基线的对比深度解读
传统多级幻觉检测要么依赖 LLM 进行多次分解与验证调用,成本高;要么采用模块化系统,需要额外的 claim-to-span 对齐模块。Enoki 的共享关系事实表示天然桥接了两级任务,避免了重复计算和对齐开销。这种设计对工程实践有重要启示:通过抽取中间表示来统一不同粒度的任务,可以在保持可解释性的同时降低推理成本,并提升定位精度。
行业影响
落地场景
Enoki 面向高 stakes 场景下 LLM 的事实性保障:医疗问诊摘要、金融报告生成、电商客服问答、法律文本辅助、内容平台自动审核等。其多层级输出既能提供 claim-level 可解释性,又能定位到具体 span,适合需要审计追踪的业务。
商业价值
- 降本: 支持 LLM / Encoder / Rule 三档后端,可在保证准确率的前提下大幅降低推理成本;共享关系事实表示避免重复分解与对齐,减少多次 LLM 调用。
- 体验提升: span- and entity-level 定位让用户看到具体不可靠片段,增强信任;对合规团队来说,自动定位减少人工复核工作量,加快问题响应。
集成方式与典型用例
Enoki 可作为 post-hoc 过滤器嵌入 RAG 管道或生成系统,输入生成文本与证据,输出验证结果。其 OpenIE 中间表示可直接对接现有 NLI 验证器,也支持封装为独立服务供 LangChain 或 LlamaIndex 调用。典型用例:
- 在线教育平台的 AI 答疑:用 Enoki 检测回答中哪些表述不被教材证据支持,向学生显示“该说法缺乏来源依据”。
- 电商客服机器人:检测产品功能描述是否与商品详情页一致,防止虚假承诺。
局限
- - **抽取脆弱性**:Enoki 统一表征依赖 OpenIE 的事实抽取质量,错误抽取会直接传播到验证和投影阶段。LLM 后端提取精度较高但推理成本与延迟显著,而 `Enoki-Rule`/`Enoki-Encoder` 虽高效,其规则覆盖与编码器泛化能力受限,在开放域或复杂句法上可能召回不足,整体框架未提供动态后端选择策略以平衡成本与召回。
- - **评测范围局限**:实验集中在 MuSHROOM、RAGTruth 和自建 EnokiQA,领域覆盖以通用问答和摘要为主,缺乏对长文档、多证据冲突、代码/科学事实等场景的验证;EnokiQA 规模与标注一致性未见详细报告,且未与最新的 span 级端到端模型(如结合长上下文 NLI 或 token 级幻觉概率的方法)进行充分对比,结论的外推性待验证。
- - **效率与可扩展性**:论文强调 FLOPs 理论优势,但未提供端到端延迟、GPU 内存占用或批量推理吞吐的实测;在真实高并发 RAG 系统中,多次 OpenIE 抽取与验证调用可能引入额外编排复杂度,且多后端切换需要额外工程适配,限制了即插即用性。