让置信度改变而非预测改变:面向事后校准的预测保持修复
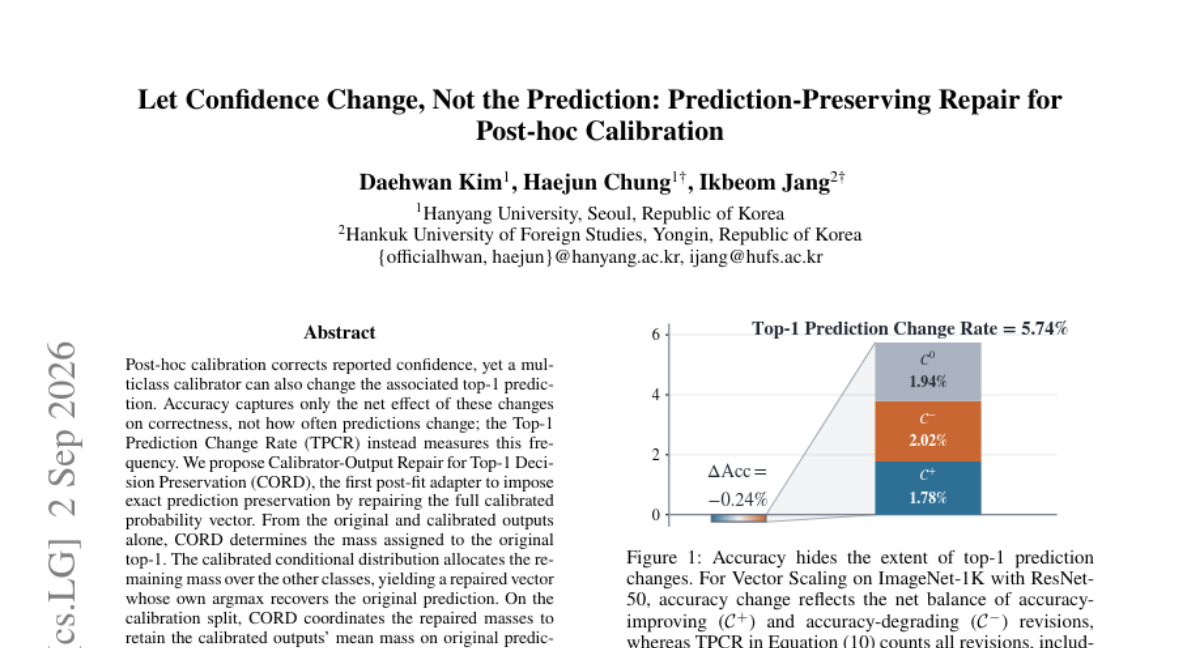
事后校准 (post-hoc calibration) 调整模型报告的置信度,但多分类校准器可能同时改变其 top-1 预测。准确率仅反映这些改变对正确性的净影响,而非预测改变的频率;Top-1 预测改变率 (TPCR) 用于度量该频率。本文提出 CORD (Calibrator-Output Repair for Top-1 Decision Preservation),一种首个 post-fit 适配器,通过修复完整校准概率向量实现精确的预测保持。 仅利用原始与校准输出,CORD 确定分配给原始 top-1 的质量,并让校准后的条件分布将剩余质量分配给其他类,从而得到修复后的向量,其 argmax 恢复原始预测。在校准集上,CORD 协调修复后的质量,以在可得时保留校准输出对原始预测的平均质量。该适配器既不改变拟合好的校准器及其直接输出,也不拟合额外监督映射,且无需用户或验证集调参。 在 CIFAR-10/100 与 ImageNet-1K 上,CORD 通过构造实现零 TPCR,并在所有数据集中相较于对应直接输出降低平均 ECE、NLL 与 Brier 分数;配对增益在分布偏移及不同校准集大小下依然保持。CORD 将保持性约束从校准器拟合中移除,并将原始决策的精确恢复交给后续输出修复。代码见 https://github.com/labhai/CORD。
论文精读
TL;DR 提出 CORD,首个后处理修复校准输出以精确保持 top-1 预测不变的方法,同时不牺牲校准质量,甚至降低 ECE/NLL/Brier,无需额外训练或调参。
问题
问题背景
Post-hoc calibration 是提升分类模型置信度可靠性的常用手段,在模型部署后无需重训即可校准输出概率。
现有方法局限
常见的多分类校准器(如 temperature scaling, vector scaling, Dirichlet calibration)在修正置信度的同时,会改变概率向量的 argmax,从而改变 top-1 预测。现有保持预测不变的方法主要有两类:
- 训练时约束:在拟合校准器时加入正则项惩罚预测变化,但会限制校准空间,降低 ECE/NLL 等指标表现,且常需人工调节惩罚系数。
- 事后修复:如只对原始 top-1 概率做单独缩放,虽可保持预测但缺乏对其他类别的联合校准,导致校准质量不足。 前者牺牲了校准精度,后者缺乏理论保证和统一框架,且多数方法需要额外的验证集或超参数调优。
为什么这个问题难/重要
预测变化在安全敏感场景(如医疗诊断、自动驾驶、金融风控)可能造成严重后果,因为校准后的模型即使置信度更准确,但若 top-1 label 改变,可能带来不可预期的决策错误。同时,模型的校准性能和决策保持之间往往存在张力:更灵活的校准器更可能改变预测,但限制预测变化又会降低校准效果。业界对模型部署后的稳定性和可预测性要求越来越高,因此亟需一种既能精确保持原始预测、又不牺牲校准质量的后处理方案。
行业类比
这类似于推荐系统中对排序模型输出的重排序:既要修正点击率预估值,又不能改变原始物品的排序结果,否则会直接影响用户体验和业务指标。
核心洞察
- **将预测保持从校准器拟合中解耦为后处理修复**,是 CORD 的核心设计。已有的预测保持校准方法通常在拟合校准器时引入 argmax 约束或联合优化,这会限制校准器容量或需要额外的超参数调优。CORD 则对任意已拟合校准器的输出进行后处理修复,不改动校准器本身,也不引入监督映射或用户调参,因此可以即插即用。工程上可将“校准质量”与“决策稳定性”作为两个独立模块迭代优化,允许灵活替换不同校准器(温度缩放、向量缩放、Dirichlet 等)而始终维持零 TPCR,同时不牺牲 ECE、NLL、Brier。这种解耦思路也为后续校准器设计和预测保持研究提供了更清晰的模块化视角。
- CORD 将修复问题压缩为**单一标量质量分配**,并由校准集上的均值匹配闭式确定,避免了逐样本迭代或在线优化。从原始和校准概率向量出发,修复向量只需保持原始 top-1 的质量,剩余质量按校准条件分布分配到其他类,即可保证 argmax 不变。作者证明修复族是一维的,并在校准集上通过均值匹配唯一确定共享标量,使其在分布内与分布外均能保持校准增益。这种设计的关键优势在于无需拟合额外神经网络或求解昂贵凸优化,推理开销极低,适合部署在实时决策系统中。相比需要温度网格搜索或验证集调参的方法,CORD 提供了一种闭式、无超参数、可证明的修复规则,具有较高的工程可靠性。
方法
输入与输出
CORD 是一个后拟合适配器,接收两个输入:
- 原始 softmax 概率向量
p(模型原始输出) - 校准器输出的概率向量
q(例如 Temperature Scaling、Vector Scaling 等后处理校准器的结果)
输出是一个修复后的概率向量 r,满足 argmax(r) = argmax(p),即 top-1 预测与原始模型完全一致。
关键模块与流程
确定原始 top-1 的目标质量
首先从q中提取原始预测类别对应的质量q_k(k = argmax(p))。这一步只依赖p和q两个向量,不需要训练数据。保留校准条件分布并重新分配剩余质量
将q中除k外的其余类别质量保持相对比例不变,把总剩余质量1 - q_k按该条件分布重新分配,得到初步修复向量。该向量的 top-1 会自动回到原始类别k,因为q_k被强制置为最大(通过后续共享标量调整保证)。校准集上的质量协调
为保证修复不破坏校准器在原始预测类别上的平均置信度,CORD 在校准分割上计算一个全局共享标量s,对所有样本的q_k进行统一缩放(若可行,则使修复后r_k在数据集上的均值等于校准器直接输出的q_k均值)。若无法完全达到,则采用最接近的可行解。无超参数、无额外训练
整个适配过程仅使用原始输出和校准输出,不拟合任何监督映射,也不需要用户或验证集调参。
与同类方法的差异
与在校准器训练阶段加入预测保持约束(如修改损失函数限制 top-1 变化)的方法不同,CORD 将预测保持完全解耦到事后修复阶段,对任意已拟合的校准器都能实现零 TPCR,并且不改变校准器自身参数。
实验
实验设计
- 在 CIFAR-10、CIFAR-100 和 ImageNet-1K 三个数据集上评估,覆盖不同规模和类别数。
- 使用多个 post-hoc 校准器(如温度缩放、向量缩放等,具体见论文)作为基线,比较其直接输出与经 CORD 修复后的输出。
- 评估指标包括 TPCR(Top-1 Prediction Change Rate)、ECE、NLL 和 Brier score。
- 额外测试分布偏移鲁棒性(CIFAR-C 腐蚀)和不同校准集大小下的敏感性。
关键发现
- CORD 通过构造保证 TPCR = 0,即完全保持原始 top-1 预测不变。
- 在所有数据集上,CORD 修复后的输出相比直接校准输出,ECE、NLL、Brier score 均下降,且这一优势在分布偏移和不同校准集大小下持续存在。
- CORD 无需修改已拟合的校准器,不增加额外监督映射,也不引入需用户调整的超参数。
与基线对比的深度解读
- 传统做法要么在拟合校准器时加入预测保持约束,要么接受预测改变;CORD 将这一约束后置到输出修复阶段,实现了校准与决策保持的解耦。
- 相较于直接输出,CORD 在提升校准质量的同时避免了预测翻转带来的潜在风险,对实际部署中的稳定性和可解释性有积极意义。
- 该方法轻量且通用,可作为现有校准管线的即插即用组件,大幅降低引入预测保持功能的工程复杂度。
行业影响
落地场景
CORD 适用于任何需要校准置信度但严格保持 top-1 决策的 AI 产品。典型如 医疗 AI 辅助诊断:模型给出疾病类别与置信度,校准后置信度更可靠,但若改变诊断类别可能造成严重临床差错——CORD 保证原始诊断不变,仅修正置信度。金融风控 中,信贷审批模型的决定不可因校准翻转,但风险概率需准确用于定价,CORD 能兼顾两者。
商业价值
降低高风险场景下校准引入的决策风险,避免因预测翻转导致的合规处罚、用户投诉或业务损失。同时保留校准带来的置信度可靠性提升,增强模型可解释性与用户信任。零 TPCR 特性使企业可放心部署后处理校准,无需担心预测稳定性的隐性成本。
与现有工作流的接口
CORD 作为轻量级后处理适配器,可直接插入现有推理流水线:在温度缩放、向量缩放等校准器输出后调用 repair_probabilities 函数,无需重新训练校准器或分类器,无额外超参数。代码开源:GitHub,适配主流框架,计算开销仅涉及概率向量重分配,适合实时推理场景。
局限
- **CORD** 依赖校准集上的经验统计量(原始预测上校准输出的平均质量)来确定修复后的 top-1 概率。当校准集规模较小或与部署分布存在明显偏差时,该均值的估计误差会被直接传导到修复后的概率向量,可能造成**校准性能下降**。论文虽然在 CIFAR-10/100 和 ImageNet-1K 上验证了对校准集大小的鲁棒性,但未覆盖极小校准集(如每个类别只含少数样本)或强分布偏移下的统计稳定性,工程落地时需额外谨慎评估。
- 方法仅保证 **top-1 预测不变**,对 **top-k 排序** 未施加任何约束。在实际系统中,检索、推荐、医疗辅助诊断等场景常依赖 top-k 候选或阈值决策,修复后的概率分布可能导致原本排名第二、三的类别顺序发生改变,影响下游逻辑。论文未讨论这一副作用,也未提供 top-k 预测保持的扩展方案,限制了其在多决策场景中的直接适用性。
- 与直接在训练阶段引入预测保持约束的校准器相比,**CORD** 采用后拟合修复策略,理论上是一种次优解。它不改变原校准器的参数,只是对输出进行坐标调整,因此无法纠正校准器内部已存在的对原始 top-1 概率的系统性低估或高估。若校准器本身在原始预测区域严重偏离真实置信度,CORD 只能按照全局均值重新分配质量,可能牺牲部分类别的条件校准精度。论文中的对比实验虽显示优势,但同类方法未经过针对预测保持的充分调优,结论的普适性仍需进一步验证。