Puppeteer: 物体锚定的姿态感知共语音手势生成
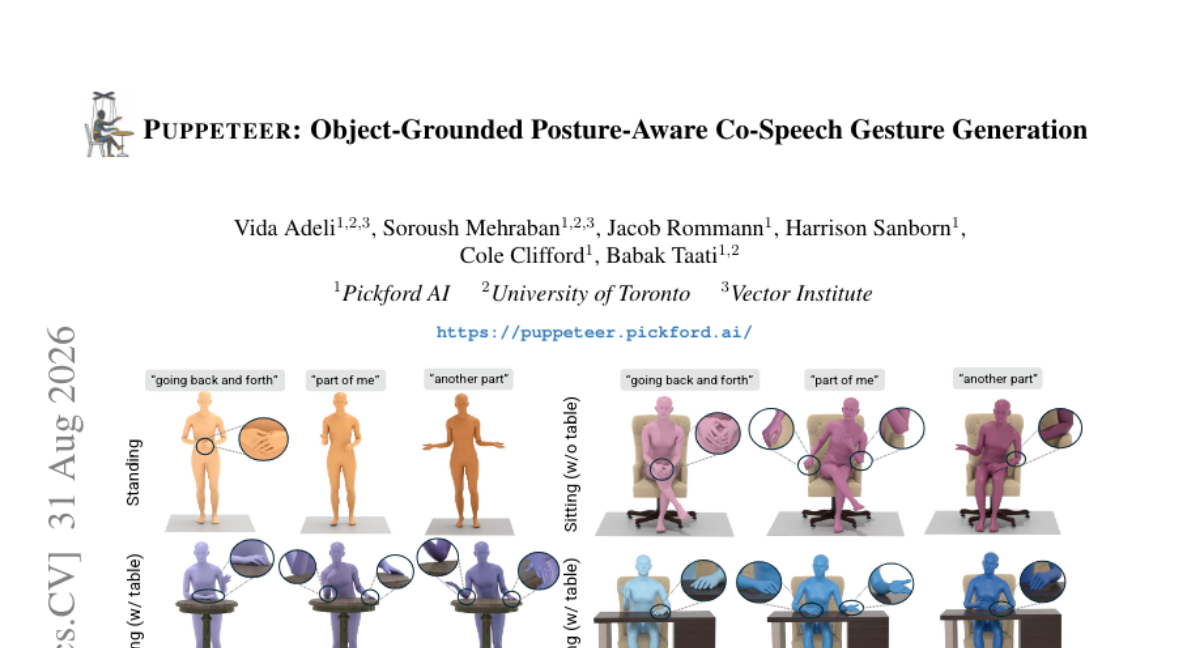
生成时序连贯、语义上与语音对齐、并与周围物体锚定的共语音手势仍具挑战。此前的语音驱动手势模型强调 audio-gesture 对齐,却未显式考虑姿态约束或周围物体,无法捕捉身体手势与物理空间之间的内在关联。 我们提出 Puppeteer,一个在因果潜空间中运行的姿态感知、物体锚定的共语音手势扩散模型。方法上,它将长手势分解为结构化基元 (primitives),并用因果变分自编码器 将其编码为按时间排序的 latent tokens,每个 token 仅依赖过去信息。随后直接在因果潜空间中执行条件扩散,以语音信号、运动历史、初始姿态参考以及物体几何为条件,合成物理一致的手势。这种按时间排序的潜表示支持显式时序控制,并可用于手势插帧 (gesture in-betweening) 与手势补全等任务。 为更好地评估共语音手势合成,我们提出了针对该任务的全新评测指标;同时构建了 SceneGes,这是首个经过精心整理的、包含具身共语音手势与对应 3D 物体的合成 3D 数据集,使物体锚定的手势生成成为可能。 实验表明,Puppeteer 生成的手势比既有方法更多样、时序更同步,并实现了物体锚定的手势合成。
论文精读
TL;DR Puppeteer 将 co-speech 手势编码为因果 latent tokens,在 latent 空间做条件扩散,显式结合起始 posture 与 3D object 几何,生成时间同步、语义一致且物理合理的手势,并支持 in-betweening 与 completion。
问题
问题背景
当前,语音驱动手势生成(co-speech gesture generation)在数字人、具身智能等场景中受到广泛关注,核心目标是生成与语音节奏、内容语义高度一致的手势序列。
现有方法局限
主流模型多基于扩散或自回归架构,优化重点是 audio-gesture 对齐,但普遍存在以下局限:
- 未显式建模 姿态约束(posture constraints),例如坐姿与站姿下手部可达空间不同,导致生成动作违反身体平衡或关节限位;
- 忽略 周围物体(surrounding objects)的几何占用,生成的手势在靠近桌面或手持物体时容易穿插、悬空或抓取姿态错误;
- 长序列生成缺乏 因果结构,难以直接支持 gesture in-betweening、gesture completion 等时序控制任务。
为什么这个问题难且重要
同时满足时间连贯、语义相关、姿态合理和物体交互,是一个多约束耦合的优化问题。手势本质上是全身关节在三维空间中的时序轨迹,既依赖语音内容,也依赖历史运动状态和场景几何。此外,现有数据集中很少有同步标注的 3D 物体与手势,评估指标也大多忽略物体交互下的物理合理性,这进一步阻碍了模型在真实人机交互和具身智能体中的部署。
行业类比
与自动驾驶中的 轨迹预测 必须考虑车辆动力学和道路障碍物几何类似,co-speech gesture 生成也需要将身体运动约束在可执行且不与物体冲突的流形上,才能实现物理可信的交互。
核心洞察
- Puppeteer 将手势序列编码为时间有序的因果隐 token,使扩散模型在低维潜空间内生成,支持显式时间控制。与直接在骨骼空间扩散或使用非因果序列模型的方法不同,因果性保证每个隐 token 仅依赖过去,避免未来信息泄漏,同时潜空间降低复杂度和维度,使扩散更稳定,并可支持手势内插与补全等任务。
- 模型显式利用物体几何和初始姿态参考,生成与物理环境一致的手势。以往语音驱动方法只关注音频-手势对齐,忽略身体与周围物体的空间关系,常导致手势穿透物体或不自然。Puppeteer 通过条件扩散输入物体几何,结合碰撞损失等约束,使生成手势既语义同步又避免与环境冲突,为具身交互场景提供关键能力。
- SceneGes 是首个包含 3D 物体与同步手势的合成数据集,填补对象感知手势生成的训练与评估空白。之前的 co-speech gesture 数据集缺乏物体标注,无法评估物体接地效果。SceneGes 提供多样化场景和手势,并配套新的评估指标,使对象感知手势模型的定量比较成为可能,推动该子领域从定性走向定量。
方法
输入与前置处理
Puppeteer 接收语音信号、初始姿态参考、运动历史与物体几何作为条件输入。长手势序列被分解为结构化手势原语(structured primitives),用于降低运动复杂度并保留语义单元。
关键模块与流程
Stage 1:Causal Latent Gesture Primitive Space
使用因果变分自编码器(Causal VAE)将手势原语编码为时间有序的潜在 token,每个 token 仅依赖过去帧,保证时序因果性。这种离散化与因果约束使后续扩散过程具备显式的时间控制能力。Stage 2:Autoregressive Gesture Diffusion
在因果潜在空间中执行条件扩散模型,以自回归方式逐步生成手势 token。条件信号包括语音特征、已生成的运动历史、初始姿态参考,确保生成结果与语音节奏对齐且保持身体姿态合理。扩散在低维潜在空间进行,减少计算开销并提升生成多样性。Stage 3:Object-Aware Gesture Generation
引入物体几何信息,通过碰撞损失(collision loss)惩罚手部与物体的穿透,使手势与周围物体产生物理一致的交互(如指向、抓取、避让)。该阶段使模型不仅关注语音-手势对齐,还显式建模身体与物理空间的关系。
输出与能力
生成的手势序列具有时间连贯性、语义对齐性和物体接地的物理合理性。得益于因果潜在 token 的时序结构,模型可支持手势中间帧生成(in-betweening)和手势补全(completion)等任务。
与同类方法的差异
与仅关注 audio-gesture alignment 的先前 speech-driven gesture 模型不同,Puppeteer 在因果潜在空间中同时引入姿态约束与物体几何,显式建模身体手势与物理空间的关联,从而生成更符合场景语义与物理规律的协同语音手势。
实验
实验设计
论文在新建的 SceneGes 数据集上系统评估 Puppeteer,该数据集包含具身 co-speech 手势与对应 3D 物体。实验设置包括:
- 定量评估:使用新提出的指标衡量手势多样性、时间同步性和物理一致性。
- 消融研究:分析因果 VAE 潜空间大小、无分类器引导尺度、采样步数、碰撞损失系数等影响。
- 定性评估:通过人类感知研究比较生成手势的自然度和对象关联性。
关键发现
- Puppeteer 生成的 co-speech 手势比先前方法更多样化且时间同步性更好。
- 模型支持 object-grounded 生成,手势与周围物体空间关系合理。
- 新设计的评估指标比现有指标更贴合任务特性(如显式度量姿态约束和物体接触)。
- 消融表明因果潜空间和初始姿势参考对生成质量有显著贡献。
与基线对比解读
摘要指出,先前语音驱动手势模型仅关注音频-手势对齐,忽略姿势约束和周围物体。Puppeteer 通过引入姿势参考和物体几何作为条件,在保持语义对齐的同时,提升了物理一致性。与仅使用音频的扩散模型相比,Puppeteer 的因果潜空间 token 序列提供了更明确的时间控制能力,支持手势插值和补全,这在实际交互系统中尤为重要。
行业影响
落地场景
Puppeteer 解决语音驱动手势缺失物体交互与物理约束的痛点,可直接嵌入虚拟人 / 数字人产品。典型场景:
- 电商虚拟主播:讲解商品时手势可自然指向、拿起或展示商品,提升购物真实感。
- 教育虚拟教师:讲解实验时手势与教具(烧杯、仪器)协同,增强教学演示效果。
- 游戏 NPC / 虚拟客服:说话时与场景物体交互(拿起物品、指向地图),提高沉浸感。
商业价值
- 降本:传统手 K 动画成本高且难扩展,Puppeteer 批量生成多样化、物理一致手势,减少人工修帧。
- 体验提升与增收:手势与物体协同提升虚拟人可信度,延长用户停留,提升直播转化或课程完课率。
- 实时交互:因果潜在空间支持自回归采样,适合流式对话场景,避免全局推理延迟。
与现有工作流接口
Puppeteer 基于扩散模型,输出为骨骼动画或潜在 token,可对接主流渲染引擎与虚拟人管线:
- 输入侧:接入 ASR / TTS 的音频特征、初始姿态、场景物体几何(OBJ / URDF)。
- 输出侧:生成 SMPL-X 或标准骨骼序列,重定向导入 Unity / Unreal / Omniverse。
- 管线兼容:与面部动画(如 Audio2Face)配合补全身体手势,封装为微服务通过 REST / gRPC 调用。
局限
- **SceneGes 数据集为合成数据**,虽然通过程序化生成并经过人类感知研究验证,但与真实世界录制的 co-speech gesture 数据相比,在运动多样性、物体交互细节和场景复杂度上仍可能存在差距。模型在合成数据上训练后,迁移到真实场景时可能面临域偏移,且数据规模可能不足以覆盖所有手势与物体组合。
- **两阶段框架带来计算开销**:Puppeteer 先训练因果 VAE 进行手势压缩,再在潜在空间执行扩散采样;扩散模型本身需要多步去噪,加上对象几何处理和因果掩码,推理速度可能较慢。论文未报告延迟或资源消耗,实时交互应用(如虚拟角色驱动)的可行性尚不明确。
- **评估指标与泛化能力有限**:作者提出的 FGD 和手势多样性等新指标尚未经过广泛验证,其与人类真实感受的相关性需更多实验支持。虽然论文展示了 held-out split 上的泛化,但真实世界物体的形状、语义和遮挡情况远超合成场景,模型对复杂未见物体的处理能力仍有待检验。