FoldingAgent: 从演示视频推断参数化折纸程序
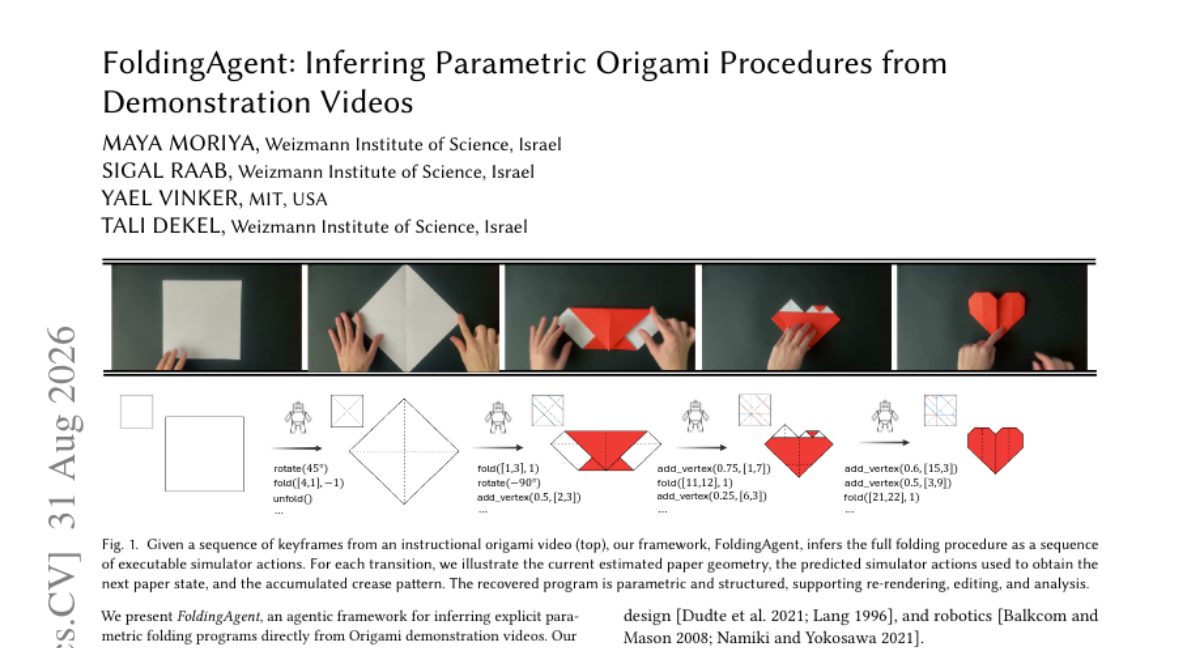
折纸演示视频通常以非结构化视觉形式呈现,难以被计算方法直接利用,且多步折叠过程容易出现误差累积。现有方法多预测静态折痕模式,无法显式建模折叠动态。为此,我们提出 FoldingAgent 智能体框架,直接从演示视频推断参数化折纸程序。 该框架基于预训练 视觉语言模型 (VLM),搭配一组专用工具,使智能体能够模拟几何变化、验证物理可行性、检索并比较视觉内容,以及评估自身预测。为将视觉内容转化为程序,我们定义了由纸张几何和参数化折叠动作构成的参数化空间。与静态模型不同,我们的智能体顺序决策并具备重规划能力,有效缓解多步折叠中的误差传播。 实验在新建的 PurelandFold 基准上进行,其中包含多种纯土地折纸视频及真值几何和动作标签。结果表明,结合 VLM 推理、专用工具和物理模拟,可成功将非结构化视觉演示转换为可执行且物理合理的折叠程序,缩小了人类折纸知识与计算建模之间的差距。
论文精读
TL;DR FoldingAgent 用 VLM 结合工具将折纸演示视频转为可执行参数化折叠程序,通过顺序推理与物理验证缓解多步累计误差,无需显式标注 crease pattern。
问题
问题背景
计算折纸领域正从静态 crease pattern 重建转向从演示视频推断可执行参数化折叠程序,以支持编辑、动画与仿真。
现有方法局限
- 几何计算 方法依赖已知 crease pattern 或人工标注,无法直接从视频工作。
- 视觉重建 方法仅输出静态折痕图,不提供逐步折叠动作,难以处理多步折叠中的误差累积。
- 直接使用 VLM 预测动作序列时,模型对几何推理不精确,缺乏物理验证,长序列预测漂移大,且无法自我修正。
为什么这个问题难/重要
- 多步推理:折叠一步错则后续全错,需要顺序决策与重规划能力。
- 物理可行性:预测的折叠动作必须满足纸张不可穿透、平面反射等约束。
- 表示鸿沟:人类知识通过非结构化视频传递,而计算工具要求结构化参数表示。
- 业界关注从视频中学习程序合成,例如从演示中提取可执行操作序列,对机器人操作与自动化有直接价值。
行业类比
类似从 cooking 视频提取可执行菜谱,需要将视觉指令转化为带有物理验证的步骤序列。
核心洞察
- 将“从视频推断折叠”从单步回归问题重新定义为顺序决策过程,使 VLM 在每一步都具备观察、模拟与纠错能力。与直接预测静态折痕图案或一次生成完整折叠序列的方法不同,FoldingAgent 通过控制器逐步调用工具模拟几何变换并验证物理合理性,一旦发现偏差可重新规划,显著缓解多步折叠中的误差累积。每个中间状态都经过物理仿真与视觉核对,而不是盲目外推。这种“决策-执行-验证”闭环可迁移到其他需要从视频推断可执行程序的场景。
- 定义了专门的参数化折纸动作空间和状态表示,作为 VLM 与物理世界之间的可编程接口。该工作不直接让 VLM 输出像素级折痕或关键点,而是输出一组离散与连续参数定义的折叠动作,如 fold line、fold angle、moving set,这些动作输入到模拟器中产生可验证的几何状态。这种抽象将非结构化的视觉理解转化为结构化的可执行程序,与以往视觉重建方法产生网格或点云有本质区别。参数化表示还允许后续编辑、重渲染和分析,为逆向视觉任务提供了更实用的中间表示。
- 通过组合工具库(模拟、物理验证、视觉检索、自我评估)弥补纯 VLM 在物理推理和长期一致性上的不足。单独使用预训练 VLM 在长视频理解中容易产生幻觉或丢失细节。FoldingAgent 将物理约束交给模拟器、视觉比对交给检索工具、质量评估交给 Critic,VLM 主要负责高层决策与规划。这种模块化设计不仅提高了推断准确率,还使得系统行为可解释、可调试。消融实验表明移除任何工具都会导致性能下降,证明工具协同是成功关键,对构建可靠的多模态 Agent 具有参考价值。
方法
输入与状态表示
FoldingAgent 的输入是折纸演示视频的关键帧序列。它定义参数化状态空间,包括纸张几何(顶点位置、面片划分)和一组参数化折叠动作(如沿指定折线翻转面片)。每个状态记录当前几何与累积折痕图案。
Agentic 框架
核心是预训练 VLM 作为控制器,通过调用工具库完成任务:
- 模拟器工具:执行折叠动作,生成下一状态,验证物理合理性(如无自交、面片不穿透)。
- 视觉检索与比较工具:从关键帧中提取视觉证据,与当前模拟状态对比。
- 视觉批评者:评估预测与观测帧的一致性,给出反馈。
- 重建循环:控制器根据批评者反馈重新规划动作,修正预测。
- 有界探索:限制搜索步数,平衡效率与准确性。
该设计对工程实现的启示在于:通过模块化工具与显式物理验证,可将 VLM 的开放域推理约束到可行动作空间,减少错误累积。
输出
最终输出为一系列可执行模拟器动作序列,对应参数化折叠程序,支持重渲染、编辑与分析。
与预测静态 crease pattern 的方法不同,FoldingAgent 顺序推理并动态重规划,显式降低多步折叠中的复合误差。
实验
实验设计
- 构建 PurelandFold 数据集:包含多样 Pureland 折纸视频,提供 ground-truth 几何与动作标签。
- 评估框架:从视频关键帧出发,逐帧推断参数化折叠程序,并与 ground-truth 几何/动作对比。
- 设置多种指标(几何误差、动作序列匹配等),并进行消融研究(如工具、critic、retrieval 的作用)。
关键发现
- VLM + 专用工具的组合能够将非结构化视觉演示转化为可执行的、物理合理的折叠程序。
- 顺序推理与重规划机制有效抑制多步折叠中的累积误差。
- 视觉 critic 和物理模拟验证对保证几何一致性与物理可行性至关重要。
- 跨模态检索帮助定位相似视状态,辅助 agent 决策。
与基线对比深度解读
- 与静态 crease pattern 预测模型相比,FoldingAgent 输出参数化、可编辑的程序,支持重渲染与分析。
- 顺序执行能力使其对长序列任务更鲁棒,避免一次性预测带来的误差传播。
- 消融研究表明,缺少工具或 critic 会导致几何偏差增大,验证了模块设计的必要性。
行业影响
落地场景
- 电商 / 零售 AR 说明书:将产品包装折叠演示视频自动转换为可编辑参数化步骤,用于 AR 交互式开箱与组装引导,减少客服咨询与退货率。
- 教育 / 内容平台:上传折纸教学视频即可生成可交互、可重渲染的分步程序,支持用户调整视角、速度或生成个性化变体,提升学习体验。
- 机器人操作数据生成:为机械臂折叠 / 包装任务自动生成 ground-truth 动作序列与几何状态,加速仿真数据采集与策略训练。
商业价值
- 降本:省去人工标注 crease pattern 与动作参数,VLM agent + 物理模拟器自动验证能减少返工与错误传播。
- 增收 / 体验提升:交互式教程提高用户留存与付费转化;可编程资产支持二次创作、授权与跨平台复用。
与现有产品 / 工作流的接口
- 可封装为 VLM tool-use pipeline,通过函数调用接入现有 LangChain / AutoGen 等 agent 框架;输出使用
FOLD格式的 parametric program,兼容 Origami Simulator 等现有工具。 - 作为内容理解微服务部署在视频平台后端,与现有 CV 关键帧抽取、目标跟踪模块串联;物理验证模块可独立调用
taichi_elements / MuJoCo等仿真器,不侵入主推理链路。
局限
- **泛化边界**:方法在 **PurelandFold** 基准上验证,该基准仅包含 Pureland 折纸(一种限制折叠角为 90° 倍数的简化类型),与更广泛的折纸形式(如复杂折叠、曲面折叠、多层同步操作)存在差距。论文结论中可能承认此范围限制,因而在真实自由形式折纸视频上的泛化性尚未得到检验。此外实验设定可能依赖较干净的演示环境,对手部遮挡、动态光照、视角变化等真实教学视频因素鲁棒性存疑。
- **模拟器与物理假设**:系统依赖 **几何模拟器** 验证物理可行性,但该模拟器假设理想平面纸张、零厚度、单步刚性折叠,无法处理纸张厚度、弯曲、褶皱或折叠过程中的非刚性形变。在真实视频中,这些因素普遍存在,可能导致模拟状态与观测视频不一致,进而影响 VLM 的视觉对比和批评反馈。一旦模拟器错误拒绝合理动作或接受不可能动作,错误会沿顺序推理累积,即使有重新规划机制也可能无法完全恢复。
- **计算成本与可扩展性**:Agent 框架涉及多轮 VLM 调用、模拟、检索和批评循环,文中实现细节提到 token 预算、运行时间和 thinking-token exhaustion,表明单条视频推理可能消耗大量计算资源与时间。对比直接回归静态 crease pattern 或端到端模型,该方法的吞吐量较低,难以扩展到大规模视频数据集或实时交互场景。且对 VLM 基础模型的能力有较强依赖,更换后端可能显著影响性能。