Qwen3.8-Next 架构设计:评估、效率与训练稳定性
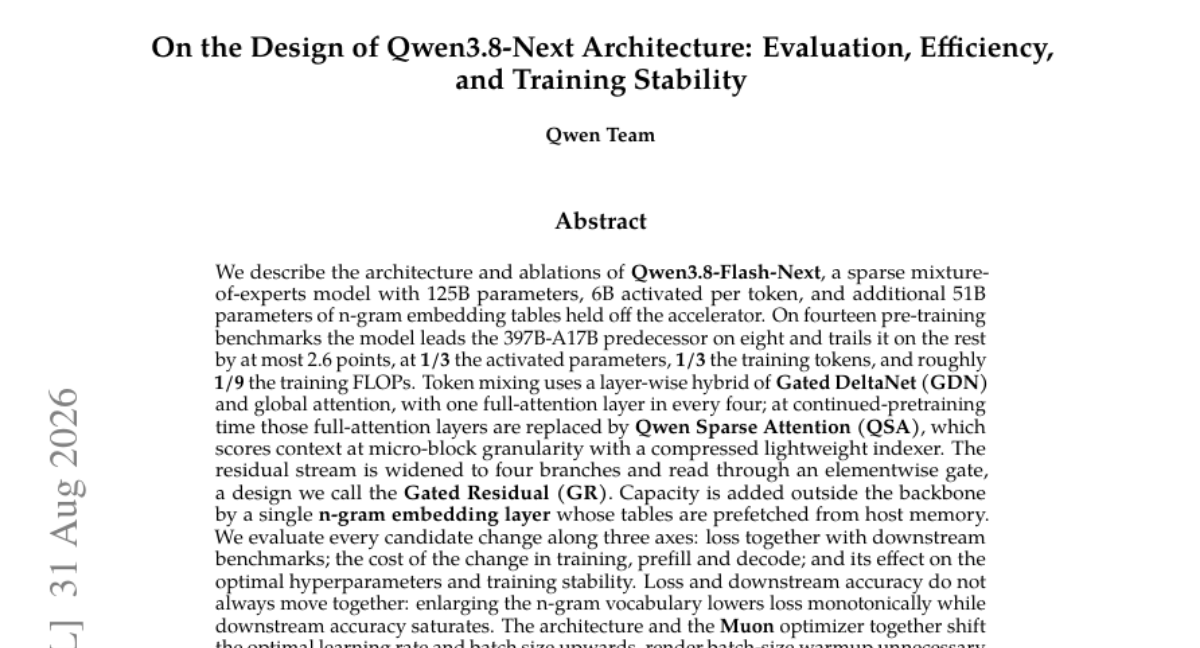
我们描述了 Qwen3.8-Flash-Next 的架构与消融实验。该模型是一个稀疏混合专家模型,拥有 125B 参数,每个 token 激活 6B 参数,并额外配有 51B 参数的 n-gram 嵌入表(不驻留在加速器上)。在十四个预训练基准上,该模型在八个基准上超越了前代 397B-A17B 模型,其余基准上差距最多为 2.6 分,同时激活参数减少至 1/3、训练 token 减少至 1/3、训练 FLOPs 约减少至 1/9。 Token 混合采用逐层混合的 Gated DeltaNet (GDN) 与全局注意力,每四层中有一层为全注意力层;在继续预训练阶段,这些全注意力层被替换为 Qwen Sparse Attention (QSA),后者以微块粒度结合压缩轻量索引器对上下文进行打分。残差流拓宽为四个分支,并通过逐元素门控读取,这一设计称为门控残差 (Gated Residual)。额外容量通过单个 n-gram 嵌入层在主干之外添加,其表从主机内存预取。 我们沿三个维度评估每个候选改动:损失与下游基准;改动在训练、预填充和解码阶段的开销;以及对最优超参数和训练稳定性的影响。损失与下游准确率并不总是同步变化:扩大 n-gram 词汇表会持续降低损失,但下游准确率会饱和。架构与 Muon 优化器 共同将最优学习率和批量大小上移,使批量大小预热变得不必要,并显著提升了压力测试下的稳定性。 损失、基准、效率与稳定性构成一个统一的设计问题。通过联合求解,我们得到了一份同时更高效、更强能力且更稳定的方案。
论文精读
TL;DR Qwen3.8-Flash-Next 稀疏 MoE 架构融合 Gated DeltaNet、QSA 稀疏注意力和门控残差,以 1/3 激活参数、1/9 训练 FLOPs 达到 397B 模型性能,并显著提升训练稳定性。
问题
问题背景
大规模稀疏混合专家(MoE)模型在扩展参数规模的同时追求激活计算效率,但长上下文建模与训练稳定性成为新的瓶颈。
现有方法局限
- 全注意力
O(n^2)复杂度在长序列预填充和解码时成本过高,难以支撑超长上下文。 - 纯线性注意力(如 Gated DeltaNet)虽提升效率,但单层循环记忆容量有限,在精确 token 检索任务上可能退化。
- 稀疏 MoE 的路由辅助损失与专家负载均衡敏感,超参选择不当容易导致训练初期不稳定。
- 将参数表(如 n-gram 嵌入)卸载到主机内存,受限于 PCIe 带宽,成为推理延迟瓶颈。
- 传统 Adam 优化器在大规模训练中通常需要批量大小 warmup,学习率范围窄,且对架构改变适应差。
为什么这个问题难且重要
架构、优化器与稳定性相互耦合:改变残差连接或混合层数会移动最优学习率与批量大小,甚至使 warmup 变得不必要。同时,损失值 与下游基准并不总是同步——扩大 n-gram 词汇量可单调降低 loss,但下游精度却饱和,单一指标会误导设计决策。在训练 FLOPs 压缩到 1/9 的条件下保持性能,要求每个模块都具备高性价比,而大规模消融实验成本高昂,无法穷举搜索。
行业类比
类似在端侧部署大模型时,将稀疏激活、线性注意力与外部存储协同设计,在功耗、延迟与精度之间寻求平衡——本工作证明系统级联合优化优于单点突破。
核心洞察
- 联合设计架构、优化器与超参数是核心。将损失、下游基准、训练/推理成本和训练稳定性放在同一框架下共同优化,而不是分别调优。这一做法与常见“先定架构再调优化器”的流程不同,揭示了架构改动(如 Gated Residual、Muon 优化器)会系统性改变最优学习率、批量大小,甚至让 batch-size warmup 变得多余,并显著提升压力测试稳定性。这意味着在资源受限时,设计空间需要整体搜索,避免局部最优。
- 混合 token mixing 与可替换稀疏注意力实现激活参数和 FLOPs 大幅下降。采用每四层一个全注意力,其余为 Gated DeltaNet 的层级混合,并在持续预训练时用微块粒度的 Qwen Sparse Attention 替换全注意力,配合压缩轻量索引器,在保持上下文建模能力的同时降低计算。这与纯线性注意力或全稀疏注意力的方案不同,其可替换性允许训练和推理阶段采用不同注意力实现,进一步优化效率。同时,将 51B n-gram embedding 表外置到主机内存,增大知识容量但不增加激活参数,发现 loss 持续下降而下游指标饱和,提示需要多维评估。
方法
输入 token 序列先经词嵌入与 n-gram embedding 表(表驻留主机内存,按需预取)得到初始表示。主干为 125B 稀疏 MoE,每 token 激活约 6B 参数。
关键模块:
- 混合 token mixing:每 4 层中 1 层为全局注意力,其余层用 Gated DeltaNet(GDN)线性时间序列混合;继续预训练时全局注意力替换为 Qwen Sparse Attention(QSA),在 micro-block 粒度打分并借助压缩轻量 indexer。
- Gated Residual:残差流加宽为 4 条分支,经逐元素门控读取,提升多路信息路由能力。
- 稀疏专家层:MoE 增加总容量但保持低激活,降低推理成本。
- n-gram embedding 层:在骨干网络外提供额外记忆容量,扩大词汇表可单调降低 loss 但下游精度会饱和。
优化方面采用 Muon 优化器,并联合调整学习率与 batch size,取消 batch-size warmup,增强训练稳定性。输出为下一 token 概率分布。
与标准 dense Transformer 或常规稀疏 MoE 的差异在于:同时引入线性注意力与稀疏注意力的层级混合、门控多分支残差、以及离加速器 n-gram 记忆,并将效率、效果与稳定性作为联合设计目标,而非孤立调优。
实验
实验设计
- 在 14 个预训练基准 上对比 Qwen3.8-Flash-Next(125B 总参、6B 激活 + 51B n-gram off-accelerator)与 predecessor 397B-A17B。
- 所有候选改动按三轴评估:loss 与下游 benchmark、训练/prefill/decode 成本、最优超参数与训练稳定性。
- 消融覆盖 GDN 混合、Gated Residual、n-gram vocab size、Muon optimizer 等。
关键发现
- 新模型在 8/14 基准领先,其余最大落后 2.6 points,而激活参数、训练 tokens、训练 FLOPs 分别降至 1/3、1/3、约 1/9。
- 损失与下游 accuracy 并非同向变化:扩大 n-gram 词汇单调降低 loss,但下游准确率饱和。
- Muon optimizer 使最优 LR 与 batch size 上移,batch-size warmup 不再必要,压力测试下稳定性大幅提升。
原文:Loss, benchmarks, efficiency and stability form one design problem. Solved jointly, they yield a recipe that is simultaneously more efficient, more capable and more stable.
对比与解读
- 相对 397B-A17B,该设计用更少激活参数与 FLOPs 在多数基准打平或领先,验证稀疏 MoE + 混合 token mixing 的效率收益。
- 仍有少数基准落后 ≤2.6 分,说明并非全面优势;QSA 在 continued-pretraining 阶段替换 full attention 的效果需下游验证。
- 损失与下游不一致提示:架构搜索不能只看 training loss,要将下游 benchmark 作为联合优化目标。
行业影响
落地场景
Qwen3.8-Flash-Next 的稀疏 MoE 设计(125B 总参数 / 6B 激活)适合高吞吐、低延迟的生成式 AI 服务。典型产品包括:
- 实时对话与助理:客服机器人、语音助手等场景中,6B 激活参数可显著降低单次推理成本,同时保持接近大模型的回答质量。
- 内容平台生成与审核:电商平台的商品描述生成、评论摘要、违规检测;内容平台的标题建议、自动打标签等,均可受益于低 FLOPs 和较高基准分数。
- 企业文档处理:合同解析、报告生成等需要长上下文理解的场景,混合 Gated DeltaNet 与 QSA 的注意力机制在长序列上有潜在效率优势。
商业价值
主要降本路径明确:
- 推理成本下降:激活参数仅 6B(前代 17B 的约 1/3),且 n-gram 嵌入表卸载到主机内存,减少加速器 HBM 占用,降低单 token 成本。
- 训练效率提升:训练 FLOPs 仅为前代约 1/9,配合 Muon 优化器 和无需 batch-size warmup 的稳定性,可缩短迭代周期,节省算力投入。
- 体验提升:在 14 个预训练基准上 8 项领先,其余差距 ≤2.6 分,表明性能没有明显折损,反而可能在某些任务上更好。
跟现有产品/工作流的接口
集成挑战主要在 serving 层:
- 推理框架适配:需要支持稀疏 MoE 的专家并行、混合注意力(GDN/QSA)的定制 kernel,以及主机内存预取 n-gram 表的异步 I/O。
- 与现有 LLM stack 兼容:可作为 API 后端的可选模型,替换部分高成本大模型;对 vLLM、TensorRT-LLM 等框架需要插件化扩展。
- 训练侧:若继续预训练或微调,需适配 Muon 优化器和相应超参数;但稳定性提升可减少人工调参。
关键启示:损失与下游精度不一定同步,工业部署时应同时监控 benchmark 和实际业务指标,而不仅看训练 loss。
局限
- **n-gram embedding 的容量扩展存在边际收益递减。** 论文明确指出:增大 n-gram 词汇表可以单调降低训练 loss,但下游基准准确率出现饱和。这意味着额外 51B 参数(占总参数近 30%)并未带来成比例的能力提升,且这部分参数存储在 host memory 中,推理时需预取,可能受限于主机内存带宽。在高并发或长序列场景下,预取延迟可能成为新的瓶颈,实际部署的吞吐收益需要进一步验证。
- **混合 token mixing 机制增加推理工程复杂度。** 模型在层间混合 Gated DeltaNet、全局注意力与 Qwen Sparse Attention,继续预训练后注意力层被 QSA 替换。这要求推理框架同时支持两种模式,且在切换时保持权重兼容。QSA 的压缩轻量索引器虽然降低了注意力计算量,但引入额外的索引构建与查询开销。此外,Gated Residual 将残差流加宽到四分支,虽然通过门控减少了信息冗余,但激活内存占用可能高于标准 Transformer,对显存受限的部署环境不够友好。
- **与同类稀疏 MoE 工作相比,总参数量偏高且基准覆盖有限。** 模型总参数 176B(含 n-gram 表),激活 6B,虽然激活参数仅为主流大模型的 1/3 左右,但总存储需求仍较大,可能限制边缘设备部署。论文在 14 个预训练基准上评估,但缺少长上下文推理、多轮对话或代码生成等任务的大规模对比,难以全面反映真实应用中的能力边界。此外,训练稳定性实验主要基于压力测试,生产训练中的长期稳定性仍需观察。